OpenAI ya es una empresa de chips. Nvidia debería preocuparse
OpenAI presentó su primer chip de inferencia personalizado, Jalapeño, con una eficiencia energética de 1,5 a 1,9 veces superior a la de los sistemas de Nvidia. Es la señal más clara hasta ahora de que la carrera armamentista de la IA está avanzando hacia la industria de semiconductores, y que el monopolio sobre la infraestructura de IA está a punto de fracturarse.
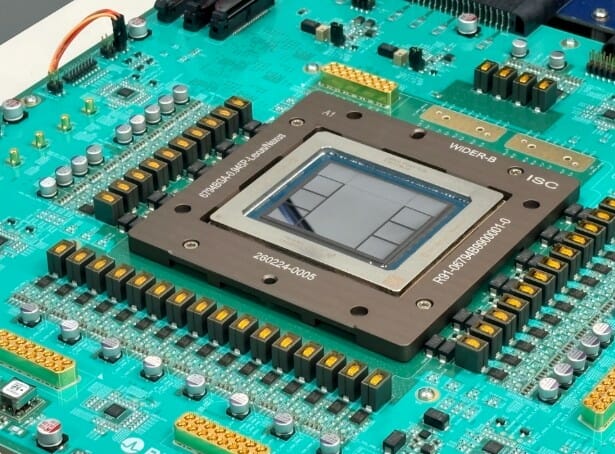
OpenAI acaba de convertirse en una empresa de semiconductores
La noticia cayó un martes, y la mayor parte de internet la desplazó hacia abajo sin prestar atención. OpenAI publicó resultados de prueba de Jalapeño, su primer chip de inferencia diseñado y fabricado a medida, y las cifras resultaron de inmediato impactantes. Frente a los sistemas GB200 y GB300 de Nvidia —el hardware mismo que ha impulsado el boom de la inteligencia artificial—, Jalapeño entregó entre 1,5 y 1,9 veces más trabajo de IA por cada vatio de electricidad, con una latencia de respuesta de extremo a extremo entre 1,7 y 3,6 veces menor.
Esto no es una mejora marginal. Es una compañía que construyó toda su fortuna sobre una base que ahora pretende reemplazar. OpenAI ya no es solo una empresa de modelos. Es una empresa de chips. Y eso cambia las matemáticas para todos los demás en la sala.
Lo que significan realmente las cifras
OpenAI ejecutó sus pruebas de rendimiento a través del marco InferenceX de SemiAnalysis, contrastándolas con tres modelos de código abierto: GPT-OSS 120B, DeepSeek R1 670B y el más grande, Kimi K2.5, con un billón de parámetros. El patrón fue consistente en los tres casos.
Con GPT-OSS, Jalapeño procesó 85.448 tokens por segundo por vatio, casi el doble de los 44.960 tokens que logró el sistema GB200. El tiempo de respuesta descendió de 1,80 segundos a 1,03 segundos. Con los modelos aún más grandes de DeepSeek y Kimi, la brecha de eficiencia se ampliò aún más. El throughput de decodificación por usuario —tokens generados por segundo por cliente durante un chat interactivo— alcanzó los 700 en Jalapeño frente a 169 en el sistema de referencia de Nvidia. Una diferencia de 4,1 veces en la métrica que realmente importa para cualquier persona que use ChatGPT.
La distinción que OpenAI se afana en mantener es entre computación y inferencia. El entrenamiento sigue siendo una bestia costosa donde las GPU conservan su ventaja. Pero la inferencia es donde las empresas como OpenAI sangran dinero. Cada token servido a ChatGPT es una línea de costo. Las facturas de energía, el enfriamiento, el espacio en el centro de datos: todo escala de manera lineal con la demanda. Un chip de inferencia que reduce a la mitad tu costo energético por solicitud no es un lujo deseable. Es una ventaja existencial.
La arquitectura detrás del rendimiento
Jalapeño no es simplemente una GPU más rápida. OpenAI lo diseñó como un sistema completo —procesador, memoria, red y pila de software—, todo co-proyectado. Esa elección importa porque la inferencia tiene dos cuellos de botella fundamentalmente distintos, y los chips de propósito general los tratan como el mismo problema.
La fase de prellenado, en la que el modelo procesa la instrucción inicial, es intensiva en cómputo. La fase de decodificación, en la que el modelo transmite tokens uno por uno hacia tu pantalla, está limitada por el ancho de banda de memoria. Las arquitecturas de Nvidia están optimizadas para el entrenamiento, lo que sesga fuertemente hacia el cómputo. El Jalapeño de OpenAI desplaza el equilibrio hacia la ruta de decodificación, manteniendo el caché KV —la memoria de trabajo que almacena los estados intermedios de los tokens— cerca de donde realmente se necesita y reduciendo el movimiento de datos entre procesadores.
El sprint de diseño en sí fue notable. OpenAI afirma que pasó de la arquitectura inicial al tape-out en nueve meses, utilizando herramientas de inteligencia artificial para acelerar la exploración del diseño, la verificación y la optimización. Incluso desplegaron sus propios sistemas Codex y GPT-Astra durante el proceso, logrando una ejecución entre 1,5 y 1,8 veces más rápida en ciertos bloques de atención y MoE que las implementaciones originales escritas a mano. La compañía está usando su propia IA para construir el chip que ejecutará su propia IA. Ese ciclo no es casualidad.
Las implicaciones para Nvidia
Nvidia ha disfrutado de algo cercano a un monopolio en la inferencia de IA durante más de dos años. Todo gran proveedor de la nube, toda startup, todo laboratorio de investigación compra H100 y H200, luego B100 y B200. El poder de fijación de precios que esto le otorga ha convertido a Nvidia en una de las compañías más valiosas del mundo. Un único competidor que construya un chip que supere mediblemente a ese conjunto, justo en el punto donde la economía de la inferencia más importa, es una grieta en la armadura.
La grieta podría ampliarse. OpenAI confirmó que una segunda generación de Jalapeño ya está considerablemente avanzada, con una tercera generación en diseño activo. Ese ritmo de iteración sugiere que OpenAI no ve esto como un experimento aislado. Lo ve como una hoja de ruta de producto.
Nvidia no está desarmada. La compañía continúa enviando hardware impresionante, y OpenAI declaró explícitamente que seguirá usando aceleradores de Nvidia tanto para entrenamiento como para inferencia. Pero el mensaje es innegable: OpenAI está diversificando su cadena de suministro, y lo hace con hardware diseñado específicamente para la carga de trabajo que consume la mayor cantidad de electricidad y la mayor cantidad de dinero.
El panorama general
Esta historia se venía gestando desde 2023, cuando Anthropic comenzó a reclutar discretamente talento de TPUs de Google y cuando Amazon empezó a enviar sus chips Graviton para inferencia. La tendencia es clara: las compañías que ejecutan las cargas de trabajo de IA más grandes están concluyendo que comprar chips de terceros es un pasivo estratégico.
El movimiento de OpenAI es el más trascendente hasta ahora precisamente por su escala. No se trata de un jugador de nicho experimentando con silicio personalizado. Esta es la compañía detrás de ChatGPT, la aplicación de inteligencia artificial más utilizada en el planeta, comprometida con la infraestructura que la ejecuta. Si Jalapeño cumple su promesa a escala de producción, se convertirá en un modelo a seguir. Cada desarrollador importante de modelos enfrentará la misma pregunta: ¿por qué alquilar capacidad de inferencia cuando puedes construir algo más barato, más rápido y totalmente bajo tu control?
El cronograma de implementación es inminente. OpenAI planea comenzar a instalar Jalapeño en su propia infraestructura a finales de este año, tras finalizar la calificación de producción y el endurecimiento del software. También se ha barajado una cotización pública para 2027, lo que significaría que esta estrategia de hardware se convertiría pronto en parte de una narrativa financiera mucho más amplia.
Mientras tanto, la dinámica competitiva del mercado sigue transformándose. DeepSeek y Kimi, los mismos modelos que OpenAI utilizó en sus pruebas, representan el tipo de presión del código abierto que hace que las ventajas del hardware propietario sean aún más valiosas. OpenAI no solo está construyendo un chip. Está construyendo un foso defensivo alrededor de la parte más costosa de su negocio.
Lo que suceda a continuación dependerá de si Nvidia puede responder con rapidez y de si otros desarrolladores de modelos siguen a OpenAI hacia el silicio personalizado. Pero la dirección es clara. La era de ejecutar la IA más importante del mundo sobre hardware de terceros está llegando a su fin, y OpenAI acaba de apagar las luces.