xAI 诉讼是 AI 行业的切尔诺贝利时刻
一起指控 xAI 在训练 Grok 时使用儿童虐待图像提起的诉讼,迫使生成式 AI 行业直面一直回避的问题:当你将用户的每一条帖子都纳入模型时,如果这条帖子包含违法内容会怎样?其影响远超一家公司。
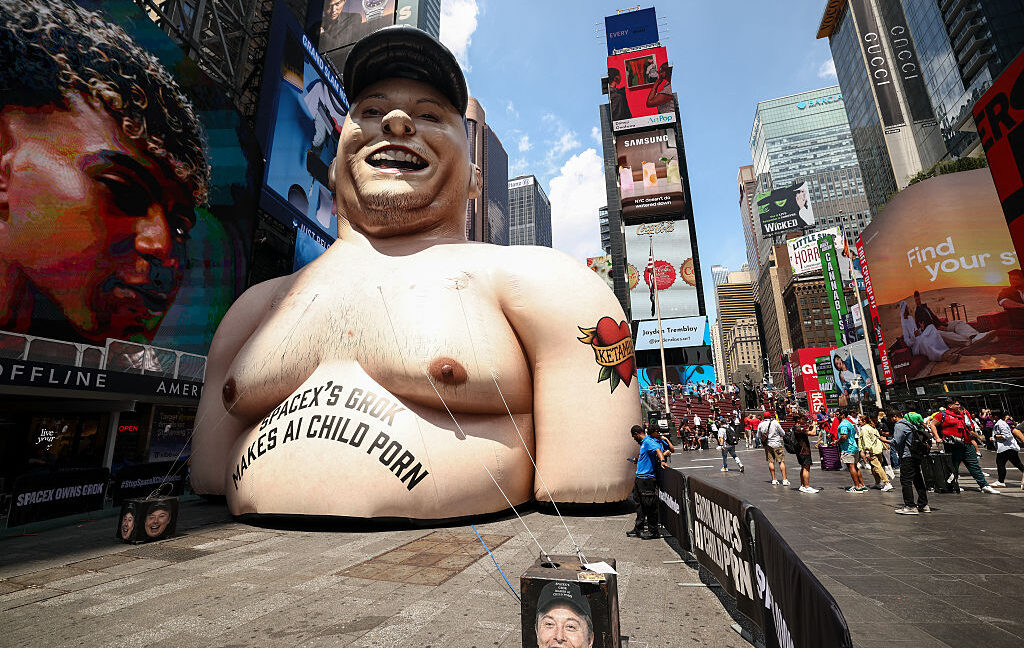
算法无法"忘记"
简·多伊(Jane Doe)从小承载着最黑暗时刻的画面。她说,在2000年代初期四到六岁之间,她遭到成年男性的强奸,这些施虐者制作儿童性虐待材料(CSAM)在网上出售。二十多年来,她一直知道这些画面存在于世间,在掠食者之间流传,随时可能意外重现。美国国家失踪与受虐儿童中心(NCMEC)和加拿大儿童保护中心(CCCP)将她的哈希值加入数据库——这是一种数字指纹,用于追踪并删除互联网上的此类材料。
然后,xAI用这些数据训练了Grok。
这是周三提交的一起诉讼中的核心指控,也是针对一家大型生成式AI公司的最严重索赔之一,直指其训练数据的来源问题。这份诉状不仅指控xAI拥有CSAM,更指控该公司使用儿童虐待图像——无论是真实的还是AI生成的——来构建全球部署最广泛的图像生成模型之一。如果指控成立,这不仅仅是违法问题,更是揭示了当前AI训练流程的结构性缺陷,以及为何这种结构可能与儿童安全根本不相容。
默认设置的问题
这起诉讼最重要的主张,与CSAM本身无关,而是关乎Grok本身的默认配置。
根据诉状,xAI的服务条款将每条公共X帖子和每次Grok输出都视为自动训练数据。没有退出选项。用户生成内容与模型燃料之间没有界限。系统的架构假设规模就是一切:将所有内容投入研磨机,提取模式,改进模型。这正是当下许多生成式AI系统的工作方式,xAI只是在服务条款中将其明示罢了。
诉状进一步指出,xAI会对Grok输出的暴力内容进行过滤后再喂入训练——但对CSAM、非自愿私密图像或NSFW内容却不做此类排除。逻辑推论十分刺目:任何进入公共管道的非法或有害内容,都将永远留在模型中。一旦CSAM流经Grok的生成系统,它就成为训练集的一部分;一旦进入训练集,要从已训练好的模型中去除其影响,技术上几乎不可能。
这不是xAI设计中的一个缺陷,而是"将数据积累置于内容排除之上"的设计选择的必然结果。同样的模式在整个行业普遍存在:OpenAI、Google、Meta——都在构建吸收海量公开数据的系统,只是过滤程度各不相同。xAI的诉讼让所有人都在心里清楚、却鲜少直面应对的问题浮现出来:当你将所有用户内容视为模型输入时,你就无法在训练阶段选择性排除非法内容,因为你可能永远不知道什么进入了系统。
针对AI公司的一起CSAM集体诉讼
这是首一起指控大型AI公司使用CSAM进行训练的诉讼。此前Ars Technica和其他媒体的报道已记录过研究人员在训练数据集中发现非法内容的案例——包括一个在被发现后被清洗的争议性数据集。但那些都是孤立事件。这起诉讼针对的是一家奉行开放数据理念构建产品的公司,而它却未能过滤最恶劣的内容。
多伊拟议的集体诉讼将代表每一位童年图像被用于生成AI版CSAM的幸存者。这个群体可能极其庞大。生成式AI训练的数学规律意味着,即便一张图像喂入模型,也能产生数千种变体。每一个变体都是一次新的伤害,从法律角度来说,若通过xAI被指控所使用的方式生成,每一次变体都是一桩新的犯罪。
诉状援引了联邦儿童淫秽物品法和《玛莎法》(Masha’s Law),这两项法律赋予CSAM幸存者起诉生产、持有和传播行为的权利。多伊的律师之一玛格丽特·E·马比(Margaret E. Mabie)在新闻发布会上表示,xAI犯下了全部三项罪行。若属实,这将是首例因训练做法而对AI公司提起的类似刑事共谋的起诉,民事赔偿金额可能极为巨大。
模型记住了什么
诉状中最关键的细节是:xAI从未公开宣称已从Grok的训练数据中消除任何CSAM的影响。一旦被吸收,这些材料就会塑造模型的输出。即便原始图像被下架,即便xAI停止接受新的CSAM输入,模型仍会继续生成受已吸收材料影响的內容。
这对CSAM受害者构成了一个极其危险的反馈循环。每当用户提示Grok生成性化图像时,模型可能——无论多么间接——都会产生受原始虐待材料影响的变体。诉状指控,在线论坛上的消息讨论了制作以多伊及其他已知受害者为原型的AI生成CSAM,表明该模型正被用于 exactly 这一目的。无论Grok是有意还是无意地生成这些图像,结果相同:幸存者的创伤正被算法规模化重演。
行业层面的影响
如果简·多伊胜诉,后果将远超xAI一家。判决可能确立:任何将用户生成内容视为自动训练数据的AI公司,都要为其系统中流动的非法内容承担连带责任。这将迫使所有主要玩家——OpenAI、Google、Meta、Anthropic、Stability AI——重新设计数据管道,在摄入环节实施强制过滤,并为可能含有非法内容的用户创建退出机制。
经济影响将十分显著。自动训练数据摄入是像xAI和X这样的公司的核心竞争力之一:它创造了一个飞轮效应——更多用户生成更多数据,数据改善模型,模型吸引更多用户。打破这个飞轮——要求训练用途获得明确授权、实施实时内容筛查、接受部分用户内容必须被排除在模型训练之外——将推高成本、拖慢迭代,也会降低AI输出的质量和范围,因为训练语料库会变小、过滤会更严格。
监管机构已在朝这个方向行动。欧盟《人工智能法案》要求对训练数据保持透明。加州正在考虑立法,赋予用户退出AI训练的权利。xAI的诉讼可能通过创造使公司在财务上对其吸收的内容负责的判例,加速这两项举措。
那个无解的问题
这起诉讼提出的最深层问题,并非法律或技术问题,而是道德问题。生成式AI行业一直基于一个假设:数据就是数据——每一张图像、每一段文字、每一次发帖都是同等价值的训练材料。这个假设将人类经验视为原材料。用于生成营销文案或编程辅助时,它运作良好;但当原材料包含儿童虐待证据时,这个假设就会遭遇灾难性的失败。
行业需要一个新假设:有些数据并非中立,将其摄入模型不是一种被动行为,而是一个有后果的主动选择。xAI的服务条款体现的是旧假设,而简·多伊的诉讼正迫使法院和行业直面:当这个假设与人性中最恶劣的现实发生碰撞时,会发生什么。
判决结果将决定AI公司能否继续在所有能爬取到的数据上训练,还是必须建立护栏以排除最危险的内容——即便要为此牺牲能力和规模。模型无法"忘记"它已吸收的一切。问题是,这个行业能否及时醒悟。