El filtrado del A20 Pro de Apple muestra a un diseñador de chips estirado hasta el límite
Un filtrado en japonés sugiere que el A20 Pro gana un séptimo núcleo de GPU y mayor ancho de banda de memoria. Los números revelan la estrategia de silicio de Apple bajo presión por la carrera de la IA.
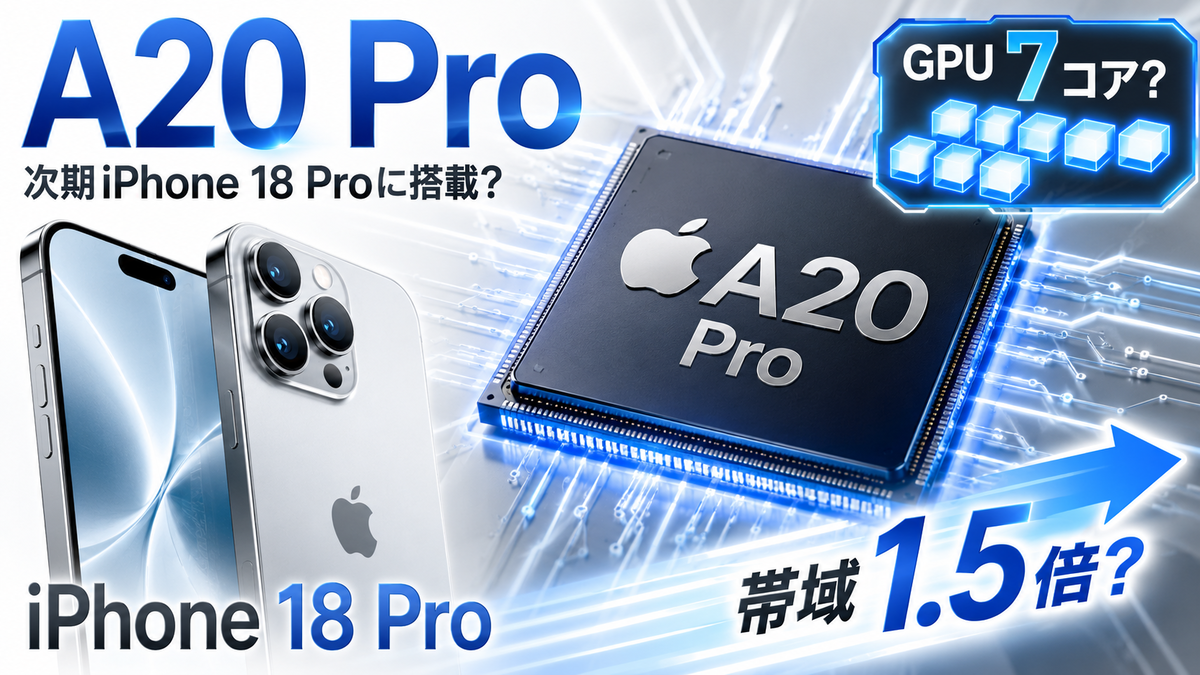
El rumor del A20 Pro que cuenta una historia más grande
Una publicación de un usuario de Weibo conocido como 白饭炒白米饭 — traducido de manera aproximada como “Arroz blanco salteado con arroz blanco” — apareció con discreción el 30 de agosto. Para cualquiera que escanee las redes sociales chinas, parecía otra desarmado granuloso con etiquetas especulativas. Para quien sigue el flujo de información desde Japón hacia los medios tecnológicos occidentales, era un reflejo de un patrón que la cadena de suministro de Apple ha utilizado cada vez más para enviar señales: filtraciones de foros asiáticos, recogidas por publicaciones como ASCII.jp y MacRumors, llegan días o semanas antes del evento oficial de Cupertino.
Esta vale la pena analizarla no solo por los números, sino por lo que estos sugieren sobre hacia dónde Apple se ve obligada a moverse.
El autor superpuso una imagen del paquete del A20 Pro contra un diagrama de pines y razonó sobre la disposición de los componentes al coincidir los patrones de las almohadillas de soldadura con las regiones probables del die. Su conclusión: la GPU ocupa la porción superior del chip, la CPU está en el medio, y la configuración de núcleos es de seis en total — dos núcleos de rendimiento emparejados con cuatro núcleos de eficiencia.
El hallazgo más importante concierne a la GPU. El usuario probó docenas de configuraciones con 6, 7 y 8 núcleos y encontró que siete núcleos producían la distribución geométricamente más plausible. Eso sería un núcleo adicional sobre los seis del A19 Pro, lo que se traduce en un aumento de aproximadamente un 16 % en rendimiento gráfico bruto si las velocidades de reloj se mantienen.
Apple no publica benchmarks por núcleo de GPU, pero una ganancia del 16 % es significativa en una generación donde competidores como Qualcomm y MediaTek han estado introduciendo diseños de ocho núcleos Adreno e Immortalis en la misma clase de dispositivo. Apple está cerrando la brecha, no ampliando una ventaja.
Los números de caché cuentan una historia más clara
Las cifras de caché son donde la filtración se vuelve específica y, argüiblemente, más reveladora. Se reporta que la caché L2 del clúster de alta eficiencia crece de 6 MB a 8 MB. La caché L2 del clúster de rendimiento se mantiene en 16 MB. Esa asimetría es intencional: señala que Apple está reequilibrando hacia la eficiencia energética en lugar de perseguir la velocidad de reloj máxima, una estrategia que ha definido las transiciones de nodo TSMC desde el A14.
El razonamiento que dio el autor es consistente: se espera que Apple envíe un nuevo procesador de señales de imagen y un motor neuronal rediseñado en esta generación. Ambos demandan mayor ancho de banda on-die. Mantener la L2 de rendimiento plana mientras se expande la L2 de eficiencia preserva margen térmico para cargas de trabajo sostenidas — el tipo de cargas sostenidas que definen la inferencia de IA móvil, no ráfagas cortas de benchmark.
La capacidad de SLC — la caché compartida de último nivel — no se reveló en la filtración. Apple ha mantenido históricamente esta cifra en opacidad, y aún no hay confirmación independiente. Pero dado la presión arquitectónica del nuevo ISP y el motor neuronal, sería sorprendente si Apple la redujera. Una reducción de caché en este contexto sería una bandera roja, no un refinamiento.
El salto de ancho de banda es la verdadera señal
MacRumors recogió la publicación y destacó un detalle que importa más que el conteo de núcleos: se rumorea que la interfaz de memoria se ensancha de 64 bits a 96 bits. Eso es un aumento del 50 % en el ancho de banda teórico entre la RAM y el SoC.
El rendimiento gráfico escala con el ancho de banda tanto como con el número de núcleos, especialmente en la arquitectura de memoria unificada de Apple, donde la GPU y la CPU comparten el mismo pool. Un bus más ancho significa que el núcleo de GPU adicional realmente tiene con qué trabajar. Sin el aumento de ancho de banda, la GPU de siete núcleos se ahogaría bajo cargas pesadas y las ganancias serían marginales. Con él, la mejora se vuelve estructural en lugar de cosmética.
Esta es también la primera vez que Apple supera los 64 bits en un SoC de iPhone. La línea A-series ha usado interfaces de 64 bits desde al menos el A13, y algunos podrían leer el cambio a 96 bits como un movimiento de seguimiento contra los buses de 128 bits más amplios comunes en los flagship Android. Ese marco sería erróneo: el modelo de memoria unificada de Apple logra una eficiencia diferente a 96 bits que una arquitectura dividida logra a 128 bits. Pero la presión competitiva es real, y la dirección es clara.
Por qué importa ahora una filtración de fuente japonesa
ASCII.jp, que originalmente publicó la recopilación en japonés, tiende a reportar rumores a nivel de chips y componentes meses antes que los medios occidentales. La razón es estructural: la prensa electrónica de Japón mantiene relaciones más profundas con distribuidores de componentes y fuentes adyacentes a TSMC en la cadena de suministro. Cuando ASCII reporta un análisis de pinout, a menudo está haciendo eco de una conversación que comenzó en un canal relacionado con fábricas en Taiwán o Corea semanas antes.
Para los lectores occidentales, la conclusión es sencilla: estas filtraciones no son ruido. Son lecturas tempranas de una cadena de suministro que se comunica a través de intermediarios porque Apple misma no confirmará nada hasta la keynotes. La publicación en Weibo, filtrada a través de ASCII y MacRumors, lleva el tipo de especificidad — conteos exactos de núcleos, tamaños de caché, disposición de pines — que normalmente proviene de personas que han manipulado el paquete real.
Quiénes ganan, quiénes pierden y qué sigue
Los ganadores son los usuarios que juegan en iPhone y los desarrolladores que construyen modelos de IA en el dispositivo. Una GPU de 7 núcleos con 96 bits de ancho de banda hace que la máquina sea genuinamente utilizable para cargas de trabajo más pesadas sin throttling tan agresivo. La decisión de Apple de retomar el rumor del iPhone plegable junto con esta filtración es notable: el primer plegable necesitará una plataforma de silicio que pueda sostener cargas sostenidas más altas de dos pantallas, y el A20 Pro parece diseñado exactamente para esa restricción.
Los perdedores son los cazadores de benchmarks. Esta no es una salto generacional. Un aumento del 16 % en GPU y un 50 % en ancho de banda son incrementales según los estándares históricos de Apple: la transición del A17 Pro al A18 Pro vio un ritmo similar. Lo que cambia es la dirección de la arquitectura, no su velocidad.
La pregunta real es si Apple puede convencer a los consumidores de que un chip con ganancias modestas en titulares vale la pena para el ciclo de actualización. La respuesta llegará en el evento de la próxima semana, cuando Apple confirme estos detalles o revele un diseño que diverja completamente de la filtración. Dado lo preciso que es el análisis de pinout, la divergencia es poco probable; pero la confirmación será lo que importe.
Si el A20 Pro se envía como se describe, será el silicio de iPhone más equilibrado de Apple en años. No el más rápido en papel. Pero diseñado para la carga de trabajo que realmente define el dispositivo: inferencia de IA sostenida, imagen en el dispositivo y gráficos que ya no se throttlean después de tres minutos.