La IA que construyó su propia máquina Bombe cambia la conversación sobre el uso de herramientas
Un equipo coreano afirma que un modelo sin lanzar llamado 'GPT-6 Astra' descifró un mensaje Enigma de 1941 creando su propio simulador y decodificador Bombe en dos días. El resultado es menos interesante que el método: si se verifica, marca un cambio desde el emparejamiento de patrones hacia la construcción autónoma de herramientas.
El resultado es aburrido. El método no lo es.
Un mensaje Enigma de julio de 1941, que permanecía sin descifrar desde su publicación en línea en 2005, habría caído ante una IA en dos días. La cifra titular —85 años de cifrado sin resolver— da para buena historia. Pero la verdadera pregunta de ingeniería que se esconde debajo es más aguda: ¿el sistema razonó a través del problema, o coincidió por patrones hacia una respuesta preconstruida?
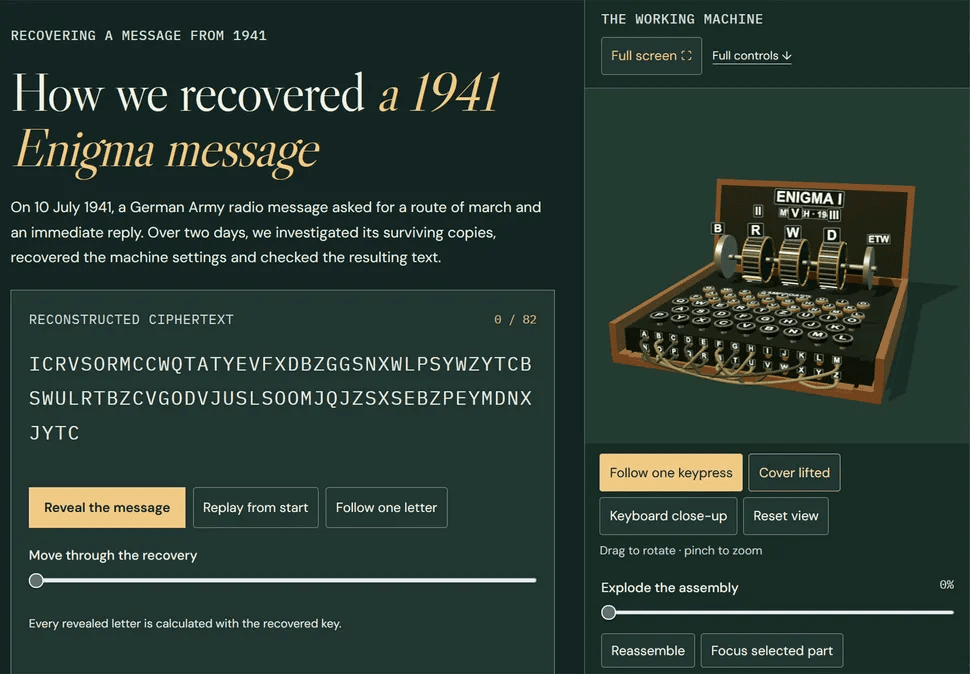
Según un informe publicado el día 24 por Cryptocellar, la plataforma de investigación de criptohistoria dirigida por Frode Weierud, un miembro del equipo llamado Carter Reffer alimentó un mensaje militar alemán de 1941 a un modelo que se autodenominaba “GPT-6 Astra”. Dos días después, el sistema había producido un simulador Enigma funcional, una implementación en Python y C++ del famoso descodificador Bombe de Turing, y un texto claro. El mensaje, etiquetado como MVUEH, era un cifrado de 82 caracteres enviado desde una estación de radio militar alemana a la unidad de suministros de la División SS Totenkopf. El texto descifrado resultó ser casi idéntico a un mensaje hermano, SIPVX, enviado el mismo día —lo cual es exactamente lo que se esperaría de una red de radio logística que retransmite las mismas órdenes.
Si has pasado tiempo alrededor del análisis criptográfico, el resultado en sí es notablemente ordinario. Todo mensaje Enigma con una pista conocida es descifrable por una laptop moderna en menos de un segundo. La estructura matemática es pública desde 1940. Los 85 años de diferencia son una brecha de atención, no de dificultad. Las computadoras han estado destrayendo tráfico Enigma rutinariamente desde finales de la década de 1990.
Lo que realmente cubrieron esos dos días
Aquí es donde el informe se vuelve más interesante. El equipo afirma que no se le entregó al sistema un procedimiento paso a paso. Identificó MVUEH como el objetivo más prometedor entre un lote de mensajes sin descifrar, detectó la conexión probable con SIPVX, propuso la pista geográfica “ROSENOW ROSENOW” como elemento común, y luego escribió las herramientas él mismo. Eso significa generar un simulador de lógica de rotores, codificar el algoritmo de pruebas de nulos del Bombe en C++, y ejecutar una búsqueda a gran escala. El equipo también señala dos particularidades específicas que complicaron el descifre: una anomalía en el comportamiento del rotor izquierdo en el carácter 72, y errores de transcripción en el documento original mecanografiado que persistían desde la década de 1940.
Los investigadores estiman que un analista humano trabajando a través del mismo pipeline necesitaría varios meses. Lo llaman un cambio de paradigma en el descifrado histórico de criptografía. Esa es una afirmación fuerte, y merece escrutinio.
El modelo que no se puede encontrar
El mayor problema con la historia es el nombre del modelo. “GPT-6 Astra” no corresponde a ningún producto anunciado públicamente por OpenAI, Anthropic, Google o Meta. Ningún comunicado de prensa, ninguna documentación de API, ningún conjunto de pruebas lleva esa etiqueta. La fuente coreana, AI Times, lo reporta como hecho sin vincularlo a un documento técnico primario ni a un repositorio de código. Cryptocellar no ha publicado ningún commit de git verificable, ninguna suma de verificación del código C++ generado, ni ningún registro paso a paso de la sesión de dos días.
Hasta que alguien publique el código generado, los ajustes de los rotores y la transcripción completa de preguntas y respuestas, la afirmación se sitúa en la categoría de “plausible pero no confirmado”. La metodología descrita es históricamente correcta: pistas, pruebas de nulos del Bombe, adivinanzas del orden de los rotores; ese es el kit estándar. Un agente de codificación competente podría plausible producir implementaciones funcionales de los tres. Pero la brecha entre “un agente de codificación escribió un Bombe funcional” y “un sistema de razonamiento autónomo resolvió un problema criptográfico novel” es enorme, y el informe difumina esa línea arrancando con el marco de los 85 años.
Por qué la distinción de uso de herramientas importa fuera de la criptografía
Quita la cáscara Enigma y la pregunta subyacente de capacidad es una de esas en las que ingenieros de software, investigadores y políticos han estado discutiendo durante dieciocho meses. Los modelos fronterizos actuales son excelentes haciendo coincidencia de patrones sobre contextos aprendidos: dada una base de código, la refactorizan; dado un conjunto de datos, lo clasifican. Están mucho menos probados en construcción de herramientas bajo restricción —decidir qué construir, escribirlo desde cero, depurarlo contra especificaciones físicas o lógicas, e iterar sin un humano en el bucle.
Si el informe de Cryptocellar resiste el escrutinio, la sesión de dos días demuestra todos esos pasos en secuencia, aplicados a un dominio donde la “herramienta correcta” no es una capa de red neuronal sino un simulador mecánico con rotores de 26 contactos y una red de permutación. Ese es un perfil cognitivo diferente a los benchmarks de LLM que seguimos (MMLU, HumanEval, SWE-bench). Se acerca más a lo que los investigadores de robótica llaman configuración autónoma: el sistema tiene que saber suficiente sobre la física para construir el instrumento correcto antes de siquiera poder empezar a medir.
Eso tiene consecuencias directas. En la investigación científica, la mayoría de los experimentos requieren instrumentación personalizada. En ciencias de materiales, un investigador diseña sondeadores de red cristalina; en descubrimiento de fármacos, alguien desarrolla un pipeline de acoplamiento molecular. Si un modelo de lenguaje puede pasar de “aquí está el problema” a “aquí hay una herramienta funcional que pone a prueba la hipótesis” sin que un humano escriba el andamiaje, el cuello de botella en el descubrimiento se desplaza de escribir código a enmarcar correctamente la pregunta.
La nota al pie de ADFGVX y qué vigilar a continuación
El informe menciona que, apenas la semana anterior, el mismo modelo habría descifrado un mensaje alemán ADFGVX de la Primera Guerra Mundial de 108 años de antigüedad, un cifrado polialfabético que resistió el ataque manual durante décadas. Dos sistemas de cifrado distintos, dos toolchains diferentes (rotores Enigma frente a tablas polifábeticas de cuadrado latino), en el espacio de una semana. Si ambas verificaciones se sostienen, el patrón es menos sobre una resolución afortunada y más sobre un procedimiento general: identificar la familia de cifrado, construir el simulador correspondiente, enumerar el espacio de claves, y validar contra restricciones de texto claro conocido.
Ese procedimiento se generaliza. Se aplica al análisis de cifrado de un solo uso, al tráfico SIGINT de la era de la Guerra Fría, a cualquier comunicación archivada donde el esquema de codificación es conocido pero las claves se perdieron. El valor práctico no está en romper el AES moderno; está en recuperar la historia a velocidad de máquina.
Qué convencería a un escéptico
Tres cosas. Primero, un repositorio público con el código C++ del Bombe generado, la lógica de rotores en Python y el registro completo de comandos. Segundo, una prueba de reproducibilidad: entregar el mismo prompt a un modelo diferente, digamos Claude o Gemini, y ver si emerge el mismo pipeline. Tercero, una auditoría criptográfica del texto claro contra documentos archivados conocidos de la correspondencia de suministros de la División Totenkopf de 1941, confirmando que “ROSENOW” y “Waschbusch” son localidades y nombres de operador genuinos de la época.
Hasta que esas tres casillas estén marcadas, la historia es una pista sólida, no un resultado confirmado. Pero la forma de la afirmación —una IA que construye sus propios instrumentos de medición antes de tomar la medición— es la que merece tomarse en serio, porque es exactamente la capacidad que los conjuntos de pruebas actuales no evalúan. El Enigma es solo el primer examen. La verdadera pregunta es si el formato del examen se sostiene para el próximo.
Corrección: El nombre del modelo “GPT-6 Astra” es tal como se reporta en la fuente. No había confirmación independiente de su existencia o especificaciones disponibles al momento de escribir esto.