Ejecutar LLMs locales solo en una NPU es una difícil decisión
MINISFORUM, de Japón, impulsa la NPU del Ryzen AI 9 HX 470 para inferencia de LLMs locales sin GPU dedicada. La historia del hardware es convincente; la de rendimiento aún está en desarrollo.
La pregunta sobre la NPU que nadie más hace en voz alta
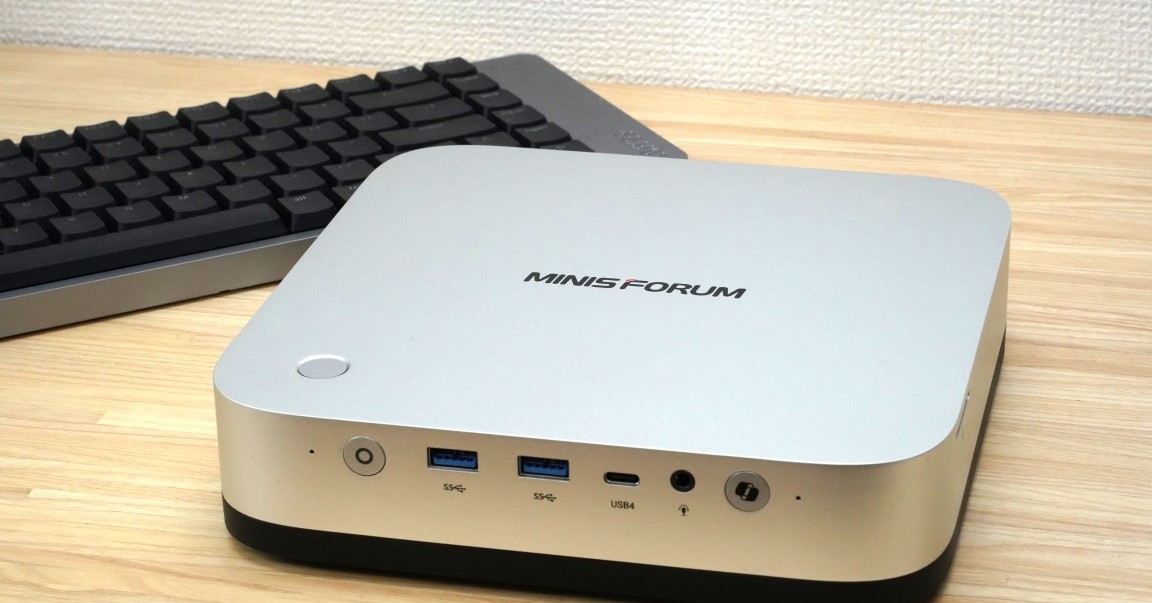
Ahora mismo se está llevando a cabo un experimento silencioso sobre los escritorios de Tokio, y no recibe cobertura en la prensa tecnológica en inglés. MINISFORUM, un fabricante japonés de mini PCs con apetito por el hardware agresivo en cajas compactas, ha enviado al mercado una máquina llamada AI X1 Pro-470, construida en torno al procesador Ryzen AI 9 HX 470 de AMD. El chip integra una unidad de procesamiento neural (NPU) de 44 TOPS junto a una CPU Zen 5. La propuesta, no dicha pero innegable, es esta: ¿puedes ejecutar modelos de lenguaje grandes locales útiles solo con esa NPU, sin una GPU discreta?
Esa pregunta importa porque se encuentra en el centro de la carrera por el hardware de IA en el borde. La inferencia en la nube es costosa y sufre de latencia. La inferencia local en una GPU es potente pero cara y consumiende energía. La NPU se supone que es el camino intermedio: lo suficientemente eficiente para el escritorio, lo suficientemente dedicada para ejecutar modelos que harían que un CPU se ahogara. Si realmente lo es sigue siendo la pregunta que la última máquina de MINISFORUM está diseñada para responder.
Qué dice realmente el hardware
El AI X1 Pro-470 conserva el mismo chasis que su predecesor, el AI X1 Pro que llevaba el Ryzen AI 9 HX 370. Las dimensiones son de aproximadamente 195 por 195 por 47,5 milímetros. No es diminuto, pero sí compacto para lo que lleva dentro. La verdadera historia está en la arquitectura de expansión.
El panel trasero cuenta con dos puertos Ethernet 2.5GbE que utilizan el controlador RTL8125 de Realtek. Dos segmentos de red independientes de una sola caja es inusual para un mini PC y señala que esta máquina fue diseñada para personas que ejecutan homelabs, redes de laboratorio o pilas de inferencia local que necesitan separación de la conexión a Internet del hogar. Es un detalle que la mayoría de los revisores pasará por alto y las personas indicadas notarán.
Las salidas de video incluyen HDMI 2.1 con soporte FRL, DisplayPort 2.0 y un puerto USB4 que admite modo alternativo DisplayPort. También hay un puerto OCuLink. Ese es el puerto que merece atención. OCuLink transmite señales PCIe en bruto directamente, eliminando por completo el controlador USB. Ofrece sustancialmente más ancho de banda que USB4 y mucha menos sobrecarga de latencia, lo que lo convierte en la ruta preferida para gabinetes de GPU externos y matrices de almacenamiento de alta velocidad. No soporta hot-swap, pero la compensación vale casi con certeza la pena si planeas conectar una eGPU más adelante.
La máquina también incluye un lector de huellas dactilares integrado en la tapa superior: autenticación biométrica Windows Hello en un factor de forma de escritorio. No es una especificación sobre la que la gente pelee, pero es el tipo de detalle que indica que MINISFORUM entiende a su audiencia: usuarios que quieren una experiencia de escritorio sin tratar su mini PC como un equipo periférico.
Dónde tropieza el hardware
No todo es fortaleza. La ranura de tarjeta SD incorporada en el lado derecho está cableada internamente a través de un puente USB 2.0 con lector de tarjetas, a pesar de que la ranura está etiquetada para tarjetas UHS-II. Una tarjeta ProGrade Digital SDXC UHS-II probada en la máquina obtuvo solo 37,29 megabytes por segundo de forma secuencial. Eso es comportamiento USB 2.0, no comportamiento UHS-II. Para cualquiera que mueva archivos grandes de fotos o video regularmente, ese cuello de botella será notable y frustrante. Es un costo modesto ahorrado a nivel de PCB que subestima el resto de la disposición de E/S, de otro modo agresiva, de la máquina.
La prueba real: inferencia de LLM local solo con NPU
La revisión del hardware es solo la mitad de la historia. La tercera página del artículo está dedicada a ejecutar inferencia de LLM local utilizando solo la NPU y comparando esos resultados contra la inferencia basada en GPU. Ahí es donde el debate de la IA en el borde se vuelve concreto.
La NPU del Ryzen AI 9 HX 470 ofrece 44 TOPS de rendimiento pico. Para contextualizar, muchas GPUs discretas de generación actual entregan entre 30 y 130 TOPS dependiendo del modelo y el esquema de cuantización. La NPU no está en la misma liga que una GPU de gama alta. Pero la inferencia de LLM local no siempre requiere ese tipo de holgura, especialmente cuando los modelos se cuantizan a formatos de 4 bits o 5 bits y se ejecutan con longitudes de contexto modestas.
La pregunta práctica es si 44 TOPS en una NPU pueden sostener generación de tokens utilizable para modelos en el rango de 7B a 14B parámetros. Los datos tempranos de plataformas similares sugieren que modelos cuantizados a 4 bits como Llama 3.2 y Phi-4 pueden de hecho ejecutarse en hardware solo con NPU, aunque típicamente a tasas de tokens que se sienten adecuadas para chat y asistencia de código más que para transmisión en tiempo real. El cuello de botella rara vez es la capacidad de cómputo bruta: es el ancho de banda de memoria y la eficiencia del runtime de inferencia que se apila sobre el controlador de la NPU. La pila de software Ryzen AI de AMD ha estado madurando rápidamente, y la NPU del X 470 está construida sobre la arquitectura Strix Point de AMD, que incluye soporte de cuantización mejorado y mejor integración con herramientas como llama.cpp y Ollama a través de sus backends ROCm y DirectML.
Quiénes ganan y quiénes pierden
Si el enfoque solo con NPU entrega un rendimiento aceptable para cargas de trabajo cotidianas de LLM local, los ganadores son evidentes: compradores de portátiles y mini PCs que no quieren llevar una eGPU ni mantener un escritorio con una tarjeta gráfica discreta. El perfil energético es dramáticamente inferior. Un rig de inferencia de escritorio completo que consume entre 150 y 300 vatios puede ser reemplazado por una máquina que extrae entre 30 y 60 vatios bajo carga similar. Para homelabs, oficinas remotas y cualquier persona que ejecute agentes de IA locales o herramientas de copileto personal, esa brecha de eficiencia es la diferencia entre un servicio de fondo y una sorpresa estacional en la factura de servicios.
Los perdedores son las personas que ya poseen máquinas con GPUs capaces y esperan que la NPU las reemplace. No lo hará. Una NPU es un motor de especialización, no un acelerador gráfico de propósito general. Para cualquier cosa más allá de la inferencia cuantizada —entrenamiento, ajuste fino, pipelines multimodales o modelos mayores a aproximadamente 14B de parámetros— una GPU discreta sigue siendo necesaria.
También existe un tercer grupo que pierde sin necesariamente darse cuenta: los proveedores de inferencia en la nube. Cada sesión de inferencia local que permanece en el dispositivo es una sesión que no golpea un centro de datos. La tendencia es pequeña en términos absolutos hoy, pero se compone. Si la inferencia con NPU del consumidor alcanza la paridad con las llamadas a API en la nube para casos de uso comunes —resumen, asistencia de codificación, razonamiento básico— la economía del servicio de LLM en la nube comienza a erosionarse en el extremo bajo.
Qué sigue
MINISFORUM está probando esto en vivo en Japón, y los resultados importarán más allá de ese mercado. El AI X1 Pro-470 no es un producto de nicho: forma parte de un cambio más amplio hacia un hardware para consumidores que trata la inferencia de IA como una carga de trabajo de primera clase, no como un parche añadido a rigs de gaming.
AMD está impulsando con fuerza su marca Ryzen AI, y el chip X 470 está posicionado como la respuesta de la compañía a la demanda creciente de IA local eficiente. Intel está respondiendo con sus propios procesadores equipados con NPU, y Qualcomm hace lo mismo para Windows en Arm. El hardware está llegando más rápido de lo que el ecosistema de software se estabiliza alrededor de él. Esa brecha es donde vive la frustración hoy, y también es donde vive la oportunidad.
Lo que queda claro del marco de revisión de MINISFORUM es que la pregunta ya no es si las NPUs del consumidor pueden ejecutar LLMs locales. Pueden. La pregunta es si pueden ejecutarlos lo suficientemente bien para cambiar las decisiones de compra. La respuesta determinará si la siguiente oleada de compras de hardware de IA está impulsada por velocidad de reloj y conteo de núcleos tensor, o por eficiencia, termalización y lo que la NPU puede sostener durante una sesión larga de inferencia sin throttling.
Japón está ejecutando ese experimento ahora mismo. El mundo debería estar observando.