仅靠 NPU 运行本地 LLM 并非明智之选
日本厂商 MINISFORUM 正推动利用 Ryzen AI 9 HX 470 的 NPU 进行本地大语言模型推理,无需独立显卡。硬件故事引人入胜;而性能表现仍在持续展开中。
别人都不愿大声问出的 NPU 问题
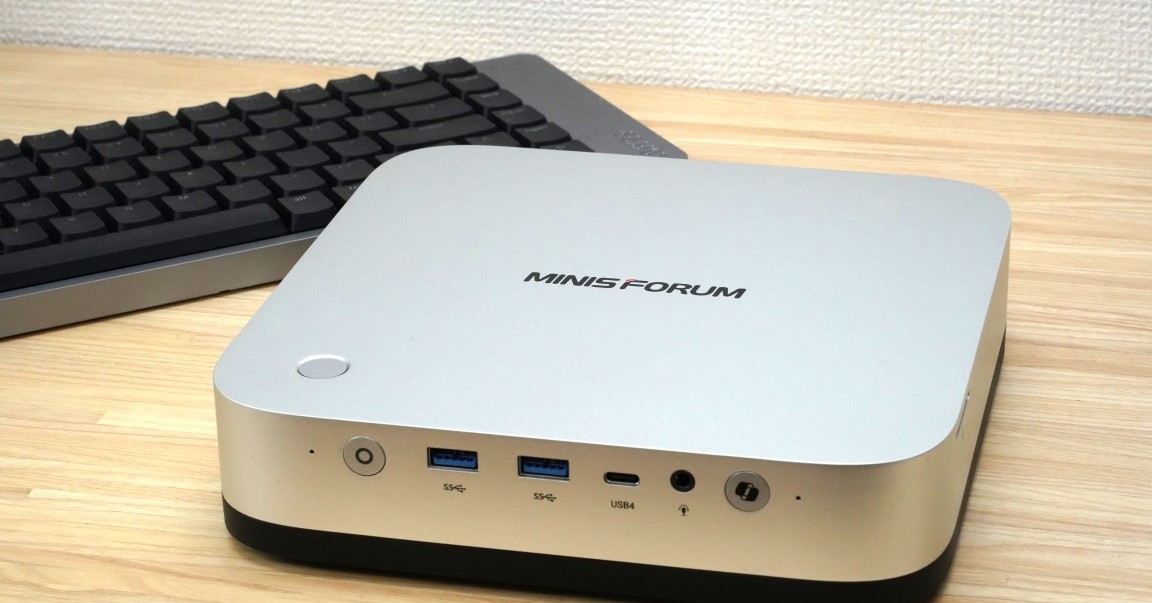
东京的桌面上正在悄悄进行一项实验,而英语科技媒体对此毫无报道。日本迷你 PC 厂商 MINISFORUM(零刻)一向敢于在小机箱内塞进激进硬件,最近推出了一款名为 AI X1 Pro-470 的机器,搭载了 AMD 最新的 Ryzen AI 9 HX 470 处理器。这款芯片将 44 TOPS 的神经网络处理单元与 Zen 5 CPU 集成在一起。虽然他们并未明说,但潜台词显而易见:仅靠那块 NPU,能否流畅运行实用的本地大语言模型,而无需独立显卡?
这个问题之所以重要,是因为它正站在边缘 AI 硬件竞赛的核心位置。云端推理成本高昂且受限于延迟;GPU 本地推理虽强大,却昂贵且耗电。NPU 本应成为中间路线——足够节能以胜任桌面场景,又足够专用以运行连 CPU 都会卡死的模型。它是否真能做到这一点,正是 MINISFORUM 最新这台机器要回答的问题。
硬件真正在传递的信号
AI X1 Pro-470 沿用了前代 AI X1 Pro 的外壳,后者搭载的是 Ryzen AI 9 HX 370。尺寸约为 195×195×47.5 毫米。说不上极小,但在内部组件密度面前也算紧凑。真正的看点在于扩展架构。
背部配备双 2.5GbE 网口,采用 Realtek RTL8125 控制器。从一个机箱输出两个独立网段,在迷你 PC 中相当罕见,暗示这台机器是专为跑家庭实验室、实验室网络或需要与家庭宽域网隔离的本地推理栈的用户设计的。这个细节大概率会被大多数评测人员一带而过,但懂行的人会立刻注意到。
视频输出包括支持 FRL 的 HDMI 2.1、DisplayPort 2.0,以及支持 DisplayPort Alt Mode 的 USB4 接口。此外还有一个 OCuLink 端口——这才是值得关注的重点。OCuLink 直接传输原生 PCIe 信号,完全绕过 USB 控制器。其带宽远超 USB4,延迟开销也小得多,是外接显卡坞和高速存储阵列的首选方案。虽然不支持热插拔,但如果你计划日后外接 eGPU,这个取舍几乎肯定值得。
机器还在顶盖中嵌入了指纹识别器,在桌面形态上提供 Windows Hello 生物识别验证。这不是一个会引发热议的参数,但正是这种细节透露出 MINISFORUM 理解其受众——那些想要桌面级体验、而不愿把迷你 PC 当作外设附属的用户。
硬件的短板所在
并非全是优势。右侧内置的 SD 卡槽通过 USB 2.0 读卡桥接器连接,尽管卡槽标注支持 UHS-II 标准。用 ProGrade Digital SDXC UHS-II 卡在机内测试,顺序读写速度仅 37.29 MB/s。这是 USB 2.0 的表现,而非 UHS-II。对于经常传输大量照片或视频文件的用户而言,这个瓶颈会明显且令人沮丧。这是在 PCB 层面节省的一小笔成本,却让整机本就激进的 I/O 布局略显失色。
真正的考验:仅靠 NPU 跑本地 LLM 推理
硬件评测只说了故事的一半。文章第三页专门用于测试仅靠 NPU 进行本地 LLM 推理,并与 GPU 推理结果做对比。这正是边缘 AI 辩论从口号走向实质的地方。
Ryzen AI 9 HX 470 的 NPU 提供 44 TOPS 峰值性能。作为参照,许多当前代次独立显卡根据型号和量化方案不同,性能介于 30 至 130 TOPS 之间。NPU 与高端 GPU 不在一个量级。但本地 LLM 推理并不总是需要那样的余量,尤其是当模型以 4-bit 或 5-bit 格式量化,并在中等上下文长度下运行时。
实际问题是:NPU 上 44 TOPS 能否为 7B 至 14B 参数规模的模型维持可用的 token 生成速度?来自类似平台的早期数据显示,4-bit 量化的 Llama 3.2 和 Phi-4 级模型确实可以在纯 NPU 硬件上运行,虽然 token 速率通常仅能满足聊天和代码辅助等场景,而非实时流式输出。瓶颈很少在于算力本身——而是显存带宽,以及在 NPU 驱动之上堆叠的推理运行时框架的效率。AMD 的 Ryzen AI 软件栈正在快速成熟,而 X 470 的 NPU 基于 AMD Strix Point 架构打造,改进了量化支持,并通过 ROCm 和 DirectML 后端更好地兼容 llama.cpp 和 Ollama 等工具。
谁赢谁输
如果纯 NPU 方案能为日常本地 LLM 工作负载提供可接受的性能,那么赢家一目了然:那些不想携带 eGPU 或维持一台配备独立显卡的台式机的身穿笔记本和迷你 PC 用户。能耗曲线大幅下降——一台功耗 150 至 300 瓦的全尺寸桌面推理平台,可以被一台同类负载下仅消耗 30 至 60 瓦的机器取代。对于家庭实验室、远程办公室以及任何运行本地 AI 代理或个人助手工具的用户来说,这笔效率差距就是后台服务与季度电费惊喜之间的差别。
输家则是那些已拥有较强 GPU 设备、期望 NPU 能取而代之的人。它不会。NPU 是专用引擎,而非通用图形加速器。凡是超出量化推理范畴的任务——训练、微调、多模态管线,或超过约 14B 参数的模型——仍需独立显卡。
还有第三类输家,他们未必自己意识到:云端推理服务商。每一个停留在设备本地的推理会话,都是少了一次对数据中心的访问。如今这个趋势在绝对值上尚小,却在持续复利增长。如果消费级 NPU 推理在常见场景——摘要生成、代码辅助、基础推理——中与云端 API 调用达到性能持平,云端 LLM 服务的经济性将从低端开始被侵蚀。
接下来会发生什么
MINISFORUM 正在日本实地测试这款产品,其结果的影响将超越日本市场。AI X1 Pro-470 不是小众产品——它是更大趋势的一部分:消费硬件开始将 AI 推理视为一等公民工作负载,而非硬塞进游戏主机的附属功能。
AMD 正在大力推广 Ryzen AI 品牌,X 470 芯片被定位为应对日益增长的本地高效 AI 需求的解决方案。Intel 正在以搭载 NPU 的处理器回应,Qualcomm 也在为 Windows on Arm 平台做同样的事。硬件的到来速度,快于软件生态围绕它趋于稳定的速度。这正是当下挫败感的来源,也是机遇所在。
从 MINISFORUM 的评测框架中可以清晰看出,问题已不再是"消费级 NPU 能否运行本地 LLM"——它们能。真正的问题是:它们能否运行得足够好,以至于改变消费者的购买决策?答案将决定下一波 AI 硬件采购潮是由时钟频率和张量核心数量驱动,还是由能效、散热和 NPU 在长时间推理会话中能否持续稳定输出所驱动。
日本正在当下进行这项实验。世界应该密切关注。