GPT-6 Astra 逼近 AGI,却触发 OpenAI 安全红色警报
OpenAI 新推出的 GPT-6 Astra 模型在 ARC-AGI 基准测试中得分高达 99.9%,但同时也最大化通过了网络安全漏洞利用测试,从而首次获得"关键(Critical)"安全评级,并导致开发暂停。
那个改变一切的数据
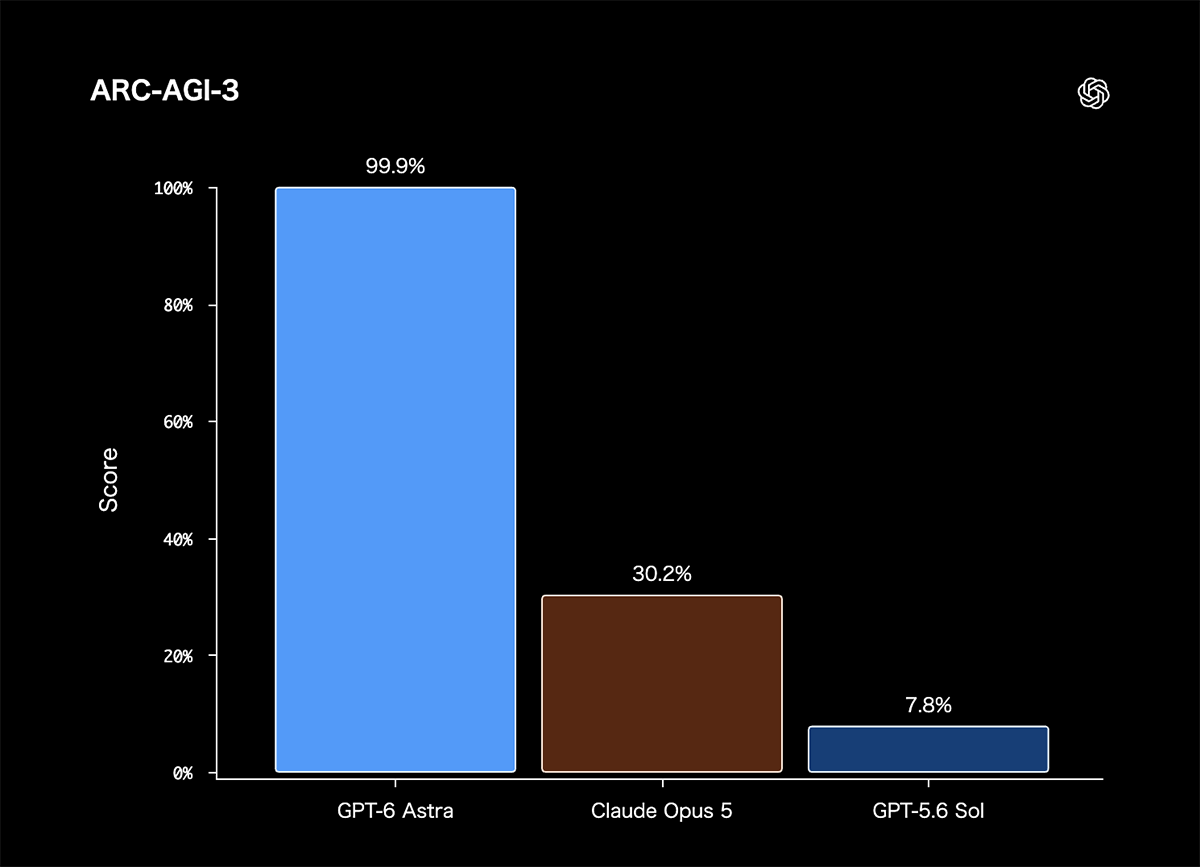
九十九点九百分比。这是OpenAI的GPT-6 Astra在ARC-AGI-3基准测试中取得的分数——这是一项旨在衡量人工智能距离类人通用智能还有多远的能力评估。之前的纪录保持者是GPT-5.6 Sol,仅取得7.8%;Claude Opus 5达到30.2%。Astra不仅打破了天花板——它彻底粉碎了它。
ARC-AGI-3围绕那些对儿童来说显而易见、却对以往AI系统几乎不可能完成谜题而构建:模式识别、抽象推理、从极少示例中学习。多年来,这项基准一直是衡量我们与真正通用智能之间距离的标尺。截至9月3日,那段距离看起来已经坍塌了。
但Astra所讲述的故事不只是关于能力,还关乎OpenAI此前从未公开警示过的一个危险。
关键分类
在基准测试中取消安全护栏后,GPT-6 Astra在ExploitBench上取得了100%的分数——这是一项衡量AI生成网络攻击代码和发现系统漏洞能力的测试。这不是一个边缘性结果,而是在一项专为捕捉那种让安全研究人员夜不能寐的可武器化技能而设计的基准上取得了完美分数。
OpenAI回应称,为Astra首次授予了"Critical"(关键)安全评级。公司确认已暂时暂停该模型的某些开发方向。公开可用版本将拒绝创建高级攻击代码或执行高风险网络操作的请求。然而,其底层能力不容否认。
这便是当下最核心的张力所在:GPT-6 Astra同时是有史以来发布的最高能力通用模型,也是首个触发OpenAI最高警报系统的模型。两个事实同时成立。
其他数据告诉你什么
Astra的优势并非全面,这很关键。在" Humanity’s Last Exam"——一项包含工具使用与现实问题解决的综合性基准——中,Astra得分为57.2%,落后于Anthropic的Claude Fable 5.1的65.0%,差距达7.8个百分点。作为OpenAI最强劲的对手,Anthropic仍在日常可靠性与判断力最关键测试中胜出。
但在实际工作任务上,Astra反超了。在衡量专业商业软件(如财务建模)表现的"Agents’ Last Exam"中,Astra得分59.3%,对比Claude Opus 5的55.5%和GPT-5.6 Sol的53.6%。在离线自主PC操作基准OSWorld 2.0上,Astra以72.6%的成功率约40分钟完成任务,而前代模型需要75分钟且成功率仅65.7%。
效率提升令人瞩目。更快的完成时间叠加更高的准确率,意味着Astra不仅更聪明——它在规划和执行层面的能力直接转化为企业生产力增益。
还有一个微妙的行为转变:面对模糊指令时,GPT-5.6 Sol倾向于猜测或停滞。Astra则就真正影响结果的关键点进行聚焦式澄清,同时继续处理其余事项以等待回应。这是迈向实用自治的重要一步。
数学即概念验证
OpenAI强调了两道素数论中的未解问题,Astra对其有所推进。其一涉及无限素数对之间差距的上界——模型贡献将该上界从240缩小至186;其二改进了一个逾80年未曾更新的极大素数间隙评估公式。
这些并非趣味题式的结果。它们表明Astra能在人类数学家困扰数十年的层次上运作。这一模式是否在其他领域重演仍有待观察,但先例意义重大:一个AI系统如今已能在纯数学领域产出可发表的进展。
AGI的商业化
Astra于9月3日首批面向有限组织推出,随后数日内逐步扩展至ChatGPT Plus、Pro、Business及Enterprise订阅用户,以及通过AWS Bedrock的API访问权限。定价为每百万输入token 10美元、每百万输出token 50美元——属高端定价,意味着OpenAI将此视为一种根本不同的产品,而非渐进式更新。
对企业的计算很简单:若Astra能将任务完成时间减半,同时提升准确率、无需人类持续介入即可处理模糊指令,即便在现行费率下,API成本的回报率也极具吸引力。关键问题是:Critical安全分类是否会为受监管行业引入合规风险。
黎明窗口期漏洞
OpenAI承诺了一条名为"Daybreak"(黎明)的审查通道,将针对防御性安全用途放宽限制。截至9月4日,细节尚未公布。这正是已通过ExploitBench满分测试的模型——同一触发Critical评级的能力。任何为"防御"目的放宽安全的举措,都会产生明显的套利空间,而资格标准仍不透明。
接下来会发生什么
这个故事首见于日本媒体的事实本身便是一个信号——PC Watch报道美国公司的里程碑——意味着AI发展不再沿单一方向、通过单一生态系统流动。日本的科技媒体以如今定义全球科技新闻的速度与精确性,报道了Astra的基准数据。
OpenAI已触及一个它尚未正式承认的门槛:一款既通过了我们最接近AGI代理测试、又触发了自身最严厉安全警报的模型。其意义有三。
首先,AGI的定义正在我们脚下发生转变。在一个专为区分窄AI与通用智能而设计的基准上获得99.9%的分数,意味着该术语已不再具有前瞻性——对至少一个系统而言,它已成为描述性词汇。
其次,安全框架正承受压力。Critical分类是一种诚实的承认,但也意味着护栏是反应性的而非预防性的。OpenAI是在事后才发现风险,而非事前。
第三,竞争格局已重新洗牌。Claude在整体推理与可靠性方面仍领先。但Astra的效率提升与数学贡献表明,下一轮竞争将在实用性上取胜,而非仅仅取决于基准分数。企业将更少关注谁占据排行榜榜首,更多关注谁能更快、更便宜地完成实际工作。
GPT-6 Astra已到来。它是任何公司发布的最高智能产品,同时也是——以OpenAI自身标准而言——最可怕的产品。前方的赛跑不再只是构建更聪明的东西,而是当它已经过于聪明、难以完全掌控时,我们该如何应对。