英伟达 Vera CPU:3.3GHz 完全合理
英伟达的 Vera CPU 运行在朴实的 3.3GHz——但主频背后隐藏的是架构取舍、垂直整合,以及这家公司真正打算竞争的方向。
那个看起来不对、但其实没错的数字
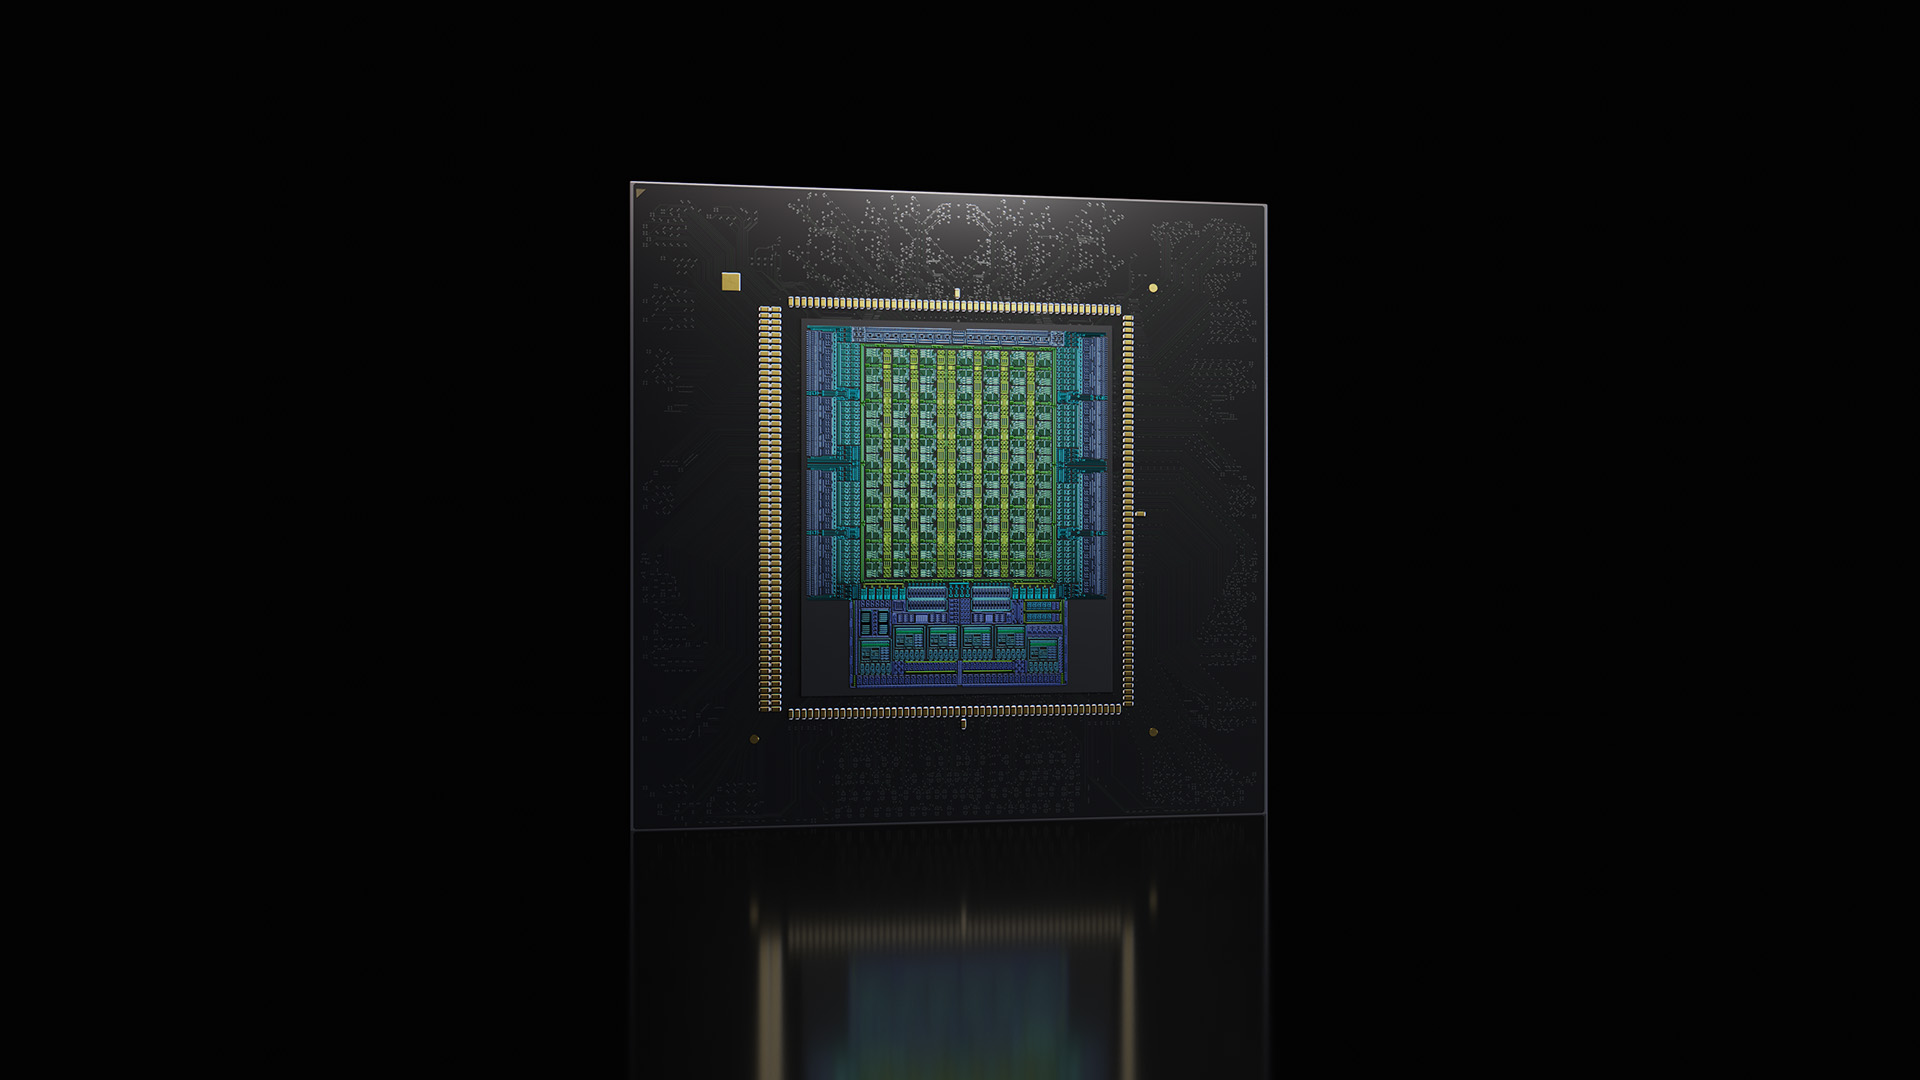
NVIDIA的Vera CPU最高仅3.3GHz。对于任何关注服务器处理器发布的人来说,这个数字显得相当可疑。Intel的Xeon系列在其最强核心上仍能达到4GHz,AMD的EPYC 9004系列也能稳稳超过3.8GHz。一个深谙GPU的公司(那种动辄2GHz以上、拥有数千核心的机器)打造的定制芯片,理应表现更好。
答案是,Vera从来就不是为了在时钟频率上取胜而设计的。它是为了在其他方面取胜,而芯片内部的数字说明了这一点。
NVIDIA于7月21日通过其技术博客公布了Vera的详细信息,随后在8月23日的Hot Chips大会上进一步展开。该芯片采用了NVIDIA自研的Olympus核心架构——这是继Grace之后公司的第二款定制CPU设计,Grace基于Arm的Neoverse V2蓝图构建。这一谱系最早可追溯到2011年的Project Denver计划,该计划先后诞生了Tegra K1、Tegra X2,以及最终基于Tegra X1衍生的Carmel芯片。
Vera值得拆解之处不在于历史,而在于它所代表的权衡。
宽核心,而非广核心
Olympus核心相当厚实。它每个周期最多能取指16条指令、解码10条,并通过18个端口发射。最后一个数据就是特别之处。大多数当代Arm核心发射约14到16个端口,Zen 5发射16个。Olympus的额外宽度来自两个设计选择:六个SVE2向量执行端口,排列为2×3配置,以及四个载荷-存储单元。
NVIDIA对SVE2做出了有意为之的选择。公司确认将坚守128位SVE2通道,而不是转向256位。原因在生态:大部分现有Arm软件仍以NEON为目标,转向更宽的向量格式将需要巨大的移植工作量。相反,NVIDIA增加了更多向量单元以提升总浮点吞吐量,同时不破坏软件栈。
结果是一个能够容纳超过1000个重排序缓冲区条目的核心——实际在飞行中的指令可能为500到600条。这对一个顺序前端设计来说规模惊人,而这伴随着代价。你无法建造一个如此宽的核心,并指望它在4GHz下运行而不把功耗推过250至450瓦服务器规格所允许的范围。
理论上TSMC的N3工艺可以支持更高频率。3.3GHz的上限说明设计只是耗尽了余量——不是因为工艺节点,而是因为宽度。
更难的部分:空间多线程
这才是Vera设计真正有趣的地方。NVIDIA称其为空间多线程。这个概念足够直白:每个硬件线程拥有独立的取指和解码路径、独立的分支预测器,实质上是一个独立的前端。后端——执行单元、缓存、内存控制器——则是共享的。
在实践中,这意味着一个运行计算密集型工作负载的线程不会通过霸占解码器或干扰分支预测器来阻塞另一个线程。NVIDIA展示的SPECint 2026数据表明,运行GB_SR或Stream等工作负载的第二个线程对第一个线程性能的影响,远小于传统SMT实现。
但需要注意,这种安排在两个线程在不同内存空间中执行不同任务时效果最佳。SMT传统上在线程共享内存、争夺相同资源时表现最好——其思路是,一个线程的缓存未命中可以用另一个线程的执行来隐藏。空间多线程颠覆了这一假设,它针对的是混合负载,而非同一程序的多个实例。
此设计还引出了一个NVIDIA没有直接回答的问题:如果主流服务器负载仍是以单线程或对称多线程为主,重复前端在面积和功耗上付出了多大代价?答案可能是,NVIDIA正在为一个AI编排负载(正是Deepinfra基准测试中展示的那种异构任务组合)主导服务器利用模式的未来而构建。
扭曲所有基准测试的内存优势
Vera 88C在16个通道上使用SOCAMM2,内存带宽额定为每秒1.2太字节。AMD EPYC 9755在12个通道上使用DDR5-6400,带宽约为每秒614吉字节。接近两倍的差距。
这至关重要。任何涉及内存访问的基准测试——几乎每个真实的服务器基准测试都是如此——都将在原始数字上有利于Vera,即使每周期架构相当。Vera比EPYC 9755快1.2到1.8倍的SPECint数据是真实的测量结果,但这是完整系统的测量,而非纯CPU的测量。内存子系统承担了大量的繁重工作。
这也是为什么比较感觉有点刻意安排的原因。EPYC 9755是一台DDR5机器。真正的竞争对手——AMD下一代Venice部分和Intel的Diamond Rapids——也将使用先进的内存接口。当这些芯片面世时,带宽差距会大幅收窄,问题就变成Olympus核心的IPC优势是否足够大,能够独自支撑整个比较。
这揭示了NVIDIA的什么战略
Vera最重要的不是硅片本身,而是信号。
NVIDIA正在打造自己的CPU,以掌控从指令集到内存接口再到GPU互联的整个堆栈。Vera内部的可扩展一致性架构反映了NVLink的思路:一种针对NVIDIA预期主导的负载优化的私有互联。SOCAMM2内存标准是垂直整合的另一层——只有配合定制处理器才有意义的定制内存模块。
这之所以重要,是因为AI训练和推理市场正朝着CPU、内存和GPU必须比任何现成x86平台所能实现的更快通信的集成系统方向发展。独立CPU设计商可以通过协同优化整个链路而受益。Intel和AMD可以在内部做类似的事情,但它们必须服务于需求各异的更广泛市场。NVIDIA的焦点更窄,而当负载可预测时,这种专注就成为一种优势。
Vera设计也澄清了NVIDIA不试图做什么。这不是一款旨在取代每种负载下EPYC或Xeon的通用服务器CPU。它是针对围绕大规模AI训练的特定计算模式而设计的CPU——编排、数据移动、预处理和模型管理。NVIDIA发布的基准测试(无头浏览器吞吐量、编译速度、代理编排延迟)都指向这一方向。
真正的考验还在后头
Vera预计将于2026年底随新一代GPU架构一同出货。实际的负载基准测试——训练吞吐量、推理延迟、每token成本对比——在撰写时尚未公布。从NVIDIA发布公告页面链接的白皮书截至文章发表时仍返回404错误。
我们所知道的是,一款拥有巨大重排序缓冲区、空间多线程和1.2TB/s内存带宽的3.3GHz定制CPU并非偶然。这是一家公司选择宽度而非速度、带宽而非时钟、整合而非兼容性的结果。问题在于,这一优先级组合是否与AI基础设施市场的走向一致——以及AMD和Intel是否能在这一架构取得太多优势之前追平整合能力。
时钟速度是干扰项,战略才是故事所在。