三星与AMD的内存合作或重新定义AI硬件
三星正与AMD联手推出HBM5和基于CXL的内存扩展方案,有望缓解AI芯片的瓶颈问题。关键不在于这能否成功,而在于谁将最先受益。
三星刚刚改写了AI芯片的内存游戏规则
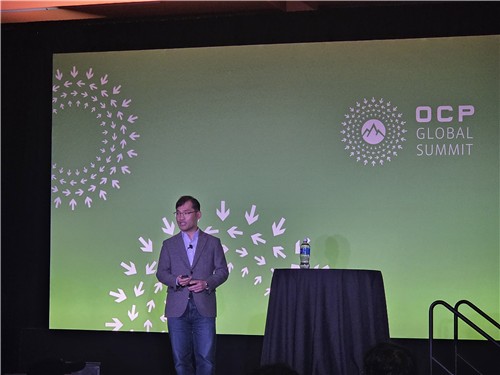
本周半导体行业步履匆匆,但对下一代AI系统构建者而言,节奏仍显不足。三星在圣何塞举办的OCP全球峰会上公布了一项三线并进的内存战略。新闻稿虽披着常规产品路线图的套路,但真正耐人寻味的是,它清晰折射出整个行业目前究竟卡在何处。
一个此前未被充分热议的问题
AI模型不仅仅在规模上膨胀,它们对内存的要求正迈向带宽单一维度无法解决的深水区。正如高级副总裁沈浩俊在峰会上所指出的,推理负载——而不仅仅是训练——正推动着KV缓存需求与数据量的激增,将瓶颈从单纯的带宽推向了纯粹的容量领域。即便你拥有全球最快的内存,若无法容纳工作集,再快的速度也无济于事。
这才是问题的关键。行业曾花费数年追逐带宽,如今却撞上了一堵容量之墙。三星的三大策略——HBM5提速、CXL内存扩展与持久化存储——本质上是一纸坦诚:没有任何单一技术能彻底解决AI内存难题。
HBM5其实是相对容易的一环
三星HBM5的发布引人关注,却在意料之中。高带宽内存本就走在一条可预期的迭代轨道上,三星与SK海力士的较量也已持续多时。真正的问题从来不是HBM5能否提供更高带宽——事实确是如此——而是三星能否以足够的速度拉升产能,去追赶当前远超供应量的需求缺口。
更有趣的是对zHBM的提及,它将内存直接堆叠在计算芯片之上。这种方式缩短了数据在内存与处理器之间的传输距离,实质上挽回了容量限制所带来的部分带宽折损。这是针对软件驱动型问题的硬件方案,意味着只有当芯片架构支持时,它才能真正发挥作用。
PIM(存内计算)是三者中最大胆的一项。在存储阵列内部直接执行简单计算的概念早已存在数十年,却从未真正走向主流。如果三星能够将PIM规模化落地,它将改写当前主导生产环境AI系统的推理负载性能天平。
与AMD的CXL合作才是真正看点
三星与AMD在基于CXL的内存扩展方面的合作,正是这份公告区别于其他所有内存路线图的核心亮点。CXL(Compute Express Link,计算加速链接)允许系统将内存模块独立于处理器进行挂载,实质上是将内存转化为一种可池化、可扩展、跨负载共享的商品化资源。
这对AI数据中心至关重要,因为它将内存容量与算力彻底解耦。目前,想要更多内存,就必须购买集成HBM的更昂贵的加速卡。而有了CXL内存模块——三星的CMM-D(CXL内存模块-DRAM)——你可以单独扩容内存,有望以更低成本、更高灵活性实现目标。
此番合作对双方均具战略深意。AMD的MI300系列虽已集成海量HBM,但公司同时也为其EPYC处理器布局了CXL支持。对三星而言,搭上这艘头部GPU厂商的快船,能在CXL内存模块赛道抢占先机;对AMD而言,则无需自建产线即可提前接入对手的内存技术。
然而鲜少被充分讨论的一点是:基于CXL的内存扩展只有在内存层级调度得当的前提下才能奏效。引入远端内存必然带来延迟。对于本就头疼数据传输的训练负载而言,缺乏精细调校的CXL方案反而可能拖累性能。谁能率先让CXL内存对GPU呈现出近乎本地的响应速度,谁就能掌握实质性优势。
持久化存储补齐战略三角
三星的第三大支柱——面向AI数据持久化的新一代企业级SSD——乍看之下是本次公告中最不起眼的一环,但从长远观之,它实则最为关键。AI推理从来不只有模型运行,更涵盖模型服务化、结果缓存、跨会话KV状态管理,以及PB级训练数据的海量存储。
易失性内存(DRAM/HBM)与非易失性存储(SSD)之间的断层,正是数据停留最久、延迟损耗最严重的地带。三星全力进军持久化存储,押注的是一个核心判断:未来AI数据中心的竞争力,将取决于数据在整个存储层级间的流转效率,而非仅仅是GPU的处理速度。
这里也是经济账上最为有趣的地方。针对AI优化工作负载的企业级SSD是一门高利润生意,而三星在此领域的步伐一直慢于Solidigm(英特尔与铠侠的合资公司)。向下一代AI优化存储的发力,有望迫使市场做出竞争性回应,最终惠及采购方。
谁胜谁负
那些过去苦于HBM供应紧缺的AI系统构建者,损失反而较小——甚至可能从中受益。若三星与AMD的CXL方案成功落地,便等于开辟了一条绕开少数厂商垄断HBM供应链的内存扩容新路。
SK海力士目前仍是英伟达顶级芯片的首选HBM供应商,但正面临间接压力。并非因为三星的CXL会取代HBM——事实并非如此——而是因为围绕AI内存的讨论重心,正在从“谁拥有最快的HBM”转向“谁能提供最高效的内存层级架构”。这是一个更广阔、也可能更具竞争性的赛道。
三星的公告中并未提及英伟达,这本身就已说明一切。英伟达在AI加速卡领域的统治地位,建立在GPU与HBM深度绑定的基础之上。基于CXL的内存扩展本质上是一种截然不同的架构;虽然英伟达完全可以采纳,但这反而会削弱其最贵GPU的核心卖点——正因为它们搭载了最多的HBM。
数据中心运营商是短期内的明确赢家。更多的内存容量、更灵活的资源配置方式,以及潜在的更低总体拥有成本(TCO)。问题在于,三星能否按路线图足够快地兑现承诺,真正产生影响力。
时间表比技术本身更重要
三星的OCP公告是一份路线图,而非产品发布会。HBM5样品预计于今年晚些时候推出,2027年进入量产。与AMD合作的CXL内存模块仍处于演示阶段。持久化存储策略则是渐进式改进,而非革命性突破。
此次公告的意义不在于单项技术——它们皆是既有方向的渐进式优化——而在于协同布局。三星明确将内存扩展定位为一个需要多项方案协同配合的系统级问题。相较于业界此前的认知,这显示出对AI硬件挑战更为成熟的把握。
那些将此事视为HBM、CXL与持久化存储之间零和竞争的公司,必将误读格局。AI内存瓶颈并未消失,而是在演进。三星的策略表明,它押注的赢家将是那些能够在整个内存层级中实现全局优化的玩家,而非死盯单一规格的公司。
这是一个值得密切关注的命题——它或许将在未来数年内重塑整个行业对AI硬件瓶颈的认知。