三星新芯片绕过英伟达的AI垄断
三星的LPDDR5X-PIM芯片可在内存内部进行计算,而非来回搬运数据——这一举措有望打破英伟达在边缘AI领域的统治地位。这款芯片对手机、电脑及整个AI硬件竞赛意味着什么?
一块让数据在原地计算的芯片
三星刚刚完成了一件大多数半导体公司认为不可能实现的事——无需推倒重来:它在外观与标准内存模块无异的封装内嵌入了处理逻辑,并让其在真实 AI 模型上的运行速度超越了现有替代方案。这款产品的名称是 LPDDR5X-PIM,于斯坦福大学举办的 Hot Chips 2026 大会上亮相。
PIM 的全称是 Processing-In-Memory(存算一体)。理念看似直接,执行难度却极高。传统架构需要在独立的存储芯片和处理器之间来回搬运数据——工程师们将这一困境称为"冯·诺依曼瓶颈"。每当 AI 模型需要一处权重,该权重就必须穿越总线、穿过控制器、进入计算单元,再原路返回。搬运数据的能耗成本,往往超过了计算本身。
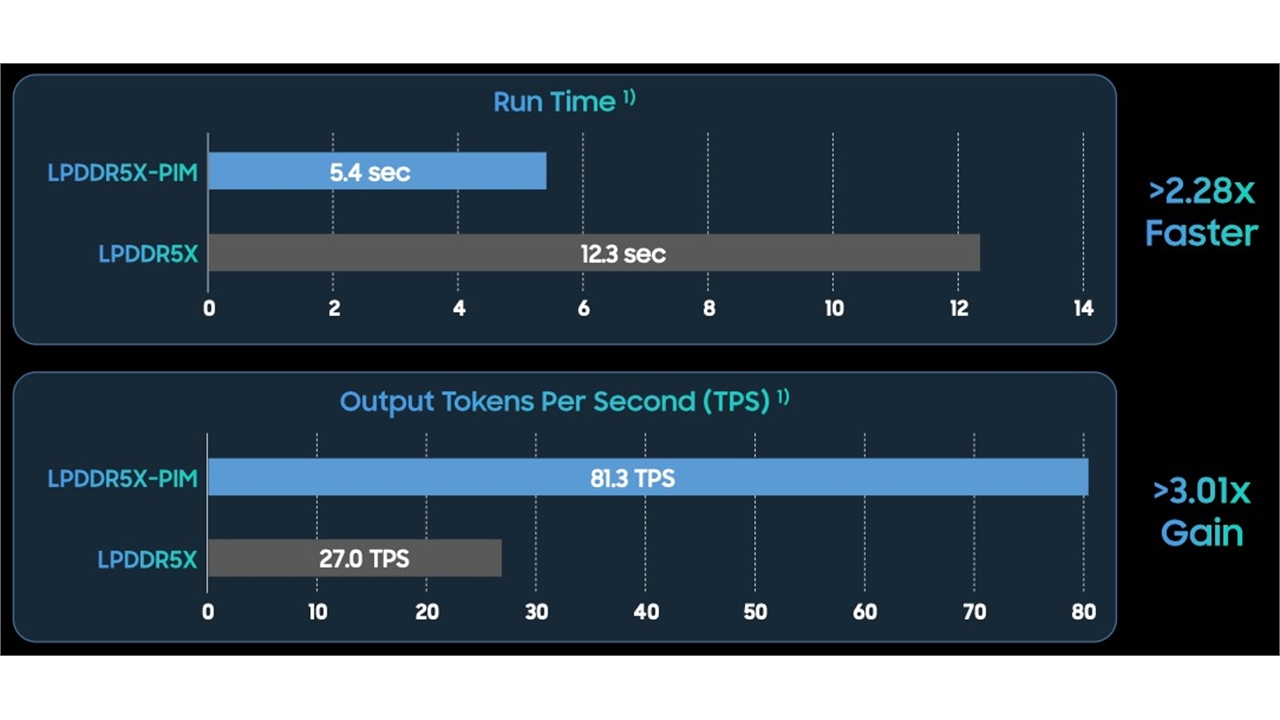
三星的解法是将计算直接折叠进存储晶圆之中。数据不需要移动。计算就发生在数据驻留的原地。根据三星自己的测量数据,相比传统 LPDDR5X,在 Meta 的 Llama 3.1 模型上推理速度提升了约 2.3 倍。Token 吞吐量达到了标准内存的三倍。这些不是边际改进——它们是足以重塑系统架构决策的那种跃升。
这绝非又一次平庸的内存发布
存算是三星的老本行。DRAM 和 NAND Flash 是其营收的压舱石。但单纯的存储已沦为红海战场,中国的长鑫存储和长江存储不断压低价格、压缩利润空间。向上游 Compute 延伸——踏入计算——能帮助三星抵御这种挤压。
更重要的是,PIM 将三星置于 AI 硬件战争正在涌向的精确位置:边缘端。Nvidia 的统治根基是数据中心 GPU。H100、Blackwell 平台、NVLink 互联架构——这些为大规模模型训练和规模化服务而设计。它们同时是能耗大户,价格高昂,体积庞大。你无法把一台数据中心 GPU 塞进手机。
端侧 AI 是下一个前沿阵地。苹果依靠自家 Neural Engine 运转。Google 大力推动 Tensor 芯片。高通和联发科则在打造内置 AI 加速器的移动处理器。它们谁都不希望依赖 Nvidia 来承担定义下一代智能手机、笔记本电脑和 IoT 设备推理工作量的重任。三星的 PIM 芯片提供了一条无需采纳竞争对手加速器架构的路径。
兼容性细节在此处至关重要。三星设计 LPDDR5X-PIM 时使其封装尺寸和引脚布局与现有 LPDDR5X 模块完全一致。手机厂商无需重新设计主板就能替换内存。这大幅降低了采用门槛。Nvidia 的 GPU 需要全新的 PCB 布局、全新的散热方案、全新的软件栈。三星的芯片几乎只要求更换一颗零件。
对 AI 硬件竞赛的战略影响
这是 Nvidia 应该高度重视的地方。这家公司的护城河始终在于软件——CUDA——以及 GPU 集群的绝对性能优势。但 CUDA 运行在 GPU 之上,而非存储芯片之上。如果设备厂商开始大规模部署存内计算来处理推理负载,它们正在构建一条完全绕开 Nvidia 的并行 AI 栈。三星实际上正在奋力将内存转变为一块通用 AI 加速器,且无需迫使客户抛弃现有设计方案。
与此同时,三星正在为下一代产品奠定基础。公司确认已启动 LPDDR6-PIM 的标准化工作,这意味着它不仅仅是在出货一款产品——更是在塑造整个行业将遵循的技术规范。在半导体领域,制定标准就是一种权力。英特尔曾为 CPU 插槽的教训付出惨重代价。AMD 曾借 PCIe 标准确立了自己的地位。三星正试图从内存角度复刻这一路径。
三星随发布同步推出的 SDK 和模拟器同样印证了这种战略直觉。没有工具链,PIM 毫无实用价值。开发者需要知道如何把 AI 层映射到内存驻留的计算单元中。三星正在与硬件同步构建这套工具链,这正是存算一体架构走出实验室演示、走向实用的唯一路径。
谁赢谁输,以及下一步
手机和 PC 厂商最先获益。他们在不绑定新的加速器供应商的前提下获得了端侧 AI 的性能提升。这让他们在与高通、苹果、联发科的谈判中拥有了筹码。同时也是保险——万一 GPU 供应再度收紧或定价朝不利方向转变。
三星其次获益。它从零部件供应商跃升为 AI 平台参与者。利润率得到改善,品牌定位也在 SK 海力士面前形成压制——截至目前,SK 海力士的商用管线中没有对等的 PIM 产品。
Nvidia 在数据中心层面损失最少,但面临来自边缘端的长期侵蚀风险。该公司依然主导着训练和高阶推理市场。但如果 LPDDR-PIM 在 2027–2028 年成为移动端和笔记本电脑 AI 的默认方案,Nvidia 在这些细分市场的存在感将逐步萎缩。今天这还构不成生存级威胁。它是一种战略漂移。
真正的考验在于落地。Hot Chips 大会上的演示是一回事,消费设备中的大规模量产是另一回事。三星表示产品已具备部署条件,但核心问题在于:主要 OEM 是否会将其整合进下一代旗舰机型?Llama 3.1 基准测试数据令人振奋,但真实工作负载——混合精度、变长序列、多模态路由——优化难度要高得多。
有一点是明确的:三星在内存领域已不再处于防守姿态。它正在主动攻击定义了 AI 硬件数十年的那个瓶颈,而且使用的是每个 AI 系统都已经包含的那一种组件。