超大规模供应商的电力交易正在重塑美国电网与气候
一项新发表的《自然》研究量化了美国超大型数据中心的惊人耗电量,并揭示其电力采购合同如何重塑区域电网、引发对清洁能源目标的重新审视。
AI 繁荣背后的隐性代价
由哈佛大学陈曾熙公共卫生学院研究人员领衔的一个团队,绘制出了迄今最为精细的美国超大规模数据中心电力消耗图谱——以及伴随这种需求而来的碳排放成本。
该研究发表在《自然·可持续性》(Nature Sustainability)上,估算了美国本土各设施级别的用电量及相应的二氧化碳排放量,并按州和输电平衡区进行了细分。这一结果对政策制定者提出了直白的挑战:此前他们假定企业清洁电力采购能够吸收人工智能驱动的电力需求激增,且不会导致区域电网出现断裂。
数据给出的答案是否定的。并非所有地方都能做到,也来不及及时弥补。
研究实际揭示了什么
作者构建了一个基于商业设施记录训练的统计容量模型,并使用环保署 eGRID2023 排放因子对其进行校准。随后,他们以一个使用率为 58%(μ = 0.58)的中心情景假设来预测电力需求,这也是随论文一并发布 headlines 总量所使用的基准线。
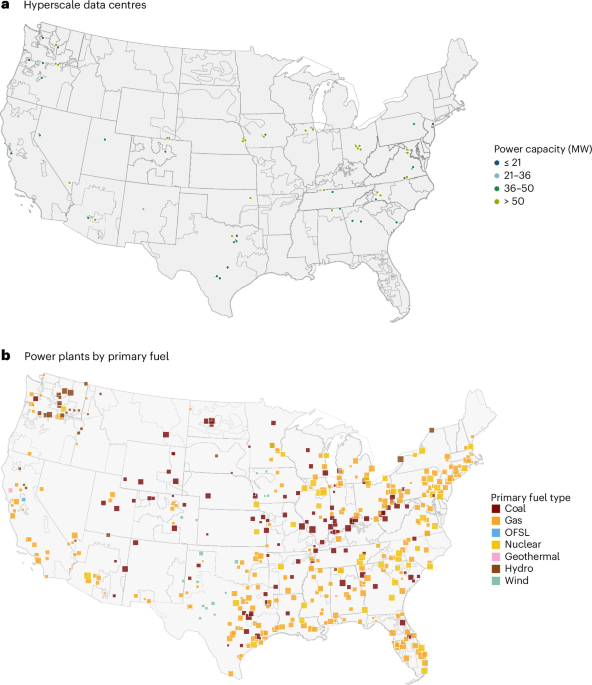
结果呈现出一幅从县级到州级的地图,标明了最大负荷所在的位置、每度电在其本地燃料结构中所隐藏的热量,以及哪些输电平衡区已处于高负荷运行状态。
这些数据并不隐晦。超大规模设施正集中布局于电网结构从重度依赖煤炭到可再生能源组合已经紧张的各类州份。当这些设施签署长期购电协议时,它们通常就地取用现成的供应资源;除非新的输电线路能够将远方的风能或太阳能远距离输送过来。而正是这种输配缺口,让碳核算变得模糊不清。
赢家与输家
赢家显而易见: hyperscalers(超大规模科技商)获得了可预期的容量,价格往往低于现货市场的波动幅度,并在电网接入竞争激增之际锁定了供应。
输家则不那么显眼,但后果更为深远。在同一服务区域内、与新建超大型园区相邻的家庭和小企业可能面临更长的并网排队时间、更高的本地峰值电价,以及在公用事业监管机构裁量下出现的交叉补贴——即工业买家以低价获取电力,而居民用户却为基础设施升级买单。
在可再生能源渗透率高但调峰能力有限的输电平衡区内,hyperscaler 的需求增长可能迫使公用事业公司延长燃气调峰电站的使用寿命,而不是将其退役。气候账本就此翻转:正是用于稳定间歇性可再生能源的那些资产,若 hyperscaler 持续拉高需求的速度快于储能设施的部署速度,就会沦为搁浅负债。
为何清洁能源叙事经不起推敲
据彭博新能源财经(BloombergNEF)数据,企业清洁电力采购在 2023 年增长了 12%,创下历史新高。这一数字听起来令人印象深刻,但当它与本研究中展示的各州排放强度叠加对照时,便显露出裂痕。
一家在中部地区签署风力购电协议的 hyperscaler 在纸面上完全可以报告零范围二排放。但如果这股新增风电仅仅挤占了现有零售负荷,而非带来真正的增量可再生能源发电量,那么对该输电平衡区的碳排放强度边际影响几乎可以忽略不计。与此同时,附近的一家化石燃料电厂仍继续运行以服务其他客户。其净结果是重复计算问题:两套减排量声称指向同一批兆瓦小时。
这正是碳核算专家如 Brander(2022)多年警告过的“归因—后果差距”。《自然》这项研究并未解决这一问题,但它让后果变得可见。按州、按输电平衡区逐一对照,“已报告清洁能源采购”与“电网实际脱碳进展”之间的差距足以吞噬数年的净零目标进度。
压力点正在何处形成
若干区域尤为突出。那些既有的数据中心密度较高、燃料结构中对煤炭敞口较大的输电平衡区,将在每增加一兆瓦承诺容量时迎来最大的绝对排放增量。相反,拥有充裕可再生能源容量和充足输电余量的平衡区,则能以相对较小的增量碳成本吸纳新增需求。
该研究的公开汇总导出数据允许任何人核验各区域各自落入哪一档分类。它还揭示了一个令人不适的事实:这些类别在全国范围内并非均匀分布。一些州已汇聚了超大规模园区集群;另一些州则仍在萌芽阶段。各州监管政策的分歧将决定下一轮建设浪潮是加速还是完全阻碍碳目标实现。
接下来会发生什么
短期内可能出现三项发展。
首先,监管机构将面对愈发强烈的强制设施级别披露要求。美国已要求加密货币挖矿业务披露能耗情况,而数据中心目前处于一个灰色地带——拜登政府一直在考虑加以收紧。建立透明、可审计的报告制度,将使本研究达到的颗粒度成为常态而非例外。
其次,处于紧张状态的输电平衡区内的公用事业公司会开始差异化定价电网接入。预计将出现容量费、需量基础电价,以及反映真实系统成本而非历史统一费率的并网排队机制。
第三,行业参与者将尝试运营层面的调整以降低实时需求峰值。包括加州大学伯克利分校及独立研究机构在内的相关研究正在探索此类技术,例如将大语言模型的训练任务转移到电网碳强度较低的时段,并根据廉价可再生发电的动态变化灵活调整工作负载位置。这些方法均难以轻易规模化,也均不能消除基荷问题。但它们释放出一个信号:若 AI 基础设施无法在展示原始能力提升的同时证明其在排放强度上的可衡量进步,业界已意识到这将构成信誉风险。
底线
《自然》此项研究的价值不在于制造危机——生成式 AI 基础设施的电力需求从来就不是秘密——而在于它量化了一个关键变量:这种需求如何在今天的电网中转化为具体、具地域特征的碳排放。
如果目标是真正的脱碳,而非投资组合账面核算,那么结论就很直接。清洁能源目标必须依赖新增可再生能源产出与新增需求的增量匹配,而不能依靠事后解释称旧有清洁采购 Somehow 覆盖了新负荷。在政策框架强制执行这一关联之前,人工智能带来的电力需求激增将继续给区域电网施压,并推迟那些最需要帮助的州份兑现其气候承诺。