GPT-6 Astra的AGI定位为何改变一切
OpenAI的GPT-6 Astra并非又一款普通模型更新——而是有意将AI重新定位为任务执行者,而非聊天机器人。其定价、基准测试表现,以及日本媒体对AGI主张的严肃对待,揭示了一项可能重塑竞争格局的战略。
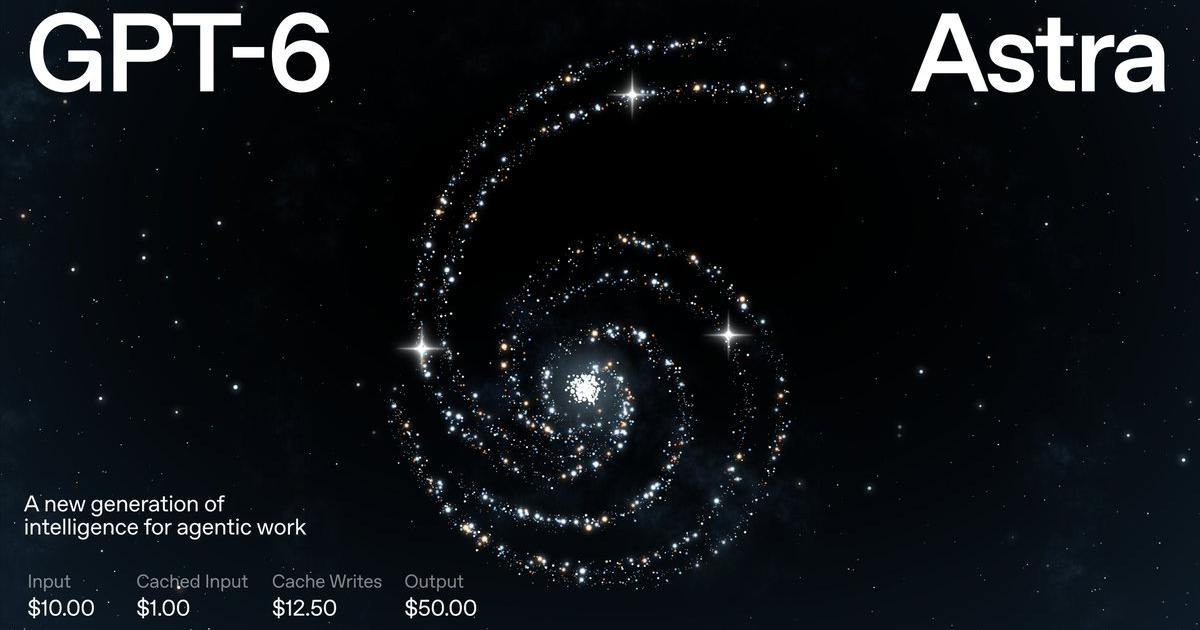
GPT-6 Astra并非产品发布,而是一次定位举措。
9月3日,OpenAI发布了GPT-6 Astra,并配发了一段视频,展现的远比"更智能的聊天机器人"野心更大。人们面对一块大屏幕,AI将语音实时转化为Blender三维模型、游戏资产、可打印的3D实物摆在真实的桌面上——还生成了跳蚤市场上的商品 listings——全程无需敲击一个键盘按键。格雷格·布罗克曼称这是"欢迎来到AGI时代的序幕。"
日本科技媒体,尤其是《Gizmodo Japan》,认真对待了这一说法,将Astra定位为文化的拐点而非渐进式升级。这一解读很重要。它表明,全球最懂科技的市场之一如何理解OpenAI的信号——以及这种理解在其他市场是否同样站得住脚。
基准测试讲了一个与公关不同的故事
先抛开发布视频不谈。在ARC-AGI 3——与AGI主张关联最直接的基准测试——Astra得分63%。OpenAI自己的测试工具将其推至99%,但文章本身也指出,这个最高分是在特殊条件下取得的,技术上属于"未评估"范畴。这是里程碑与概念验证之间的区别。
在AutomationBench上,Astra从18.1%跃升至41.4%。OSWorld从65.7%提升至72.6%,任务完成时间从约75分钟降至40分钟。这些都是多步任务执行方面的真实进步,但它们并非人类级别通用智能的证据。
Artificial Analysis的综合评分为Astra打61分——与GPT-5.6 Sol持平。Anthropic的竞品Claude Fable 5.1得分为66分。按传统指标来看,Astra并非市场上最强的模型。
那为什么用AGI的话语体系?因为Astra针对特定场景做了优化:需要串联多个工具的长周期多步任务。它在代码、科学或推理方面并没有全面超越对手。它在的是那种真正占据知识工作者精力的工作——将一条提示词转化为跨多个应用的完整成果。
这种优化是有代价的。Astra在自主工作流执行上获得优势,却在专业推理任务上让出了阵地。它在ARC-AGI 3上的63%评分尚可,但算不上领先——远低于一些研究者谨慎关联到真正通用能力的80%以上阈值。该模型并没有比人类更快地解决新难题;它是在更可靠地串接已有工具。这一区分至关重要。
价格信号本身就是战略的一部分
Astra的API定价相当高昂:每百万输入token 10美元,每百万输出token 50美元。这是Sol价格的2.5倍。但token效率讲了另一个故事。代码生成所用的token大约是Sol的三分之一即可达到可比效果。高溢价是一种故意的定位——Astra被定位为昂贵的、高可靠性的选项,面向那些过去需要人类操作员坐在键盘前的工作。
这是OpenAI希望企业在无法承受失误时运行的模型。来源文章中"困难工作获得高级执行"的表述是准确的。OpenAI不是在拼价格,而是在靠自主任务完成的可靠性来赢得信任。
定价策略向市场发送了一个次级信号。通过收取溢价,OpenAI实际上在说:Astra的价值不在于原始智能,而在于减少人类监督的成本。原本需要两到三名初级开发人员跟进多步项目的公司,现在只需要一个人加Astra就足够了。即便单价更高,账也算得过来。这才是真正的卖点,而且直指那些因可靠性门槛未达标而迟迟未采纳AI的企业。
日本媒体的解读为何具有全球意义
《Gizmodo Japan》的报道将AGI叙事视为实质内容而非营销话术,这一点值得注意,因为日本科技媒体相对于西方同行,对美国AI炒作周期往往更加谨慎。当东京的媒体开始认真对待AGI里程碑时,意味着能力叙事正在发生转变,而全球读者应当关注这一趋势。
更深层的含义是:如果日本市场——以及跟随其节奏的其他市场,包括韩国和东南亚部分地区——开始围绕自主任务执行而非聊天能力来定价AI的采用,竞争格局就会发生变化。胜出的不会是基准分数最高的那个模型,而是操作者信任它能够无人监督完成任务的那个。
日本商业文化对可靠性和错误最小化有着非同寻常的重视。在一个偶尔出现幻觉的报告撰写任务中,模型犯些错在创意语境下或许可以容忍,但在流程纪律即竞争优势的市场里,这种容忍度会瞬间蒸发。如果OpenAI能将Astra定位为"不会因出错而拖垮工作流"的模型,它就能抢占此前几代AI工具无法触达的市场细分。这不是基准测试的故事,而是部署的故事。
Anthropic的回应才是真正的看点
Claude Fable 5.1目前在综合评分上领先。但Astra在决定企业部署的关键维度上领先:自主完成长链条多步工作流的能力。Anthropic有充分的动机来反驳这一叙事,也有充分的理由避开OpenAI如此强势使用的AGI话语。
Anthropic的定位始终锚定于安全性和可解释性。若与OpenAI在AGI主张上正面交锋,等于在对手的主场作战。更为明智的策略是强化对比:Fable 5.1是你值得信赖的模型,因为你能够理解它做出每个决策的理由;Astra是你使用的模型,因为它在你还没意识到之前就已经把活儿干完了。这是两种截然不同的价值主张,而Anthropic深知自己的受众更偏好前者——至少在公开场合。
竞争的关键不在于哪个模型在ARC-AGI-3上得分更高,而在于哪家公司能说服企业:他们的AI可以替代人类工作流,而不只是辅助它。Astra是OpenAI第一个明确为此过渡而设计的模型。Fable 5.1在原始智能基准上仍可能略胜一筹,但Astra被定位为基础设施,而非工具。
隐藏指标:人类监督的缩减
双方都没有直接衡量一个将真正决定市场份额的指标:一个模型在典型工作流中消除了多少人类干预环节。Astra在OSWorld上的提升——将任务时间从75分钟降至40分钟——表明它删除了以往在多步项目中积累的大约三分之二的监督触点。这不是渐进式改进,而是结构性改变。
当一个模型能够从提示词直接到部署成果,而无需在每个步骤中停顿等待人类确认时,AI采用的经济逻辑就会发生翻转。问题不再变成"这个模型能否帮我?“而是"我还需要一个人在回路里吗?“这个问题的答案,正是企业愿意为之买单的东西——不管OpenAI是否承认这一点。
下一步会发生什么
OpenAI将在数日内将Astra向ChatGPT Plus、Pro、Business和Enterprise用户开放。ARC Prize排行榜将持续更新,Anthropic也将推出其下一代迭代。但真正的考验不会来自基准测试,而将来自部署数据——多少公司真正将Astra从试点推向生产,以及人类监督的减少是否能随着时间的推移证明溢价的合理性。
如果日本及类似市场开始以自主性而非智能来衡量AI的价值,整个AGI竞赛的叙事框架都会发生偏移。我们见证的不仅仅是一场构建最聪明模型的竞争,而是一场构建最可靠模型的竞争。而可靠性并不会清晰地体现在排行榜上——它体现在工作流程是否能在无需人类介入纠正错误的情況下顺利完成。
OpenAI正押注市场会为这种押注买单。价格、基准测试、AGI话语——一切指向同一个方向。问题是,Anthropic和其余竞争者会跟进而去,还是会加码另一种关于什么才算重要的定义。谁定义了指标,谁就赢得市场。跟随者则输掉市场。