El cofundador de ChatGPT dice que la era de los LLM ha terminado. Él construyó la alternativa.
Diogo Almeida, co inventor de ChatGPT, afirma que el paradigma token a token está alcanzando sus límites. Su nuevo modelo Jev claims rendimiento nivel GPT-5.6 con una fracción del costo al abandonar por completo la generación autoregresiva. Qué es lo que realmente cambia y por qué importa para todos los que construyen con IA.
La pregunta que llevó a un cofundador de ChatGPT a salir por la puerta
Diogo Almeida pasó años en OpenAI ayudando a construir ChatGPT. Cuando se fue, no lanzó otra startup persiguiendo mejores prompts. Construyó algo deliberadamente distinto.
La frustración de Almeida era sencilla y, a la luz de los hechos, poco discutida: los modelos de chat superhumanos no conducen a la AGI. Ni a nada cercano. La propia arquitectura —el motor de predicción del siguiente token que se volvió el estándar para cada laboratorio de IA importante— parece ser un cuello de botella, no un puente.
Dos años de trabajo en secreto después, está lanzando Jev, el primer “Modelo System One” de su empresa TypeSafe AI. No es un LLM. Esa distinción importa más de lo que sugiere el comunicado de prensa.
Qué hace diferente a Jev
Los LLMs estándar generan salida un token a la vez, de izquierda a derecha, en una cadena secuencial. Cada token depende de todos los tokens anteriores. Por eso pueden escribir novelas, código y documentos estructurados: esencialmente continúan texto. Pero también por eso son lentos y costosos de ejecutar. La computación se acumula con cada token generado.
Jev fue construido para el propósito opuesto: no genera texto. Toma una especificación de tarea y produce una estructura predefinida en un solo paso paralelo. Piénsalo menos como un escritor y más como un compilador.
El propio Almeida señaló el paralelo histórico: reemplazar la computación secuencial por computación paralela es el mismo salto estructural que hizo que los Transformers superar a las RNN. La industria lo está haciendo de nuevo, pero dentro del paradigma transformer, en lugar de salirse de él.
Los números son agresivos
Esto es lo que publicó TypeSafe AI:
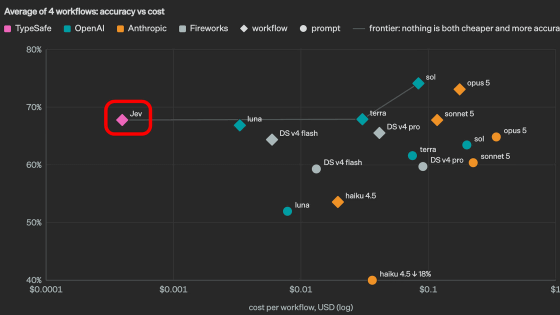
Costo de entrada: $0.042 por millón de tokens. Costo de salida: $0, descrito como “demasiado bajo para medir.”
En benchmarks comparados contra modelos de clase Terra de GPT-5.6, Jev afirma tener calidad equivalente a aproximadamente 1/100 del costo. Tasa de error en llamadas a herramientas: 0%. Cada salida incluye una puntuación de confianza.
La demostración incluyó una carrera de navegación en Wikipedia, partiendo de una página y alcanzando una página objetivo usando solo hipervínculos. Jev terminó más rápido que todos los modelos competidores, incluso aquellos ejecutándose en modo optimizado sin inferencia. Almeida atribuyó el margen en parte a la ausencia de acumulación de alucinaciones: cuando eliges entre cientos o miles de enlaces, los errores se multiplican con cada salto.
Quizá la demo más impactante: Jev jugó DOOM durante una hora con un costo de $7. Para comparar, ejecutar un agente comparable basado en LLM durante una hora de toma de decisiones continua típicamente cuesta mucho más, y sin garantía de acción coherente.
Quién gana, quién pierde
El ganador inmediato es cualquiera que construya agentes de IA para tareas estructuradas —generación de código, extracción de datos, orquestación de herramientas, agentes para juegos, flujos de trabajo automatizados—. Estas son exactamente las aplicaciones donde la matemática de costos por token de los LLMs ha sido el mayor punto de fricción. A $0.042 por millón de tokens de entrada con costo de salida cercano a cero, la economía se invierte.
El perdedor es cualquier producto o flujo de trabajo que fue precificado alrededor de los costos de inferencia de LLMs. Si tu modelo de negocio asumía que los usuarios pagarían por token para tareas de agentes autónomos, Jev desploma toda la estructura de costos en dos órdenes de magnitud. Eso no es competencia. Es un terremoto de mercado.
Pero hay un pero que vale la pena tomarse en serio.
La limitación es el trade-off
Jev no puede generar texto de propósito libre. Produce estructuras predefinidas. Eso significa que no es un reemplazo de propósito general para la interacción estilo ChatGPT. No escribirá una historia, redactará un correo electrónico ni se involucrará en razonamiento de forma libre.
Esta no es una deficiencia en la descripción, es la restricción de diseño. La misma arquitectura paralela que entrega velocidad y ventajas de costos significa que Jev opera en un ancho de banda de capacidad más estrecho. Está construido a medida para tareas donde el formato de salida se conoce de antemano y la corrección es medible.
Ese también es el motivo por el cual el encuadre de Almeida es cuidadoso: posiciona a Jev como complementario a los LLMs, no como reemplazo total. El futuro puede no ser uno u otro, sino una pila en capas —LLMs para razonamiento abierto y tareas creativas, modelos System One para ejecución—.
Qué señala esto
El hecho de que un cofundador de ChatGPT esté apostando públicamente en contra del paradigma autoregresivo es notable independientemente del rendimiento final de Jev. Señala que las personas que construyeron la arquitectura actual ven sus límites con mayor claridad que nadie, y no dudan en actuar sobre esa comprensión.
El método de entrenamiento RLCD al que Almeida hace referencia (aprendizaje por refuerzo vía decodificación restringida, según se reporta) es otro punto de datos. Sugiere que la próxima oleada de avances puede provenir no de escalar arquitecturas existentes, sino de paradigmas de entrenamiento fundamentalmente diferentes.
Los lectores tecnológicos coreanos y japoneses han estado siguiendo este ángulo desde hace tiempo. La adopción de IA empresarial en la región —particularmente en automatización y robótica— siempre ha sido más cómoda con sistemas estructurados y deterministas que con generadores de texto probabilísticos. Jev encaja en ese instinto.
Qué pasa después
Tres cosas que vigilar:
Primero, benchmarking independiente. Los números de TypeSafe AI son impresionantes pero autodeclarados. La industria necesitará validación de terceros antes de que los modelos de precios y las tesis de inversión se desplacen.
Segundo, patrones de integración. Si Jev maneja tareas estructuradas a escala y los LLMs manejan razonamiento abierto, la verdadera pregunta es cómo se conectan. La capa de middleware entre ellos se convierte en la nueva oportunidad de plataforma.
Tercero, la señal de costos. Incluso si las capacidades actuales de Jev son estrechas, la presión económica que genera es real. Cada desarrollador que vigila su factura de inferencia se preguntará: ¿por qué estoy usando un LLM para una tarea que un modelo System One podría hacer por 1/100 del precio? Esa pregunta se propaga rápido.
Almeida dejó OpenAI porque creía que el camino actual no lleva adonde necesitamos ir. Si tiene razón dependerá de lo que Jev pueda hacer una vez que terminen las demos y comiencen las cargas de trabajo reales.