DLSS 5 es una IA generativa disfrazada de escalado, y la prensa tecnológica en inglés se lo perdió
El DLSS 5 de NVIDIA es técnicamente un transformer de difusión de un solo paso en el espacio de píxeles, no un escalador convencional. Kenji Nishikawa de PC Watch fue el primer periodista en desentrañar su arquitectura, y la brecha entre el reporte técnico japonés e inglés sobre innovación en GPUs se amplía.
El artículo que la prensa tecnológica en inglés no ha replicado
NVIDIA reveló la arquitectura de DLSS 5 en septiembre de 2026. Lo que surgió no fue una mejora incremental de escalado, sino una reclasificación fundamental: DLSS 5 es, en su esencia, un difusor transformer de un solo paso en espacio de píxeles. Es un sintetizador de imágenes de inteligencia generativa que viste el uniforme de una técnica de supersampling.
Ningún medio importante en inglés publicó un análisis arquitectónico equivalente. La disección pública más exhausta proviene de Kenji Nishikawa, de PC Watch, cuya columna de septiembre, 「ディリスの正体は1回推論の画像生成AI」, traducida y reestructurada aquí para una audiencia internacional, representa el tipo de periodismo de arquitectura GPU que los medios especializados en inglés aún no han igualado.
La brecha importa. DLSS 5 no es una nota al pie en la hoja de ruta de NVIDIA. Es la declaración más audaz de la compañía hasta ahora sobre cómo los gráficos en tiempo real y la IA generativa convergen en una sola tubería. Y la infraestructura de periodismo para explicar esa convergencia a una audiencia global va rezagada.
Qué es DLSS 5 realmente
DLSS siempre significó Deep Learning Super Sampling. A través de DLSS 3.5, operaba como un motor de restauración: el renderizador del juego producía un frame de baja resolución o ruidoso, y DLSS lo reparaba usando información del G-Buffer, vectores de movimiento y frames anteriores.
DLSS 5 rompe esa línea genealógica. NVIDIA llama a su enfoque “Renderizado Neural Guiado por 3D”. El artículo lo denomina “Transformer de Difusión de un Solo Paso en Espacio de Píxeles”. En lenguaje claro: el modelo comienza con el frame crudo del juego, recibe únicamente datos de vectores de movimiento del frame anterior y produce una imagen fotorrealista en una sola pasada de inferencia.
Esta es la misma clase de arquitectura detrás de Stable Diffusion. La diferencia está en la estructura de restricciones. Un modelo de difusión de texto a imagen genera desde ruido guiado por un prompt. DLSS 5 genera desde un render en tiempo real guiado por estado temporal y geometría en espacio de píxeles. No desruido. No escala en el sentido convencional. Vuelve a renderizar una apariencia fotorrealista a partir de una imagen fuente de baja fidelidad.
Por qué la prensa en inglés dudó
Cuando NVIDIA presentó DLSS 5 en marzo de 2026, las imágenes comparativas de Resident Evil Requiem causaron controversia inmediata. El detalle de las sombras en el rostro de Grace parecía alterado de maneras que iban más allá del enfoque o la reducción de ruido. La discusión en foros y medios en inglés se centró en una sola pregunta: ¿es esto aceptable?
La pregunta estaba mal planteada. La controversia asumía que DLSS 5 era una herramienta de restauración de imágenes llevada demasiado lejos. No lo es. Es una herramienta de generación de imágenes restringida por información de escena 3D. La distinción lo cambia todo sobre cómo evaluarla.
La cobertura en inglés ha tratado a DLSS 5 hasta ahora como una variante controvertida del escalado existente. El Nishikawa de PC Watch lo trató como una nueva clase de tecnología de renderizado. Esa brecha de encuadre explica por qué la profundidad técnica de ambos cuerpos de reportaje diverge tan marcadamente.
La arquitectura, descifrada
Tres decisiones de diseño definen la ruptura de DLSS 5 con generaciones previas de DLSS.
Inferencia de un solo paso. Los modelos de difusión convencionales iteran cientos o miles de pasos de denoising. Las primeras optimizaciones redujeron eso a decenas. DLSS 5 colapsa el proceso a una sola pasada. La contrapartida es arquitectónica: el modelo debe ser mucho más capaz por paso. El beneficio es la latencia: una sola pasada forward del transformer cabe dentro del presupuesto de un frame.
Procesamiento en espacio de píxeles. La mayoría de los modelos de difusión operan en espacio latente, comprimiendo imágenes a través de un autoencoder variacional antes de que la red generativa las toque. NVIDIA eligió espacio de píxeles en cambio, aceptando un mayor costo computacional para evitar la pérdida de detalle que introduce la compresión en espacio latente. Líneas finas, texto pequeño, micro-texturas: todo preservado a nivel de píxel. Esta es la decisión de ingeniería que hace posible la operación en tiempo real, pero costosa.
Persistencia del estado temporal. DLSS 5 mantiene un “Estado Temporal” interno entre frames, separado del búfer de vectores de movimiento que suministra el motor del juego. Así es como el modelo mantiene la consistencia frame a frame sin caer en el parpadeo que aqueja a las aplicaciones generativas simplistas. La estructura de datos específica de ese estado permanece sin publicar, lo cual en sí mismo es una omisión elocuente.
Qué cambió el entrenamiento con G-Buffer
NVIDIA entrenó el modelo usando datos del G-Buffer —los parámetros de material (albedo, normales, rugosidad, metálico) que producen los renderizadores diferidos modernos—, pero no alimenta datos del G-Buffer al modelo en ejecución. El G-Buffer sirve como señal supervisora durante el entrenamiento, enseñando al modelo a respetar la forma del objeto, la orientación de la superficie y las relaciones de iluminación. En el momento de la inferencia, el modelo ha internalizado esas restricciones y solo necesita el búfer de color y los vectores de movimiento para generar correctamente.
Esta es la parte “guiada por 3D” del “Renderizado Neural Guiado por 3D”. La guía está cocida en los pesos, no inyectada en tiempo de ejecución.
La elección del modelo de apariencia
DLSS 5 se entrega con tres Modelos de Apariencia, etiquetados A, B y C. NVIDIA los describe como tres interpretaciones diferentes de fotorrealismo, análogo a la diferencia entre Stocks de película o perfiles de lente en fotografía. Los modelos difieren en respuesta de tono, comportamiento del color y manejo de materiales.
No son niveles de calidad. Son orientaciones estéticas. Los desarrolladores de juegos seleccionan uno por título, o alternan entre ellos en tiempo de ejecución. No se pueden mezclar dentro de una sola escena: no puede haber piel usando el Modelo B mientras que el follaje usa el Modelo A.
El control fino reside en dos parámetros: Intensidad de Estructura, que gobierna la realce de detalle de alta frecuencia espacial, e Intensidad de Tono, que gobierna la iluminación y el sombreado de baja frecuencia espacial. Juntos forman una superficie de control de dos ejes que los desarrolladores pueden modular globalmente o píxel por píxel mediante enmascaramiento a nivel de motor.
Qué no cambia DLSS 5
NVIDIA es explícita sobre los límites. DLSS 5 no corrige errores geométricos. Un marco de ventana desalineado permanece desalineado. La geometría faltante no se restaura. La aliasing de los pases de render base se transmite sin cambios: ese trabajo corresponde a la etapa precedente de super-resolución de DLSS. El diseño del modelo lo restringe a la mejora de apariencia, no a la corrección estructural.
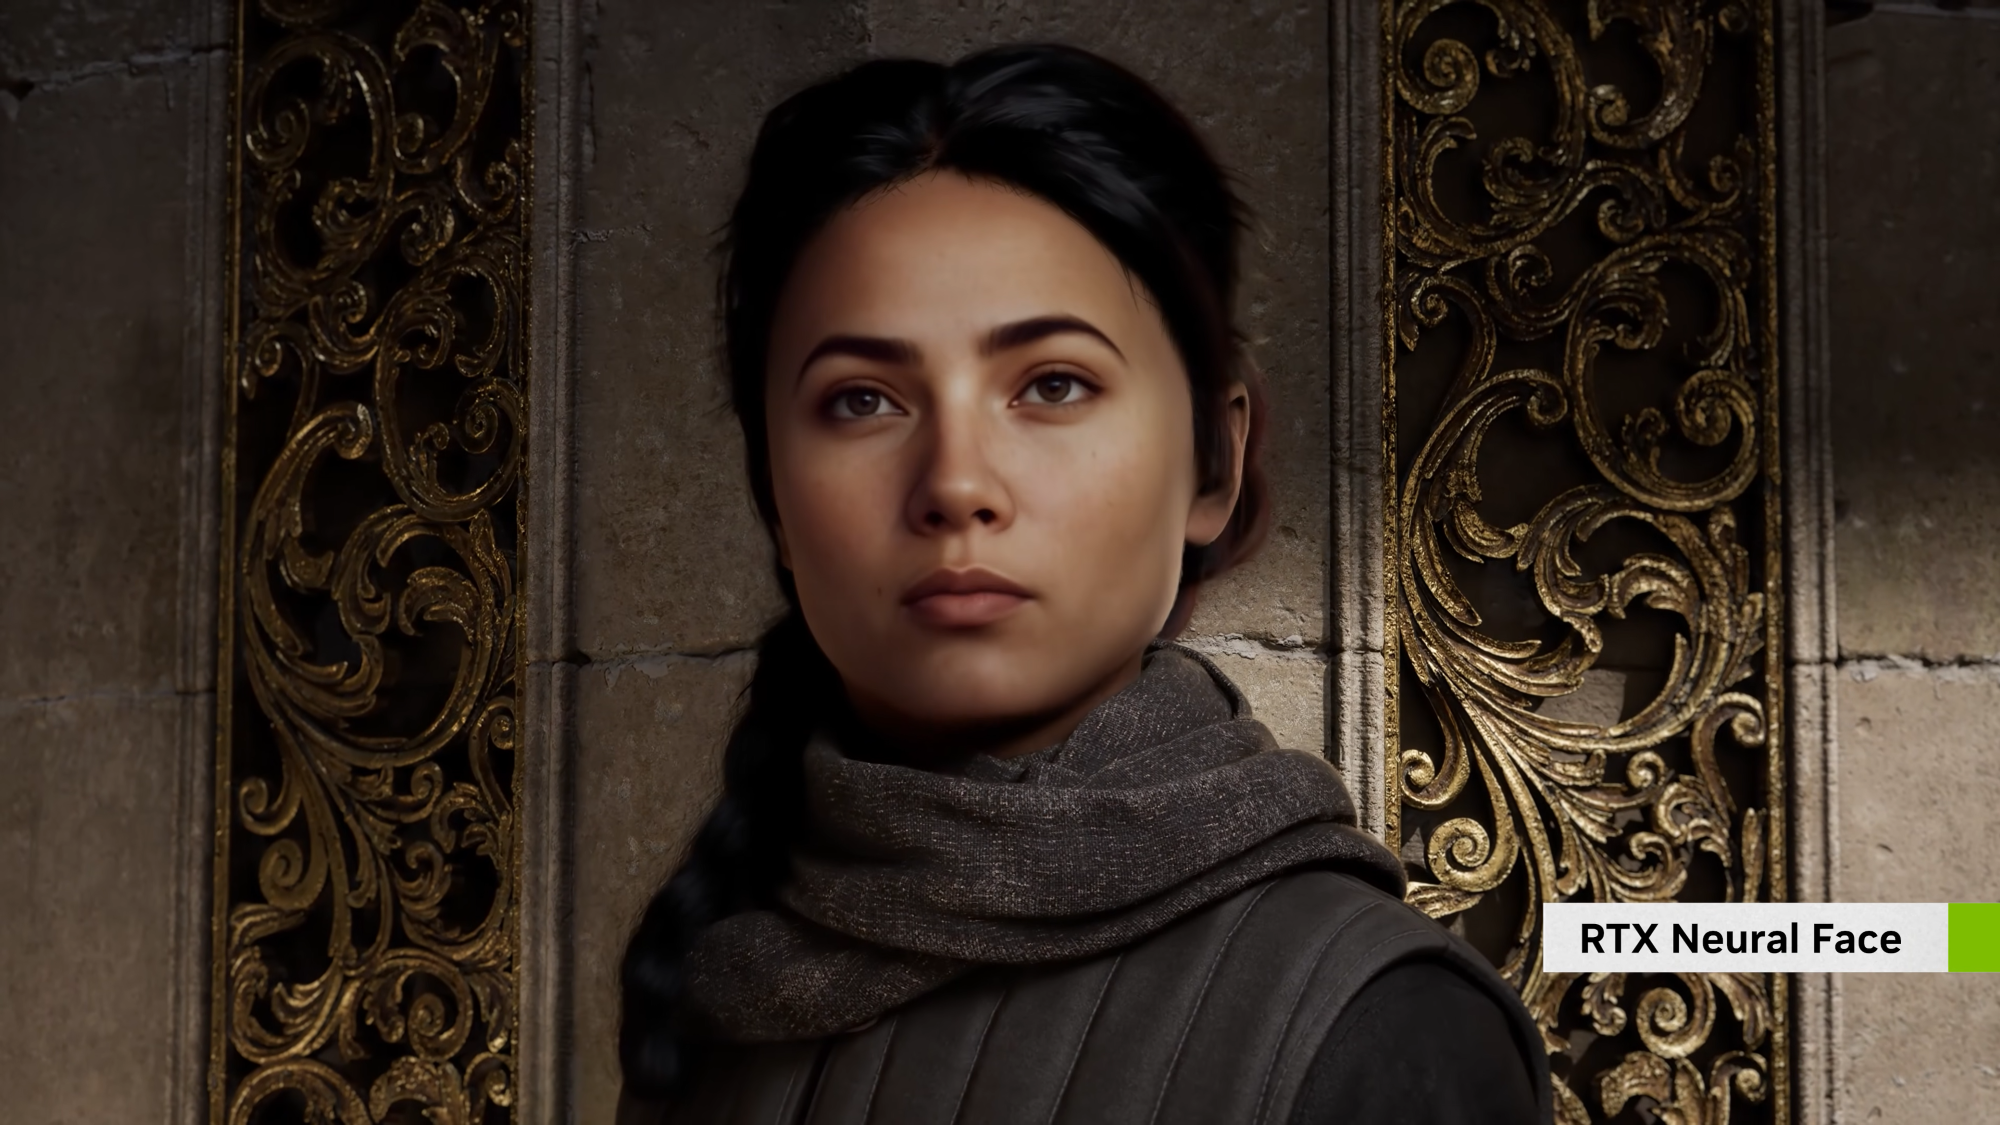
Este límite es deliberado. Separa a DLSS 5 de la tecnología anterior de NVIDIA, RTX Neural Faces, que algunos identificaron erróneamente como precursora de DLSS 5. RTX Neural Faces alteraba la geometría facial mediante entrenamiento por personaje. DLSS 5 deja la geometría intacta. La distinción importa para cualquiera que evalúe si NVIDIA está prometiendo de más sobre las capacidades de renderizado en tiempo real.
Qué cambia en cambio
Scattering subsuperficial de la piel. Comportamiento de los reflejos en el cabello. Brillo de la tela. Transmisión de luz a través de hojas y materiales translúcidos. Estos son los fenómenos superficiales específicos que el rasterizado en tiempo real e incluso el path tracing struggle por renderizar de manera convincente a tasas de frames interactivas. DLSS 5 los trata como objetivos generativos.
Los resultados, como se demostró en NBA 2K27, son más visibles en los rostros, particularmente los rostros de NPCs que reciben presupuestos de iluminación mínimos en el render base. La tecnología eleva a los personajes de fondo a la paridad visual con los protagonistas sin cambiar un solo polígono.
El problema del control
Los usuarios generales no tendrán acceso a los controles de parámetros de DLSS 5. La posición de NVIDIA es que la dirección artística corresponde a los desarrolladores, no a los jugadores. Puede aparecer alguna opción dentro del juego —probablemente un simple control deslizante débil-medio-fuerte—, pero el ajuste granular de Estructura y Tono seguirá bajo control del desarrollador.
Esto es tanto una decisión de diseño como una estrategia de gestión de responsabilidad. La IA generativa aplicada frame a frame conlleva riesgos inherentes: artefactos temporales, deriva estilística inesperada, alucinación localizada. Restringir los controles visibles para el usuario minimiza la posibilidad de que un jugador descubra una configuración inestable y culpe a la tecnología.
La consecuencia es un menú DLSS fragmentado. Las generaciones anteriores ofrecían tres funciones claramente etiquetadas: Super Resolución, Reconstrucción de Rayos, Generación Multi-Frame. DLSS 5 añade un cuarto elemento con un nombre ambiguo. Los jugadores se enfrentarán a una pantalla de configuraciones que ya no se mapea de forma limpia sobre su modelo mental de qué hace cada interruptor.
Por qué esto importa más allá de la GPU
DLSS 5 es la primera tecnología de gráficos en tiempo real mainstream que abraza plenamente una arquitectura basada en difusión. Demuestra que la generación de un solo paso en espacio de píxeles puede operar dentro de los presupuestos de frames interactivos en hardware de consumo. La implicación se extiende más allá de los videojuegos: cualquier aplicación que requiera realce de apariencia fotorrealista a partir de entrada de baja fidelidad —visualización médica, renderizado arquitectónico, simulación— tiene ahora una plantilla arquitectónica validada.
La brecha de reporteo es la historia secundaria. El periodismo tecnológico japonés, liderado por salidas como PC Watch, sigue produciendo análisis arquitectónicos profundos que los medios especializados en inglés no han igualado en este tema. Eso no es un comentario sobre capacidad: es un comentario sobre prioridad editorial. Las decisiones arquitectónicas de NVIDIA se están descodificando en Tokio antes de ser entendidas en el ecosistema mediático de San Francisco.
Para quien rastree la convergencia de la IA generativa y los gráficos en tiempo real, la pregunta ya no es si el renderizado basado en difusión aparecerá en los juegos. DLSS 5 probó eso en 2026. La pregunta es si la prensa que lo cubre está manteniendo el ritmo.