DLSS 5 是一款披着超分辨率外衣的生成式 AI,英文科技媒体却错过了
NVIDIA 的 DLSS 5 在技术本质上是一款单步像素空间扩散 Transformer,而非传统超分辨率方案。《PC Watch》的西川健二是最早拆解其架构的记者,而日语与英语科技媒体在 GPU 创新报道上的差距正在扩大。
英国科技媒体尚未复现的深度报道
英伟达于2026年9月披露了DLSS 5的架构。其核心并非渐进式超采样改良,而是一次根本性重新分类:DLSS 5本质上是一步式像素空间扩散Transformer——一件披着超采样技术外衣的生成式AI图像合成器。
没有任何主要英语媒体发表过同等深度的架构解析。目前最详尽的公开拆解来自PC Watch的西川健二(Kenji Nishikawa),他9月份的专栏《「ディリスの正体は1回推論の画像生成AI」》(直译为"DLSS的真面目是单次推理的图像生成AI")经翻译重构后,代表了英语贸易媒体至今未能企及的GPU架构新闻写作水准。
这个差距为何重要?DLSS 5不是英伟达路线图上的一个小注脚。这是该公司迄今最大胆的一次公开宣告:实时图形与生成式AI正在融合为同一条管线。而能够向全球受众解释这一融合的报道基础设施,正明显滞后。
DLSS 5到底是什么
DLSS一直是"Deep Learning Super Sampling"(深度学习超采样)的缩写。在DLSS 3.5及之前,它作为一个修复引擎运行:游戏渲染器输出低分辨率或有噪点的帧,DLSS利用G-Buffer、运动向量和前一帧的信息进行修复。
DLSS 5打破了这条技术脉络。英伟达称之为"3D引导神经渲染"(3D-Guided Neural Rendering)。论文将其表述为"一步式像素空间扩散Transformer"。用通俗语言说:模型从原始游戏帧出发,仅接收来自前一帧的运动向量数据,在一次推理中输出照片级真实图像。
这正是Stable Diffusion背后的架构类别。区别在于约束结构。文本到图像扩散模型从噪声出发,由提示词引导生成。DLSS 5从实时渲染帧出发,由时间状态和像素空间几何引导生成。它不做去噪,也不做传统意义上的上采样。它从一个低保真源图像重新渲染出照片级外观。
英语媒体为何退缩
2026年3月英伟达预览DLSS 5时,《生化危机:复仇》(Resident Evil Requiem)的对比图引发了即时争议。Grace脸上的阴影细节看起来经过了超出锐化或去噪范畴的处理。英语论坛和媒体的讨论集中到一个问题上:这是否可以接受?
这个问题本身就有偏差。争议预设DLSS 5是一种被推得过分的图像修复工具。并非如此。它是一个受3D场景信息约束的图像生成工具。这个区别改变了一切评估方式。
英语媒体报道至今仍将DLSS 5视为现有超采样技术的有争议变体。PC Watch的西川健二则将其视为一类新的渲染技术。这种框架差异,解释了为什么两套报道的技术深度产生了如此巨大的分歧。
架构拆解
DLSS 5背离前代DLSS的三个设计选择。
一步推理。 传统扩散模型需要迭代数百甚至数千步去噪过程。早期优化将其减少到几十步。DLSS 5将整个过程压缩为单次前向传播。代价是架构设计:模型每步必须具备更强的能力。收益是延迟:单次Transformer前向传播可嵌入帧预算内。
像素空间处理。 大多数扩散模型在潜在空间运行,通过变分自编码器在生成网络触碰图像前先压缩。英伟达选择了像素空间,接受更高的计算成本以避免潜在空间压缩引入的细节损失。细线、小文字、微纹理——全部在像素级保留。这是让实时操作成为可能但代价高昂的工程选择。
时间状态继承。 DLSS 5在帧间保持一个内部"时间状态",独立于游戏引擎提供的运动向量缓冲区。这是模型保持帧间一致性、避免陷入朴素生成应用常见闪烁问题的机制。该状态的具体数据结构至今未发布,这本身就是一个值得注意的省略。
G-Buffer训练改变了什么
英伟达使用G-Buffer数据训练模型——即现代延迟渲染器输出的材质参数(反照率、法线、粗糙度、金属度)——但运行时并不将G-Buffer数据喂入模型。G-Buffer在训练中作为监督信号,教导模型尊重物体形状、表面朝向和光照关系。推理时,模型已将那些约束内化,仅需颜色缓冲区和运动向量即可正确生成。
这就是"3D引导神经渲染"中的"3D引导"部分。引导被编码进权重,而非在运行时注入。
外观模型的选择
DLSS 5随附三个外观模型,标记为A、B、C。英伟达将其描述为三种不同的照片级真实诠释,类似于摄影中不同胶片特性或镜头配置文件之间的差异。三个模型在色调响应、色彩行为和材质处理上各不相同。
它们不是质量等级。它们是美学取向。游戏开发者针对每部作品选择一个,或在运行时切换。它们不能在同一个场景内混合——不能出现皮肤使用B模型而植被使用A模型的情况。
细粒度控制位于两个参数:结构强度(Structure Intensity),控制高空间频率细节增强;色调强度(Tone Intensity),控制低空间频率的光照和明暗。两者构成一个两轴控制面,开发者可通过引擎级遮罩全局调节或逐像素调节。
DLSS 5不会改变什么
英伟达对边界明确表态。DLSS 5不修复几何错误。错位对齐的窗框依然错位。缺失几何不会被恢复。基础渲染产生的锯齿原样通过——那属于前置DLSS超级分辨率阶段的工作。模型的设计将其约束于外观增强,而非结构修正。
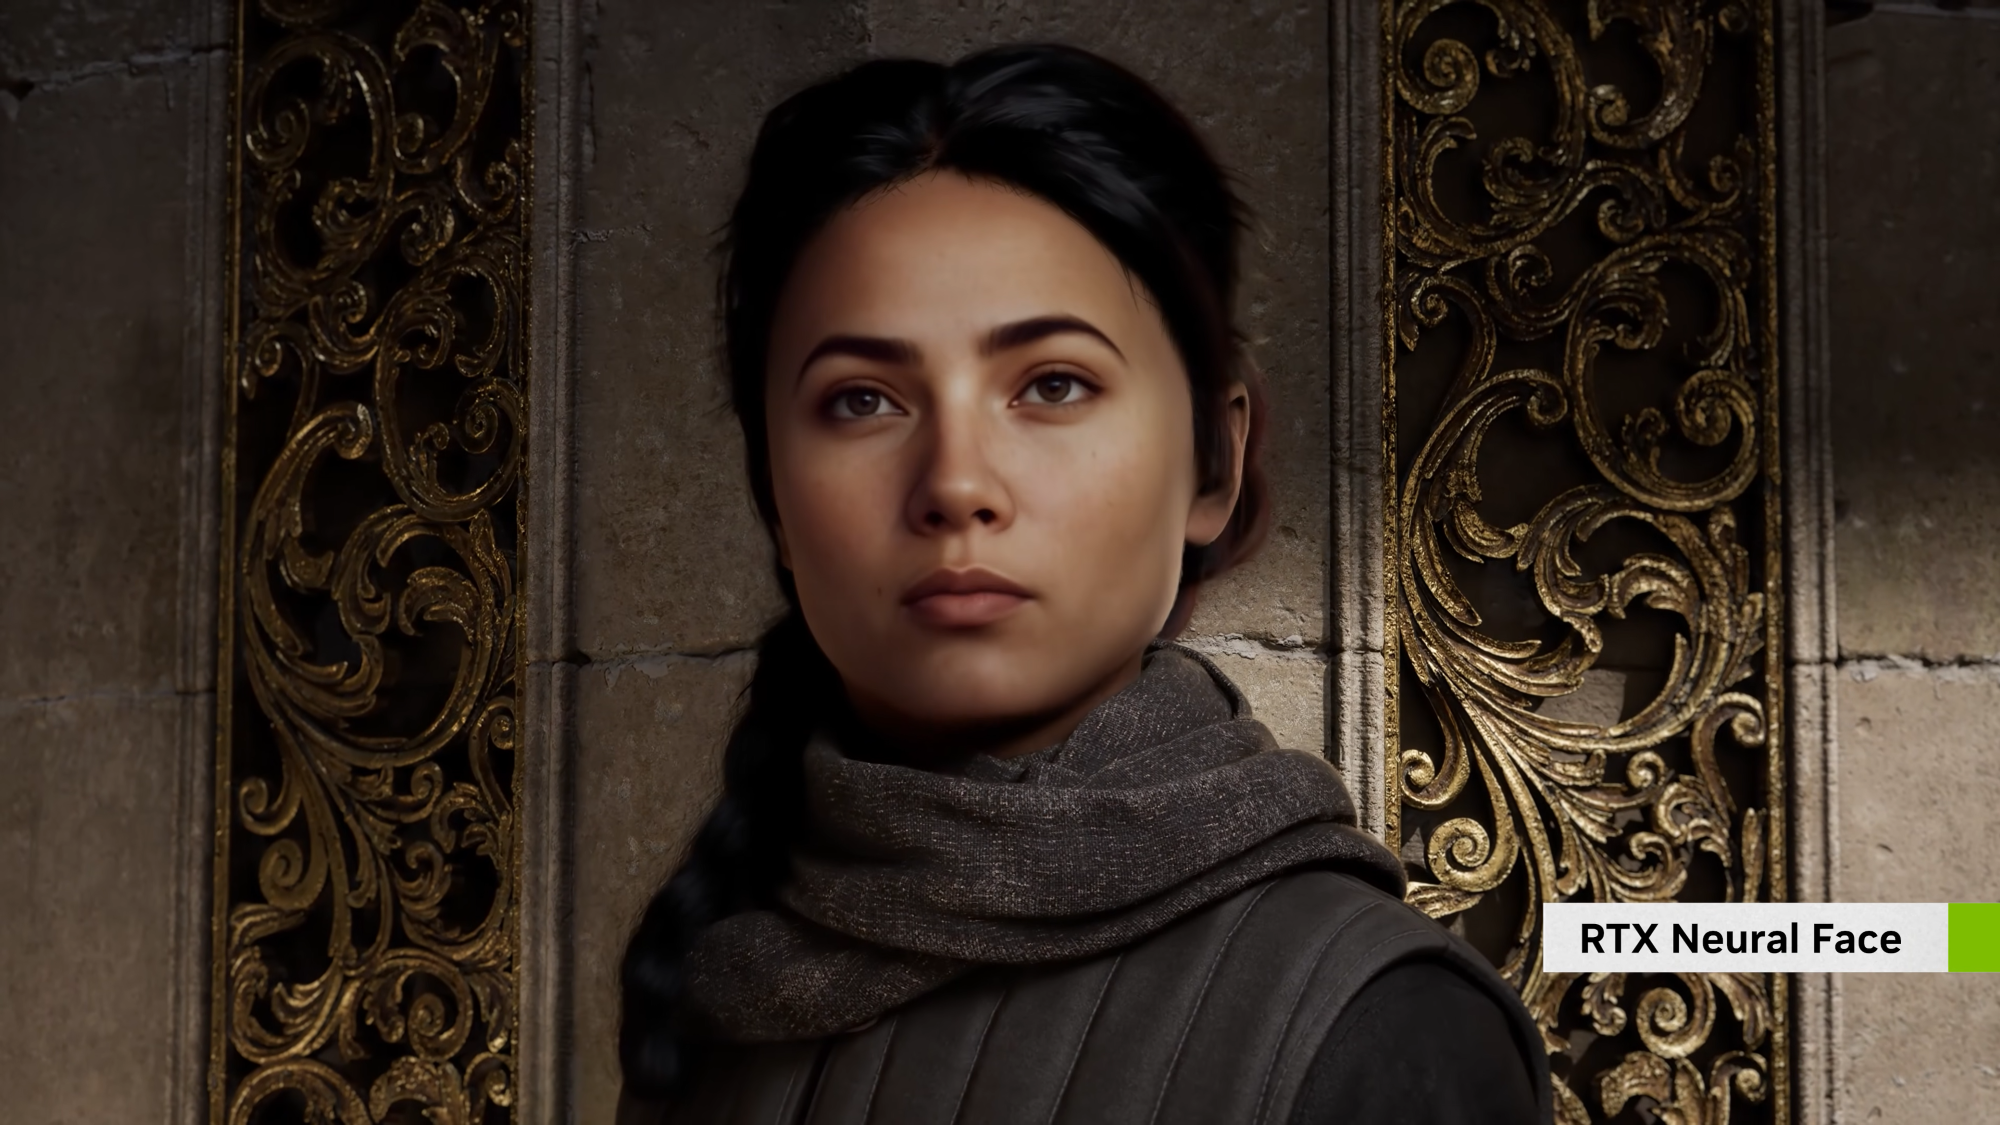
这个边界是刻意为之。它将DLSS 5与英伟达早期RTX神经面孔(RTX Neural Faces)技术区分开来——后者被部分人误认为DLSS 5的前身。RTX神经面孔通过角色级训练改变面部几何。DLSS 5不触碰几何。这个区别对评估英伟达是否在实时渲染能力上过度承诺的人至关重要。
改变的是什么
皮肤次表面散射。头发高光行为。织物光泽。光线透过树叶和半透明材质的传输。这些正是实时光栅化和即便是光线追踪都难以在交互帧率下令人信服渲染的具体表面现象。DLSS 5将它们视为生成目标。
正如《NBA 2K27》所演示的结果,最明显的变化在于面部——尤其是基础渲染中照明预算极少的小程序(NPC)面部。这项技术在不变动单个多边形的前提下,将背景角色提升至与主角同等视觉水准。
控制问题
普通用户将无法访问DLSS 5的参数控制。英伟达的立场是,艺术方向权属于开发者,而非玩家。游戏内可能出现某种选项——很可能是一个简单的弱/中/强滑块——但细粒度的结构和色调调整仍将由开发者控制。
这既是设计决策,也是风险管控策略。逐帧应用的生成式AI内在地携带风险:时间伪影、意外的风格漂移、局部幻觉。限制用户端控制可最小化玩家发现不稳定配置并将责任归咎于技术的概率。
结果是DLSS菜单的碎片化。前几代提供三个清晰标注的功能:超级分辨率、光线重建、多帧生成。DLSS 5新增第四项,命名模糊。玩家将面对的不再是能清晰映射到每个开关功能的设置界面。
为何影响超越GPU本身
DLSS 5是首款全面拥抱基于扩散架构的主流入门实时图形技术。它证明了单次像素空间生成可以在消费级硬件上以交互帧预算运行。其影响超越游戏:任何需要从低保真输入进行照片级外观增强的应用——医疗可视化、建筑渲染、仿真——现在都有了经过验证的架构模板。
报道差距是次要故事。以PC Watch为代表的日本科技媒体持续产出架构深度解析,英语贸易媒体在此话题上尚未匹敌。这不是对能力的评论——这是对编辑优先级的评论。英伟达的架构决策在东京被解码,早于它们在旧金山媒体生态中被理解。