GitHub acaba de volver obsoleta la carrera armamentista de modelos
La nueva función HydraFusion de GitHub enruta tareas de codificación entre múltiples modelos de IA en tiempo real, ofreciendo calidad de nivel puntero con hasta un 67% menos que Claude Opus 5. Esta jugada desplaza la competición de herramientas de IA desde la capacidad bruta del modelo hacia la inteligencia de orquestación.
La carrera por la calidad de los modelos ha terminado. Ha comenzado la guerra del enrutamiento.
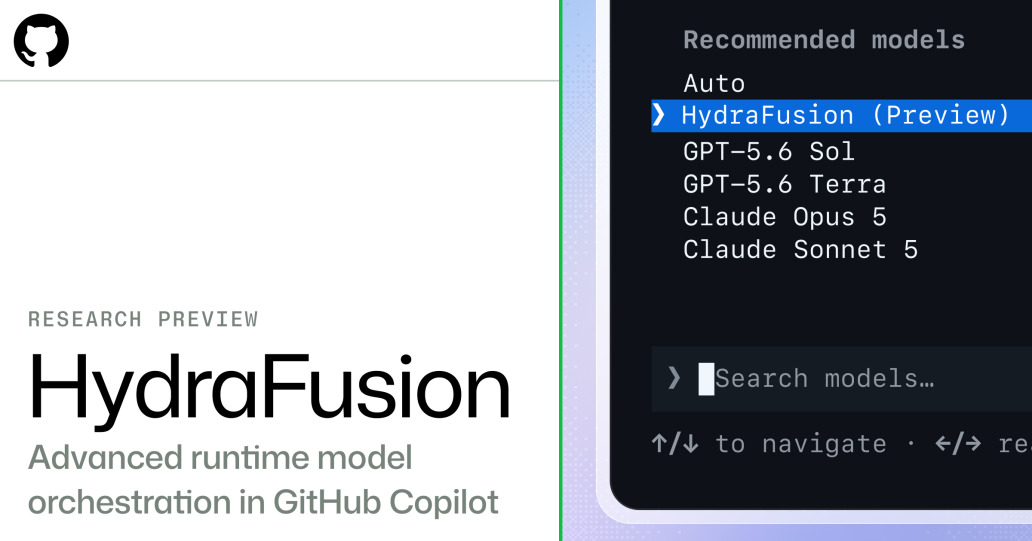
GitHub acaba de hacer algo incómodo para todos los que venden modelos de IA por su cuenta. El 4 de septiembre, la compañía lanzó Project HydraFusion como vista previa de investigación dentro de GitHub Copilot, una función que abandona por completo el enfoque de un solo modelo y, en su lugar, enruta cada tarea de programación entre múltiples proveedores de IA en tiempo de ejecución, reclamando resultados de vanguardia con hasta un 67% menos que Claude Opus 5.
La implicación es clara: la próxima ventaja competitiva en herramientas de IA podría no provenir de entrenar un modelo más grande, sino de construir un intermediario más inteligente.
Cómo funciona HydraFusion en realidad
HydraFusion se integra dentro del CLI de GitHub Copilot y se activa mediante la cadena de comandos /experimental. Los usuarios actualizan su CLI, activan el modo experimental y seleccionan HydraFusion en el selector de modelos. A partir de ahí, todo funciona de forma automática.
El sistema evalúa cada solicitud y elige uno de tres patrones de ejecución:
Single enruta la tarea a un solo modelo. Este es el punto de referencia: sin orquestación, solo una llamada directa. Útil cuando la tarea es sencilla y añadir complejidad no ayudará.
Cascade comienza con un modelo más barato y rápido para producir una solución preliminar. Un filtro de calidad evalúa luego si ese borrador es suficiente. Si lo aprueba, el usuario obtiene un resultado rápido e económico. Si lo rechaza, la tarea se eleva a un modelo más capaz. La idea clave aquí es que la mayoría de las tareas de programación no necesitan el modelo más potente, sino el adecuado.
Critique divide el trabajo entre dos familias de modelos. Uno genera un borrador mientras el otro, en modo solo lectura, actúa como revisor. Luego, el modelo redactor revisa su trabajo basándose en esa retroalimentación. Esto se acerca al razonamiento multiagente, pero sin la sobrecarga de ejecutar ambos modelos simultáneamente sobre la misma tarea.
Los precios siguen las tarifas estándar por token de cada modelo utilizado. No hay descuento por orquestación: los ahorros provienen puramente de las decisiones de enrutamiento que evitan actualizaciones innecesarias a modelos costosos.
Los datos revelan una historia matizada
GitHub publicó resultados en tres benchmarks de coding de tipo agente, comparando HydraFusion contra Claude Opus 5. Los números merecen un examen cuidadoso porque revelan qué tipo de cargas de trabajo se benefician más de la orquestación.
En TerminalBench 2.1, HydraFusion no solo redujo los costes un 67%, sino que también mejoró la calidad en 4,9 puntos en comparación con Opus 5 ejecutando la misma tarea. Esta es la cifra destacada y importa: sugiere que, para tareas de codificación orientadas a terminal y línea de comandos, un enfoque enrutado puede superar a un único modelo de gama alta.
DeepSWE mostró una reducción del 36% en costes pero un descenso de 1,5 puntos en calidad. CheckpointBench ofreció ahorros del 65% con una merma de solo 0,1 puntos.
El patrón es claro: cuando la tarea exige un razonamiento profundo de ingeniería de software a través de codebases complejas, el cascade a veces puede dar un resultado inferior al de Opus 5 por sí solo. Pero para la mayoría del trabajo cotidiano de codificación —el que ocupa la mayor parte del tiempo de los desarrolladores—, los ahorros son sustanciales con una compensación de calidad mínima.
No se trata de una mejora uniforme. Es un desplazamiento de la distribución.
Por qué esto importa más allá de GitHub
OpenAI construyó su foso basándose en la premisa de que sus modelos son categóricamente mejores y que los desarrolladores deben pagar por esa superioridad. HydraFusion invierte esa lógica. Dice: el mejor modelo en la sala no siempre es el correcto para el trabajo, y un sistema que sabe cuándo escalar y cuándo ahorrar dinero vencerá a un sistema que siempre busca el mejor.
Esto reformula el panorama competitivo en varios aspectos.
En primer lugar, debilita el bloqueo del modelo único del que dependen OpenAI, Anthropic y otros. Si GitHub puede demostrar que la orquestación supera una llamada individual a Opus 5 en benchmarks significativos, otros constructores de herramientas tendrán incentivo para adoptar estrategias similares, y la propuesta de valor de cualquier proveedor de modelos por sí solo se verá disminuida.
En segundo lugar, posiciona a GitHub como una capa de infraestructura, no solo como vendedor de Copilot. El verdadero activo aquí no son los modelos, sino la lógica de enrutamiento. Una vez que los desarrolladores experimentan las compensaciones coste-calidad de HydraFusion, cambiarse a una oferta de modelo único de la competencia requiere tanto una justificación de calidad como disposición a pagar más.
En tercer lugar, esto ejerce presión sobre los proveedores de modelos para que reduzcan sus precios o acepten que solo recibirán tráfico en las tareas más difíciles, aquellas que realmente requieren toda su capacidad. El riesgo de Commoditization es real.
Quién gana y quién pierde
Los desarrolladores ganan de inmediato. Menores costes para una calidad comparable o superior en tareas rutinarias significa más uso de Copilot, menos preocupaciones presupuestarias y menos culpa por consumir tokens en completados simples.
GitHub gana estratégicamente. Diferencia Copilot no solo por el acceso a modelos, sino por la inteligencia de orquestación, algo más difícil de replicar que una conexión simple a una API de modelos.
Los proveedores de modelo único enfrentan presión en sus márgenes. Incluso si sus modelos siguen siendo técnicamente superiores en tareas difíciles, la capa de enrutamiento asegura que solo vean el extremo final de la distribución de cargas de trabajo. El negocio de volumen va a los modelos más baratos.
OpenAI enfrenta el desafío más afilado. El posicionamiento histórico de Copilot se ha apoyado fuertemente en GPT-4 y versiones posteriores. Si HydraFusion demuestra que la orquestación vence a modelos de nivel GPT-4 en calidad ajustada por coste, la narrativa sobre la supremacía de OpenAI pierde credibilidad, específicamente en el contexto de herramientas para desarrolladores.
Qué sigue
HydraFusion sigue siendo una vista previa de investigación. GitHub señaló explícitamente que las especificaciones pueden cambiar. Los tres patrones de ejecución son un punto de partida, no una arquitectura terminada. Esperen adiciones iterativas: más estrategias de enrutamiento, filtros de calidad más refinados y posibles optimizaciones específicas por modelo.
La pregunta más amplia es si esto se convierte en un patrón estándar en toda la herramienta de IA. Cursor, Tabnine y otros asistentes de codificación podrían adoptar capas de orquestación similares. Si lo hacen, el indicador competitivo cambiará permanentemente de “cuál modelo es mejor” a “cuál sistema de enrutamiento es más inteligente”. Esa es una carrera diferente, y una en la que GitHub tiene una ventaja de posicionamiento temprano.
Por ahora, la señal es clara: la industria está dejando atrás la era en la que la calidad bruta de los modelos por sí sola garantiza una ventaja competitiva. La capa de enrutamiento está convirtiéndose en el producto.