GitHub 刚刚让模型军备竞赛变得多余
GitHub 新推出的 HydraFusion 功能可在运行时将编码任务分配到多个 AI 模型,以比 Claude Opus 5 低 67% 的成本实现前沿级质量。这一举措将 AI 工具领域的竞争从模型_raw_能力转向了编排智能。
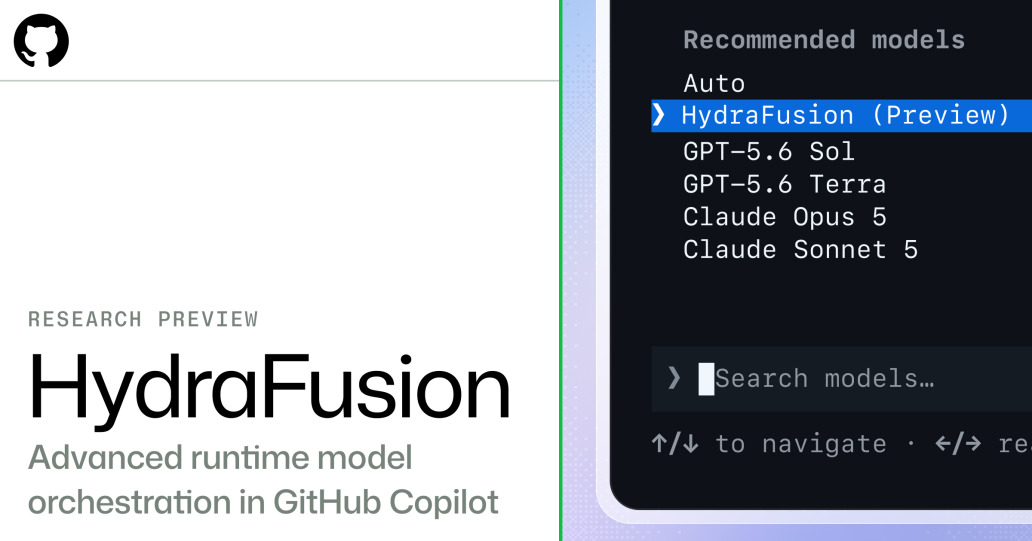
模型质量之争已落幕,路由战争才刚刚开始。
GitHub刚刚让所有独立出售AI模型的公司感到不安。9月4日,该公司在GitHub Copilot中发布了Project HydraFusion研究预览版,这一功能完全摒弃了单一模型方案,改为在运行时将每项编码任务路由至多个AI提供商——声称能以比Claude Opus 5最多低67%的成本,达到前沿级效果。
其含义十分明确:AI工具领域的下一个竞争优势,或许不再来自于训练更大的模型,而在于构建更智能的路由中枢。
HydraFusion究竟如何运作
HydraFusion运行在GitHub Copilot CLI内部,通过/experimental命令链激活。用户只需更新CLI、开启实验模式,然后从模型选择器中选中HydraFusion。此后一切自动运行。
系统会评估每项请求,并从中选择三种执行模式之一:
**Single(单模型)**将任务路由至单一模型。这是基准模式——无需编排,直接调用。适用于任务简单、增加复杂度也无益的场景。
**Cascade(级联)**先用更便宜、更快的模型生成草案。随后通过质量关卡评估该草案是否达标。若通过,用户获得快速且低成本的输出;若不通过,任务则升级至能力更强的模型。这里的关键洞察在于:大多数编码任务并不需要最强的模型——它们只需要最合适的模型。
**Critique(审评)**将工作拆分为两个模型家族。一个负责生成草案,另一个以只读方式充当审评角色。起草模型随后根据反馈进行修订。这更接近多智能体推理,但避免了同时运行两个模型处理同一任务所带来的开销。
定价遵循各模型的标准按token计费。编排本身并无折扣——节省完全来自路由决策,即避免不必要地升级到昂贵模型。
基准测试讲述了一个微妙的故事
GitHub在三种代理型编码基准上公布了结果,将HydraFusion与Claude Opus 5进行比较。这些数字值得仔细审视,因为它们揭示了哪些类型的负载最能从编排中受益。
在TerminalBench 2.1上,HydraFusion不仅将成本削减了67%,而且相比运行同一任务的Opus 5,质量反而提升了4.9分。这是 headline 数字,意义重大——它表明,对于终端和命令行导向的编码任务,路由方案可以超越单一顶级模型。
DeepSWE显示成本降低36%,但质量下降1.5分。CheckpointBench则实现了65%的节省,质量仅下降0.1分。
模式十分清晰:当任务需要在复杂代码库中进行深度软件工程推理时,级联方案有时可能给出的结果不如单独使用Opus 5。但对于大多数日常编码工作——那些占用开发者绝大部分时间的工作——节省非常可观,而质量取舍极小。
这不是uniform的提升,而是分布的移动。
为何超越GitHub本身
OpenAI建立护城河的前提是:其模型在本质上更优越,开发者理应为此支付溢价。HydraFusion反转了这一逻辑。它传递的信息是:在场的所有模型中,最好的并不总是最适合该任务的,而一个知道何时升级、何时省钱系统,将胜过始终追求最佳模型的方案。
这从多个层面重塑了竞争格局。
首先,它削弱了OpenAI、Anthropic等依赖的单一模型锁定效应。如果GitHub能在有意义的基准测试上证明编排优于单次Opus 5调用,其他工具构建者将有动力采用类似策略——任何单一模型供应商的价值主张都将因此削弱。
其次,GitHub将自己定位为基础设施层,而不仅仅是Copilot销售商。这里真正的资产不是模型,而是路由逻辑。一旦开发者体验到HydraFusion的成本质量权衡,转向竞争对手的单一模型方案就需要同时满足质量理由和愿意支付更高价的条件。
第三,这对模型供应商形成压力,迫使它们要么降价,要么只能接受在最难任务上的流量——那些真正需要其全部能力的任务。商品化风险真实存在。
谁赢谁输
开发者立即获益。 在常规任务上以更低成本获得相当甚至更好的质量,意味着更高的Copilot使用率、更少的预算顾虑,以及对在简单补全上消耗token的负罪感降低。
GitHub获得战略优势。 它在模型接入之外,以编排智能差异化Copilot——这比单纯连接模型API更难复制。
单一模型供应商面临利润率压力。 即使它们的模型在处理难题时仍具备技术优势,路由层也确保它们只承接工作负载分布的尾部。体量业务将流向更便宜的模型。
OpenAI面临最尖锐的挑战。 Copilot的历史定位 heavily 倚重GPT-4及后续版本。如果HydraFusion证明,在成本调整后质量下,编排能胜过GPT-4级模型,围绕OpenAI优势的叙事在开发者工具领域将失去可信度。
接下来会发生什么
HydraFusion仍是研究预览版。GitHub明确指出规格可能变更。三种执行模式只是一个起点,而非完整架构。可以预期迭代的追加——更多的路由策略、更精细的质量关卡、可能的模型特定优化。
更广阔的问题是:这是否会成为AI工具领域的标准模式。Cursor、Tabnine及其他编码助手均可采用类似编排层。如果它们这样做,竞争指标将从"哪个模型最好"永久转向"哪个路由系统最智能"。这是一场不同的竞赛,而GitHub拥有早期定位优势。
就目前而言,信号十分清晰:行业正迈入一个时代,仅凭原始模型质量已无法保证竞争优势。路由层正在成为产品本身。