H-TPU de SK Hynix: una apuesta para redefinir el hardware de IA
SK Hynix no intenta vencer a NVIDIA en su propio terreno. Con H-TPU, el gigante de la memoria se posiciona en la intersección entre almacenamiento e inferencia de IA, un rol que podría reformular silenciosamente cómo se construyen los data centers.
El cuello de botella ya no es la GPU. Es el SSD.
SK Hynix lo sabe mejor que nadie. La compañía suministra la memoria que alimenta las GPUs de NVIDIA y los TPUs de Google: los stacks HBM, los chips LPDDR, el NAND que sustenta cada ejecución importante de entrenamiento de IA. Pero mientras el resto de la industria compite por hacer las GPUs más rápidas, SK Hynix ha estado observando un problema más lento y silencioso que se agrava dentro de cada centro de datos de IA: el controlador SSD.
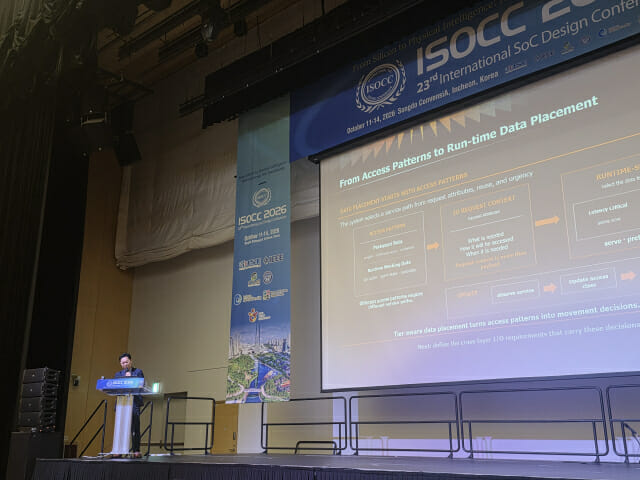
En ISOCC 2026 la semana pasada, el gigante de la memoria presentó su respuesta. No una GPU más grande. No un CPU más rápido. Algo completamente diferente llamado H-TPU: la Unidad de Procesamiento de Transacciones Hynix.
La propuesta es engañosamente simple. El problema que resuelve es estructural.
Por qué los controladores SSD son el nuevo cuello de botella
Cada vez que llega una nueva generación de GPUs, su rendimiento se duplica aproximadamente. El ancho de banda PCIe le sigue el ritmo. Pero la lógica de control dentro de un SSD típico —el pequeño CPU que decide cómo enrutar las solicitudes de lectura y escritura, gestionar el desgaste equilibrado, manejar la corrección de errores— no ha logrado mantenerse al día. Sigue ejecutándose en una arquitectura de CPU genérica y monolítica diseñada hace décadas para un mundo donde el almacenamiento era lento y simple.
Ku In-jae de SK Hynix, vicepresidente de diseño de SoC de la compañía, lo expresó con crudeza. Los enfoques tradicionales —simplicemente arrojar más núcleos de CPU al problema— conducen a un desperdicio extremo de energía y una latencia impredecible en la tubería. Cien o más funciones discretas que un controlador SSD debe gestionar simultáneamente simplemente no encajan dentro de un solo bloque de procesador sin penalizaciones graves.
El resultado es un muro de rendimiento creciente. Las cargas de trabajo de inferencia de IA, que son cada vez más intensivas en lectura (algunos entornos muestran ratios de lectura a escritura que se acercan a 300,000:1), exigen que los controladores de almacenamiento respondan con precisión determinista y baja latencia. Las CPUs de propósito general son la herramienta incorrecta para ese trabajo.
Qué es realmente H-TPU
H-TPU no es un acelerador de IA. No realiza matemáticas tensoriales. No entrena modelos ni ejecuta inferencia directamente. Lo que hace es algo quizás más importante para la economía del despliegue de IA: controla la ruta de datos entre el almacenamiento y el cálculo con una eficiencia extraordinaria.
El enfoque de SK Hynix fue tomar la idea de una unidad de procesamiento de transacciones —un procesador especializado para una clase estrecha de cargas de trabajo— y dividirlo en decenas de pequeños clústeres. Cada núcleo H-TPU utiliza una magra tubería de cuatro etapas sin ejecución superescalar ni lógica fuera de orden. El resultado es un chip que ocupa aproximadamente 1/25 del área y consume 1/25 de la energía de un núcleo de CPU genérico comparable.
La idea clave es la partición basada en funciones. En lugar de un único CPU ejecutando todo a menor velocidad, el controlador delega tareas específicas a bloques de procesamiento dedicados. Los módulos involucrados en operaciones de escritura permanecen activos; los módulos inactivos caen en estados de mínimo consumo. El sistema logra lo que SK Hynix llama tiempos de finalización deterministas y predecibles —exactamente la propiedad que las cargas de trabajo de inferencia de IA más necesitan.
La capa de Automatización de Hardware
Hay una segunda dimensión del H-TPU que importa incluso más que el silicio en sí. SK Hynix describió una trayectoria hacia lo que llama Automatización de Hardware: una capa donde las operaciones repetitivas de bajo nivel (procesamiento de comandos, búsquedas de direcciones, copias temporales de búfer) se transfieren completamente fuera del procesador y hacia circuitos de hardware fijo. El CPU y el H-TPU luego manejan solo los casos excepcionales: errores, decisiones de política y lógica de orden superior.
Este es un cambio arquitectónico fundamental. Refleja lo que ocurrió en la transición de procesadores de propósito general a ASICs en la primera generación de aceleradores de IA, pero aplicado al controlador de almacenamiento —una capa que la industria ha dado por sentada durante mucho tiempo.
Si SK Hynix ejecuta esta visión, el controlador SSD deja de ser una tubería pasiva y se convierte en un componente inteligente y adaptativo de la ruta de datos de IA. Eso tiene implicaciones mucho más allá del almacenamiento.
Por qué HBF cambia los cálculos
El anuncio del H-TPU se emparejó con el empuje de SK Hynix hacia el HBF: Flash de Alto Ancho de Banda, un producto de memoria de nueva generación basado en NAND que combina capacidad masiva con una arquitectura de servicio de alto ancho de banda. Aquí es donde se vuelve visible la verdadera jugada estratégica.
La inferencia de IA es abrumadoramente dominada por lecturas. El patrón clásico es: cargar los pesos del modelo una vez, luego servir miles de millones de solicitudes de lectura contra ellos. HBF está diseñado exactamente para esta carga de trabajo. Cuando se combina con un SoC controlado por H-TPU, el sistema puede precargar datos y gestionar búferes con anticipación, ocultando la latencia inherente de acceso del NAND detrás de la tubería de cómputo.
La afirmación de SK Hynix es audaz pero técnicamente coherente: el controlador preserva el contexto de la solicitud a lo largo de toda la ruta de servicio, convirtiendo efectivamente la capacidad cruda de flash NAND en un recurso de memoria utilizable para IA. En términos prácticos, esto significa menor dependencia de la costosa HBM para ciertas cargas de trabajo de inferencia y una ruta hacia un costo total de propiedad más bajo en centros de datos.
Quién gana, quién pierde
El ganador más obvio en este escenario es SK Hynix misma. La compañía ha pasado años en la cima del gráfico de memoria —tanto DRAM como NAND— mientras la historia del cálculo pertenecía a NVIDIA, AMD y el silicio personalizado de Google. H-TPU y HBF representan un movimiento hacia arriba en la pila: de suministrar la memoria que consumen los procesadores de otros, a construir la inteligencia que orquesta cómo fluye esa memoria.
NVIDIA no será desplazada por un chip de controlador SSD. Pero la arquitectura que SK Hynix describe desafía la suposición de que la memoria y el cálculo son capas separadas que pueden escalar independientemente. Si el almacenamiento puede precargar, gestionar búferes y ocultar latencia de forma inteligente, la presión sobre las soluciones solo de cálculo —y el ancho de banda de memoria que requieren— se afloja ligeramente. Es un cambio marginal, pero en la economía de centros de datos, los cambios marginales se acumulan.
Google, que ya diseña TPUs y tiene profunda experiencia en controladores específicos de dominio, es la comparación más cercana. Pero la ventaja de SK Hynix es diferente: escala. La compañía es el mayor fabricante de memoria del mundo. Su relación con cada proveedor de nube principal y diseñador de chips ya está establecida. H-TPU no es una apuesta especulativa: es un movimiento de integración vertical respaldado por un volumen real de fabricación.
Los perdedores, si los hay, son las compañías que más se benefician de la separación actual entre las capas de memoria y cálculo. Los proveedores de IP para controladores SSD como Phison y Silicon Motion enfrentan un desafío directo. Lo mismo ocurre con las compañías que venden la suposición de que las GPUs más rápidas son el único palanca que vale la pena tirar.
Qué sucede después
SK Hynix no anunció una fecha de envío ni un cliente comercial para H-TPU en ISOCC. La presentación fue arquitectónica: una señal, no un lanzamiento de producto. Eso es apropiado para un primer revelado, pero también significa que la prueba vendrá en los próximos 12 a 18 meses.
La prueba crítica es si los proveedores de nube adoptan la combinación HBF + H-TPU como una ruta estándar de aceleración de inferencia. Si lo hacen, SK Hynix se convierte en más que un proveedor de memoria: se convierte en codiseñador de la pila de hardware de IA. Si no lo hacen, H-TPU permanece como un paper arquitectónico interesante y el statu quo se mantiene.
De cualquier manera, la dirección es clara. La carrera de hardware de IA ya no se trata solo de quién fabrica la GPU más rápida. Se trata de quién controla toda la ruta de datos —desde el bus de memoria de la GPU hasta llegar al flash NAND. SK Hynix acaba de declarar que tiene la intención de controlar la mitad inferior.