海力士H-TPU:悄然重塑AI硬件架构
海力士并不想在NVIDIA的主场上与之竞争。借助H-TPU,这家存储巨头正于存储与AI推理的交汇处开辟全新赛道——这一策略或悄然改写数据中心的建造逻辑。
瓶颈不再只是GPU,而是SSD。
SK海力士比任何人都更清楚这一点。这家公司为NVIDIA的GPU和Google的TPU提供内存——HBM堆叠、LPDDR芯片、支撑每一次大型AI训练任务的NAND闪存。但当整个行业竞相加速GPU时,SK海力士却在注视着一个在每座AI数据中心内部缓慢滋生的更慢、更安静的问题:SSD控制器。
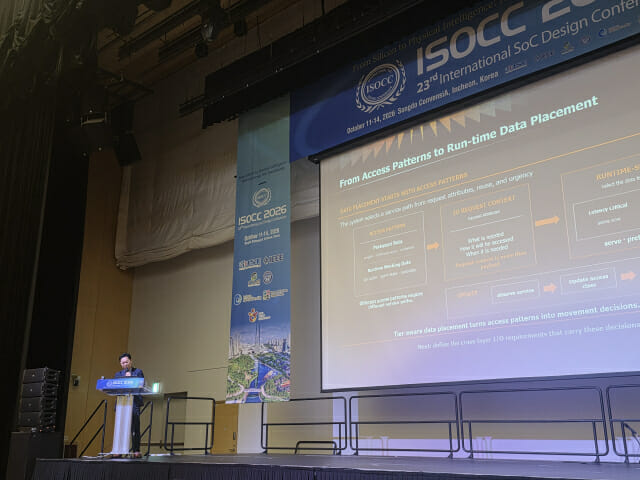
在上周举行的ISOCC 2026大会上,这家内存巨头揭晓了自己的答案。不是更大的GPU,也不是更快的CPU,而是一种截然不同的东西——H-TPU,即"海力士事务处理单元"。
它的宣传语看似简单,但它所解决的问题却是结构性的。
为什么SSD控制器成为新的瓶颈
每一代GPU发布,其性能大致翻一番。PCIe带宽随之跟上。但典型SSD内部的控制逻辑——那个决定如何路由读写请求、管理磨损均衡、处理错误校正的"小CPU"——却没能同步进化。它仍运行在几十年前为存储缓慢且简单的时代而设计的单体通用CPU架构上。
SK海力士SoC设计副总裁Ku In-jae说得直白:传统的应对方式——简单地往问题里堆更多CPU核心——会导致严重的功耗浪费和不可预测的流水线延迟。SSD控制器必须同时管理的约一百多项离散功能,根本无法在不付出巨大代价的情况下塞进单个处理器模块中。
结果是一道越来越高的性能墙。AI推理工作负载越来越偏向读取(某些环境中的读写比接近30万:1),这就要求存储控制器以确定性的低延迟精度来响应。通用CPU并非为此而生。
H-TPU到底是什么
H-TPU不是AI加速器。它不做张量计算,不直接训练模型,也不直接运行推理。它所做的,对于AI部署的经济性而言或许更重要:它以非凡的效率控制存储与计算之间的数据通路。
SK海力士的思路是将"事务处理单元"——一种专为一类特定工作负载设计的处理器——的概念切分为数十个微型集群。每个H-TPU核心采用精简的四阶段流水线,没有超标量执行,也没有乱序逻辑。结果是,一块面积约为同等通用CPU核心1/25、功耗仅为后者1/25的芯片。
核心洞察在于基于功能的分区。不是单个CPU以更低的速度运行一切,控制器将特定任务委派给专用处理模块。涉及写操作的模块保持活跃,空闲模块则进入最低功耗状态。系统实现了SK海力士所称的确定性、可预测的完成时间——这正是AI推理工作负载最需要的特性。
硬件自动化层
H-TPU还有一个比芯片本身更重要的维度。SK海力士勾勒出一条走向"硬件自动化"的演进路径——在这个层次中,重复性的底层存储操作(命令处理、地址查询、临时缓冲区拷贝)被完全移出处理器,移入固定的硬件电路。CPU和H-TPU则仅处理异常情况:错误、策略决策和更高阶的逻辑。
这是一种根本性的架构转变。它类似于第一代AI加速器中从通用处理器向ASIC演进的那段历史,只不过这一次应用的对象是存储控制器——一个行业长期视为理所当然的层次。
如果SK海力士能够实现这一愿景,SSD控制器就不再是被动的管道,而成为AI数据通路中智能、自适应的组件。其影响远超存储领域。
为什么HBF改变了游戏规则
H-TPU的发布与SK海力士推进HBF——即高带宽闪存——这一新一代基于NAND的存储产品同步进行,它将大容量与高带宽服务架构相结合。真正的战略意图在此显露无遗。
AI推理几乎完全是读取主导的。经典模式是:一次性加载模型权重,然后对它们发出数十亿次读取请求。HBF正是为这种工作负载而设计。当与H-TPU控制的SoC结合时,系统可以提前预取数据并管理缓冲区,将NAND固有的访问延迟隐藏在计算流水线之后。
SK海力士的 claim 大胆但技术上自洽:控制器在整个服务路径中保留请求上下文,实质上是将裸NAND闪存容量转化为可用的AI内存资源。在实际意义上,这意味着在某些推理工作负载中对昂贵HBM的依赖减少,并为数据中心降低总体拥有成本提供了一条路径。
谁赢谁输
在这个场景中,最显而易见的赢家自然是SK海力士自身。多年来,该公司一直在内存榜单顶端——DRAM和NAND皆如此——而计算的故事则属于NVIDIA、AMD和Google的定制硅片。H-TPU和HBF代表了一次向上游的跃迁:从供应被他人处理器消耗的内存,到构建调度这些内存流动的智能。
NVIDIA不会被一块SSD控制器芯片取代。但SK海力士所描述的架构确实挑战了一个假设:内存和计算是可以独立扩展的分离层次。如果存储能够智能地预取数据、管理缓冲区并隐藏延迟,那么对纯计算方案——以及它们所需的内存带宽——的压力便会略有缓解。这是微妙的转变,但在数据中心经济学中,微小转变会累积放大。
Google已经设计TPU并在领域专用控制器方面经验丰富,是最接近的参照对象。但SK海力士的优势不同:规模。该公司是全球最大的内存制造商,与每家主要云服务商和芯片设计公司的关系早已确立。H-TPU不是赌注——它是拥有真实制造规模支撑的垂直整合举措。
如果要说输家,那就是那些从当前内存与计算分层中获益最多的公司。Phison和Silicon Motion等SSD控制器IP供应商面临直接挑战。那些鼓吹"更快的GPU是唯一值得拉动的杠杆"的公司也一样。
接下来会发生什么
SK海力士在ISOCC上并未公布H-TPU的发货日期或商用客户。这场演示是架构层面的——是信号,而非产品发布。作为首次亮相这很恰当,但也意味着验证将在未来12到18个月内到来。
关键的考验在于:云服务商是否将HBF加H-TPU的组合采纳为标准推理加速路径。如果是,SK海力士将不再只是一家具内存供应商——而将成为AI硬件栈的联合设计者。如果不是,H-TPU就只是一篇有趣的架构论文,现状保持不变。
无论如何,方向已经清晰。AI硬件竞赛不再只是关于谁制造最快的GPU,而是关于谁掌控整条数据通路——从GPU的内存总线一直延伸到NAND闪存。SK海力士刚刚声明,它意图掌控下半程。