Diamond Rapids de Intel: 256 núcleos y 1,28 GB de caché que redefinen los procesadores de servidor
Intel ha presentado Diamond Rapids, un procesador Xeon para servidores de nueva generación que integra 256 núcleos y un impresionante 1,28 GB de caché de último nivel. Construido sobre una nueva arquitectura 3D con tiles usando el proceso Intel 18A-P, este chip marca un gran salto en potencia de computación para centros de datos.
Una bestia toma forma
Intel no anunció Diamond Rapids en silencio. En la conferencia Hot Chips del 25 de agosto, la compañía reveló lo que constituye su procesador de centro de datos más agresivo hasta la fecha: un chip con hasta 256 núcleos y una astronómica cantidad de 1,28 GB de caché de último nivel. Las propias especificaciones merecen los titulares. Esa caché es lo suficientemente grande como para contener la imagen completa de un sistema operativo significativo en memoria. También es una señal clara de que Intel pretende dominar el segmento de servidores de alta gama mediante escala pura.
La cobertura occidental hasta ahora ha sido escasa. Pero los detalles que emergen de la presentación cuentan una historia coherente sobre hacia dónde se dirige Intel con su estrategia de servidor x86, y qué está dispuesto a hacer para mantenerse competitivo frente a AMD y la creciente presión de las arquitecturas basadas en ARM, como Ampere y Amazon Graviton.
Cómo está construido Diamond Rapids
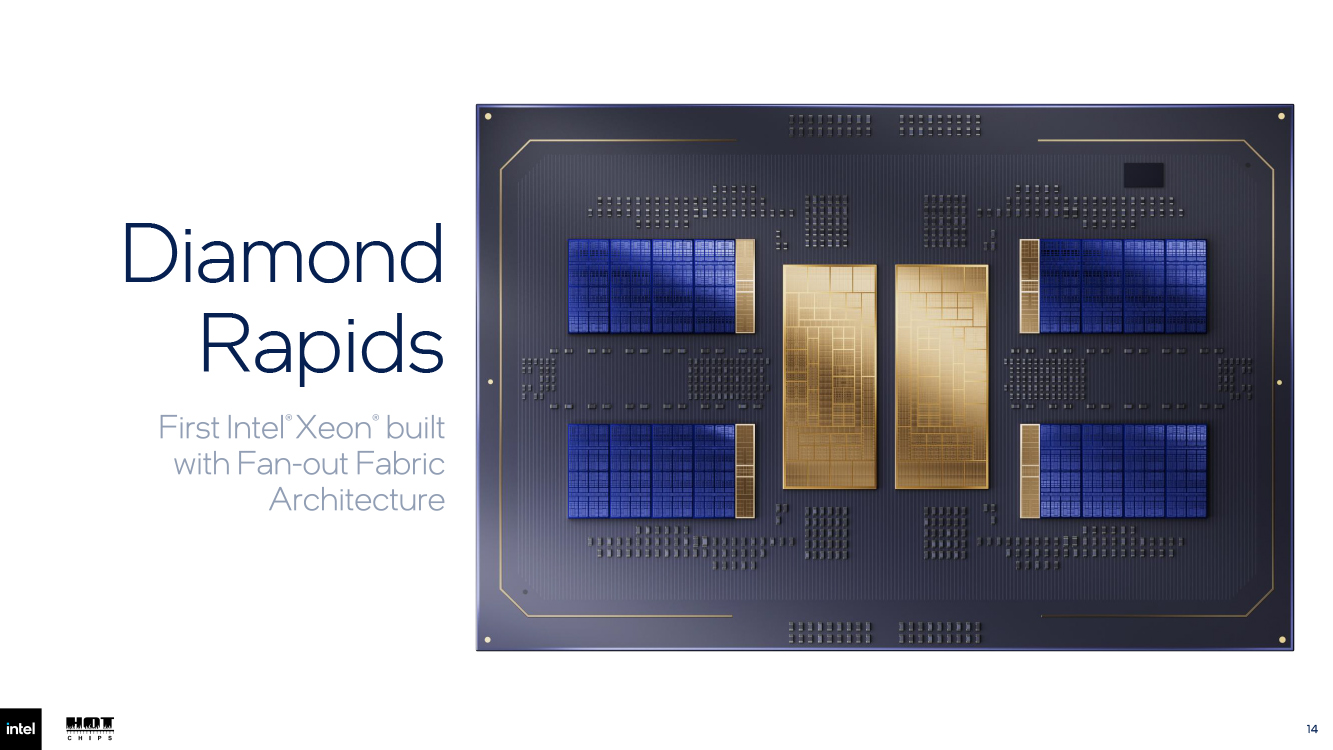
Diamond Rapids abandona el enfoque de die monocromático que definía a las generaciones anteriores de Xeon. En su lugar, recurre a lo que Intel denomina arquitectura Fan-out Fabric, un diseño que separa la lógica de computación del tejido de memoria y E/S, y los conecta mediante interconexiones de alto ancho de banda.
El fundamento es el Compute Building Block, o CBB. Cada CBB alberga cuatro chiplets de núcleo apilados verticalmente sobre una base tile. La conexión vertical utiliza lo que Intel llama Hybrid Bonding Interface, basada en su tecnología de empaquetado 3D Direct Foveros. Esto refleja la filosofía detrás del 3D V-Cache de AMD: caminos verticales más cortos significan menor latencia y menor consumo energético cuando los núcleos intercambian datos con su caché compartida.
La base tile se conecta horizontalmente a un Fabric Hub tile mediante una Die-to-Die Interface que usa UCIe-S a 16G, corriendo sobre trazas de cobre en el sustrato. Este bus horizontal transporta tráfico de memoria y E/S entre los bloques de computación y el resto del sistema.
La partición a nivel de tile importa porque cada bloque puede fabricarse ahora en el nodo de proceso que mejor se adapte a su función. Los chiplets de núcleo usan Intel 18A-P, una variante del proceso 18A visto en la serie consumer Panther Lake Core Ultra 3. La base tile usa Intel 3-T, y el Fabric Hub usa Intel 3 estándar. Este es el modelo chiplet funcionando como originalmente se concibió: optimizando costos al emparejar proceso con propósito.
Qué significa realmente 18A-P
Intel 18A-P no es un proceso para chips consumer. Es un refinamiento dirigido de 18A para lógica de alto rendimiento y bajo consumo. Intel afirma varias mejoras respecto al nodo 18A base: una quinta opción adicional de umbral de voltaje lógico entre ULVT y LVT, una reducción del 33 % en la variación de rendimiento de fabricación, y ganancias específicas del 18 % en reducción de potencia, 9 % en rendimiento y 20 a 40 % en mejora de resistencia térmica.
La gestión de energía se divide en cuatro dominios DVFS independientes — Núcleo, CBB uncore, E/S y Memoria — lo que permite al chip throttlear o hacer boost de secciones individuales de forma autónoma. Los dominios Núcleo y CBB uncore han ganado un nuevo estado idle que preserva la caché L2 mientras prioriza el comportamiento turbo clock. Son refinamientos sutiles pero importantes para un chip que podría consumir potencia significativa bajo carga.
La configuración de núcleos y memoria
Cada chiplet de núcleo contiene hasta 16 núcleos. Cuatro chiplets se ubican en una base tile, creando un CBB con 64 núcleos. Cuatro CBBs caben en un paquete, alcanzando el máximo de 256 núcleos. El soporte de memoria escala a 16 canales de DDR5 a hasta 8.000 MT/s, o MRDIMM a 12.800 MT/s, entregando un ancho de banda pico de bus de memoria de 1,6 TB/s.
Esa cifra de ancho de banda no es abstracta. Posiciona a Diamond Rapids para alimentar el tipo de cargas de trabajo hambrientas de memoria — inferencia de modelos de lenguaje grandes, analítica en tiempo real, bases de datos en memoria — que han estado exprimiendo hasta agotar los diseños de servidores tradicionales.
Para aceleración de IA, el chip soporta conjuntos de instrucciones AMX y AVX-10.2, incluyendo tipos de datos FP8, FP16 y BF16. Esto significa que las cargas de trabajo de inferencia de IA limitadas por CPU, que han crecido en importancia a medida que cambian el tamaño de los modelos y las demandas de servicio, pueden ejecutarse de forma nativa sin necesidad de descargar a aceleradores discretos en cada caso.
Conectividad y expansión
Diamond Rapids proporciona 128 lanes de PCIe 6.0, junto con soporte CXL 3.0 y UPI 3 para escalado multiprocesador. ocho lanes adicionales de PCIe 4.0 están disponibles para periféricos legacy o de bajo ancho de banda. Las características de seguridad incluyen TDX y TDX Connect para computación confidencial, SGX para ejecución en enclave, y aceleradores de hardware para QAT, DSA e IAA.
Quizás la característica más significativamente práctica para ingenieros de software es la habilitación de Intel APX — Advanced Performance Extensions. Anunciado en 2023 pero aún no completamente realizado en silicio shipped, APX duplica el número de registros de propósito general, introduce instrucciones de tres operandos que eliminan copias de datos redundantes, y añade soporte para instrucciones condicionales y branches absolutos de 64 bits. El efecto neto es una reducción medible en el conteo de instrucciones para ciertas cargas de trabajo, lograda sin cambiar el código de la aplicación más allá de recompilar.
Quiénes ganan y quiénes pierden
El ganador inmediato es cualquier operador de datacenter que ejecute cargas de trabajo que escalan con el conteo de núcleos y se benefician de una caché on-die masiva. Los administradores de bases de datos, proveedores de nube ejecutando datasets in-memory grandes, y operadores de inferencia de IA encontrarán a Diamond Rapids directamente relevante. Los 1,28 GB de caché podrían reducir significativamente la latencia de acceso a memoria para aplicaciones sensibles a caché, que a menudo es el cuello de botella en despliegues del mundo real.
Los procesadores EPYC líderes actuales de AMD, aunque también usan diseños chiplet, aún no igualan esta densidad de núcleos o capacidad de caché en un solo socket. Eso le da a Diamond Rapids una ventaja de rendimiento en el extremo muy alto, al menos en papel.
Los competidores ARM de Intel, incluyendo Ampere y Qualcomm, enfrentan presión renovada. La pregunta para ellos es si los ecosistemas de software construidos alrededor de ARM pueden justificar el cambio cuando las ofertas x86 como esta continúan cerrando la brecha de rendimiento mientras preservan la compatibilidad de código existente.
Qué sigue
Diamond Rapids no ha shipped. El anuncio en Hot Chips fue una revelación de arquitectura, no un lanzamiento de producto. La disponibilidad real, precios y números de rendimiento llegarán después. Las afirmaciones de Intel sobre las mejoras de 18A-P son cifras de fábrica; la verificación independiente será determinante.
Pero la dirección arquitectónica es innegable. Intel está invirtiendo fuertemente en empaquetado 3D, diversidad de procesos entre tiles y expansión de jerarquía de caché. La estrategia no es perseguir la velocidad de reloj por sí sola, sino construir un procesador que pueda absorber complejidad mediante escala y organización inteligente de memoria. Si la ejecución coincide con el plano, Diamond Rapids podría redefinir las expectativas sobre lo que un procesador de servidor x86 de un solo socket puede hacer.