英特尔Diamond Rapids:256核与1.28GB缓存重新定义服务器CPU
英特尔发布了Diamond Rapids,一款下一代至强服务器处理器,搭载256个核心和惊人的1.28GB三级缓存。基于采用Intel 18A-P工艺的全新3D tile架构,标志着数据中心算力迈入重大飞跃。
巨兽成形
英特尔并没有悄无声息地发布 Diamond Rapids。在8月25日的 Hot Chips 大会上,该公司展示了迄今为止最具侵略性的一款数据中心处理器——一款拥有最高256个核心、以及高达1.28GB三级缓存的芯片。光是这项规格就足以成为头条新闻。这颗缓存足以将一份相当规模的操作系统镜像完整地保留在内存中。它同时也是一个明确信号:英特尔意图以纯粹的规模优势主导高端服务器市场。
西方媒体的报道目前较为稀疏。但从演示中浮现的细节勾勒出一个清晰的故事,揭示了英特尔在x86服务器战略上的方向,以及它愿意为了在AMD和ARM架构(如Ampere和Amazon Graviton)日益增长的压力下保持竞争力而做什么。
Diamond Rapids 是如何构建的
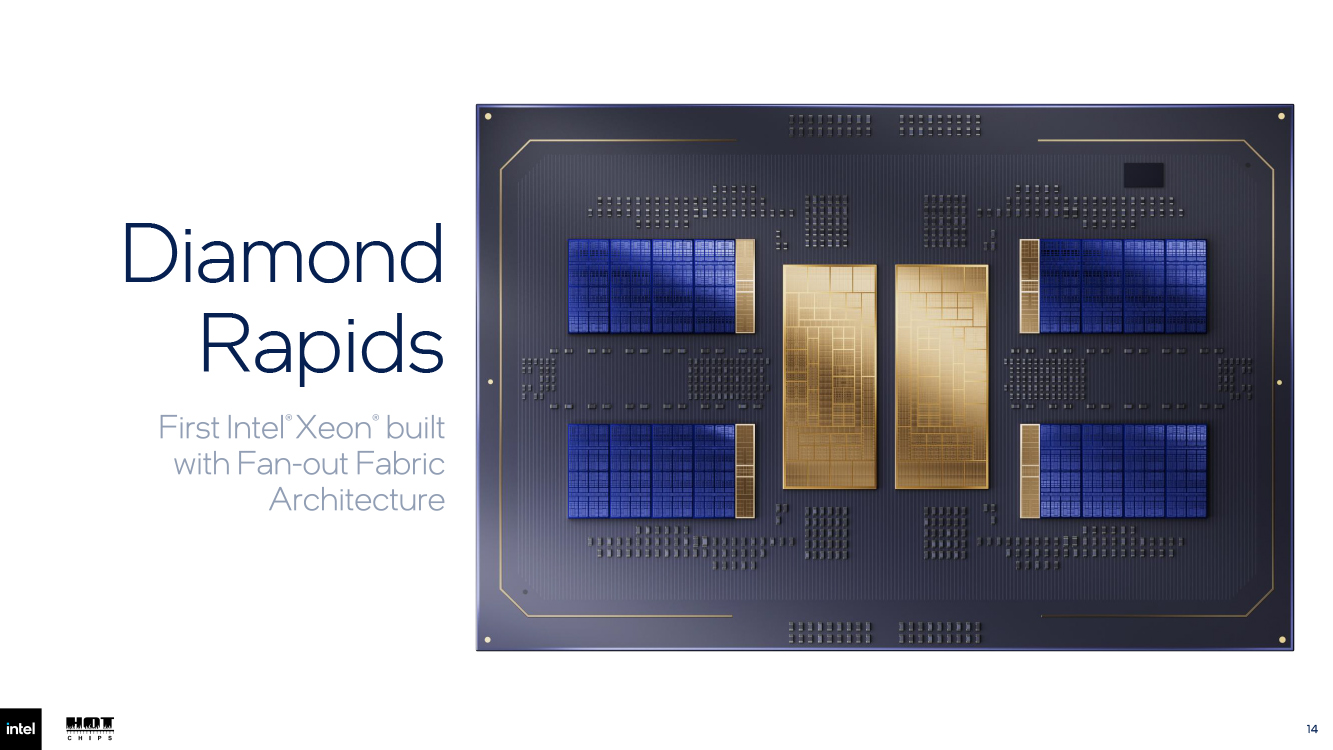
Diamond Rapids 摒弃了此前Xeon世代赖以定义的单片式die设计,转而采用英特尔所称的 Fan-out Fabric 架构——一种将计算逻辑与内存及I/O架构分离,并通过高带宽互连接口相连的设计。
其基础是计算构建模块(Compute Building Block,简称CBB)。每个CBB将一个包含四个核心chiplet的堆叠结构垂直置于一个基座tile之上。垂直连接采用了英特尔所谓的混合键合接口(Hybrid Bonding Interface),基于其Foveros 3D Direct封装技术。这一理念与AMD的3D V-Cache异曲同工:更短的垂直路径意味着核心与共享缓存之间通信时延迟更低、能耗更少。
基座tile再通过基于UCIe-S、速率达16G的Die-to-Die接口,水平连接到一个Fabric Hub tile,信号通过基板上的铜质走线传输。这条水平总线承载计算模块与系统其余部分之间的内存流量和I/O流量。
Tile级别的划分至关重要,因为每个模块现在都可以采用最契合其功能的工艺节点进行制造。核心chiplet采用Intel 18A-P,它是 consumer端 Panther Lake Core Ultra 3系列中所见的18A工艺的衍生版本。基座tile采用Intel 3-T,而Fabric Hub则使用标准Intel 3工艺。这正是chiplet模型最初设想的运作方式——通过将工艺与用途相匹配来优化成本。
18A-P 究竟意味着什么
Intel 18A-P 并非消费级芯片工艺。它是针对高性能、低功耗逻辑对18A进行的精准优化。英特尔声称其在基础18A节点之上有多项改进:在ULVT和LVT之间增加了第五个逻辑电压阈值选项,制造性能方差降低了33%,并在功耗降低方面提升18%、性能提升9%、热阻改善20%至40%。
电源管理被划分为四个独立的DVFS域——Core、CBB uncore、I/O和Memory——允许芯片独立地限制或提升各个区域。Core和CBB uncore域获得了一个新的空闲状态,可在优先维持turbo时钟行为的同时保留L2缓存。这些是细微但重要的优化,对于一款在高负载下可能消耗显著电力的芯片而言尤为重要。
核心数量与内存配置
每个核心chiplet容纳最多16个核心。四个chiplet位于一个基座tile上,构成一个拥有64核心的CBB。四个CBB集成在一个封装中,达到最高256核心的上限。内存支持扩展至16通道DDR5,最高8,000MT/s,或MRDIMM 12,800MT/s,提供1.6TB/s的峰值内存总线带宽。
这一带宽数字并非空洞的参数。它使Diamond Rapids能够支撑那些极度依赖内存的工作负载——大语言模型推理、实时分析、内存数据库——而这些正是不断挤压传统服务器设计生存空间的应用场景。
在AI加速方面,该芯片支持AMX和AVX-10.2指令集,包括FP8、FP16和BF16数据类型。这意味着CPU密集型AI推理工作负载——随着模型规模和服务需求的变化而其重要性日益凸显——可以在没有离散加速器的情况下原生运行。
连接性与扩展
Diamond Rapids 提供128条PCIe 6.0通道,支持CXL 3.0和UPI 3以实现多处理器扩展。另有八条PCIe 4.0通道用于传统设备或低带宽外设。安全功能包括用于机密计算的TDX和TDX Connect、用于飞地执行的SGX,以及用于QAT、DSA和IAA的硬件加速器。
对软件工程师而言,也许最具实际意义的特点是Intel APX(Advanced Performance Extensions,高级性能扩展)的启用。APX在2023年宣布但尚未在量产硅片中完全实现,它将通用寄存器的数量翻倍,引入了消除冗余数据拷贝的三操作数指令,并增加了对条件指令和64位绝对分支的支持。最终效果是在无需更改应用程序代码(仅需重新编译)的情况下,对某些工作负载实现可测量的指令数量减少。
谁赢谁输
直接的赢家是那些工作负载可随核心数扩展、并从片上巨大缓存中受益的数据中心运营商。数据库管理员、运行大规模内存数据集的云服务商以及AI推理运营商将发现Diamond Rapids具有直接的相关性。1.28GB的缓存可以显著降低对缓存敏感应用的内存访问延迟,而这往往是现实部署中的瓶颈所在。
AMD目前领先的EPYC处理器虽然也采用chiplet设计,但在单个插槽中尚未达到这样的核心密度或缓存容量。这意味着Diamond Rapids在顶级性能层面至少纸面上具备性能优势。
英特尔的ARM竞争对手,包括Ampere和Qualcomm,将面临 renewed pressure。它们需要回答的问题是:当x86产品(如Diamond Rapids)不断缩小性能差距的同时又保持现有代码兼容性时,围绕ARM构建的软件生态是否还能证明迁移的合理性。
接下来会发生什么
Diamond Rapids 尚未出货。Hot Chips的发布是一次架构亮相,而非产品上市。实际的上市时间、价格和性能数据将于稍后公布。英特尔关于18A-P改进的主张属于工厂规格数据;独立的验证至关重要。
但架构方向毋庸置疑。英特尔正在大力投入3D封装、跨tile的工艺多样性以及缓存层级扩展。其战略并非单纯追逐时钟频率,而是构建一款能够通过规模和智能内存组织来吸收复杂性的处理器。如果执行力与蓝图相符,Diamond Rapids有可能重新定义单插槽x86服务器处理器的性能预期。