NVIDIA se ajusta por la escasez de memoria: los costes de IA acaban de cobrar realismo
NVIDIA sube los precios de sus servidores de IA un 15% porque ya no puede absorber el coste de la escasa memoria HBM. Este cambio señala que los fabricantes de chips han perdido poder de fijación de precios frente a un reducido grupo de productores de memoria, y cada empresa de IA en la cadena sentirá el impacto.
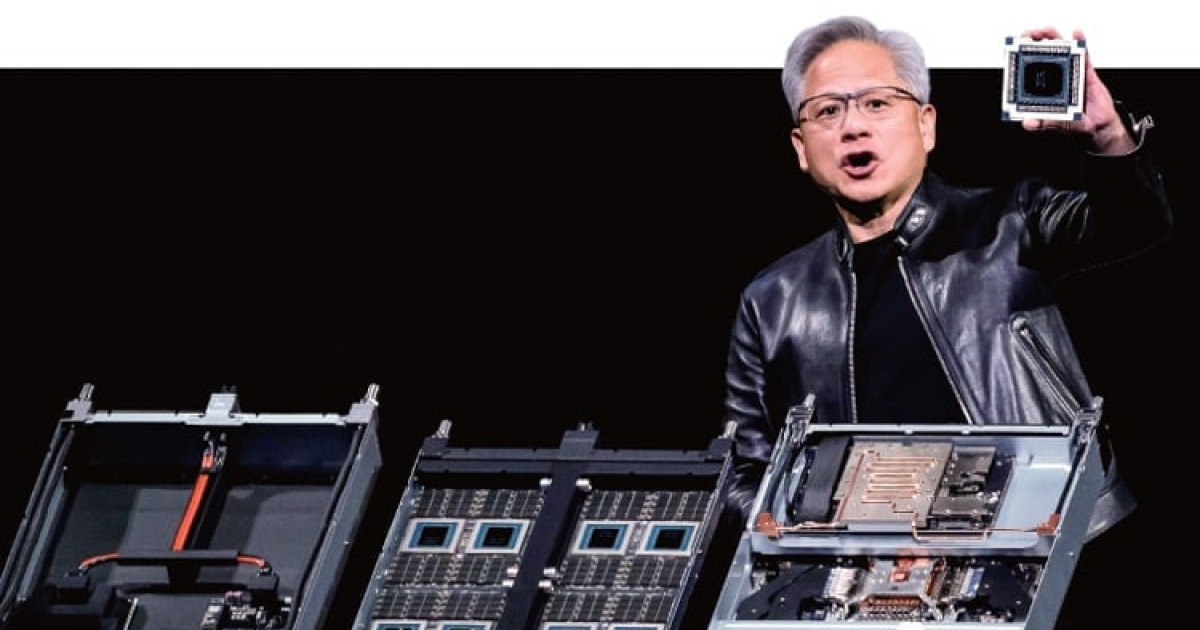
El cuello de botella ya no es el chip
NVIDIA anunció — a través de sus socios de fabricación, al menos — que sube los precios de los servidores de IA en un 15% a partir de los envíos a principios del próximo año. La razón no es la demanda de GPU. Es todo lo contrario: la memoria ya no puede seguir el ritmo.
Esto importa más que el porcentaje del titular. Durante años, NVIDIA mantuvo un poder de precio efectivo sobre la cadena de semiconductores de IA. Controlaba la arquitectura de la GPU, la pila de software y la integración. La memoria era una partida contable, no una palanca. Ahora, los tres fabricantes de memoria —Samsung, SK Hynix y Micron— se sientan colectivamente al otro lado de esa ecuación, y su cuello de botella determina cuántos servidores puede enviar NVIDIA, a qué precio y a quién.
Bloomberg informó que Microsoft, Google y Oracle fueron notificados del aumento. Tanto la plataforma actual Grace Blackwell como la próxima generación de arquitectura Vera Rubin se ven afectadas. Apple y Qualcomm ya han tomado la misma dirección para sus productos. La autoridad para fijar precios en el hardware de IA ha cambiado silenciosamente.
Por qué la memoria ganó la tectónica
La memoria de alto ancho de banda, o HBM, es el componente no negociable dentro de cada acelerador de IA moderno. La física de los modelos de transformadores requiere enormes cantidades de datos para moverse dentro y fuera de los arrays de cómputo de GPU cada milisegundo. Sin suficiente HBM, un chip de primera categoría es solo un ladrillo costoso.
La demanda se disparó cuando todos los principales proveedores de nube y empresas de IA construyeron centros de datos en paralelo. Samsung, SK Hynix y Micron están ampliando la producción, pero la fabricación de semiconductores no escala con un ciclo de presupuesto trimestral. Las fábricas verdes (greenfield), el equipamiento especializado y el aumento del rendimiento toman años. Los plazos de entrega de la memoria son simplemente más largos que los de la GPU, y la brecha se está ampliando.
El resultado es una presión estructural. La memoria es la restricción, no la GPU. Y en una cadena de suministro, la restricción fija el precio.
Quiénes ganan, quiénes pierden
El ganador inmediato es el triopolio de la memoria. Su posición de negociación es más fuerte que en una década. No solo están suministrando componentes —están poniendo un tope a la producción de la empresa de hardware más valiosa del mundo.
NVIDIA pierde la capacidad de absorber los aumentos de costos en sus márgenes. La empresa ha precificado configuraciones de servidores con una suposición implícita de que los costos de los componentes serían manejables. Esa suposición ya no se sostiene. Aun así, NVIDIA probablemente trasladará el aumento en lugar de absorberlo, lo que significa que sus clientes —proveedores de nube, empresas y startups de IA— sentirán el impacto completo.
La gran tecnología solo gana si ya aseguró asignaciones de memoria hace meses. Amazon, Microsoft, Google y Meta han estado acumulando HBM y construyendo aceleradores internos en parte para reducir la dependencia de NVIDIA. Sus chips auto-desarrollados también requieren HBM y DRAM, lo que significa que la crisis de memoria se profundiza incluso mientras intentan diversificarse lejos de NVIDIA. Más chips en el ecosistema no significa más servidores. Significa más demanda de memoria, lo que significa más presión sobre los mismos tres proveedores.
Las startups y las compañías de IA más pequeñas pierden más. Un aumento del 15% en el precio de los servidores con hardware de próxima generación no es un golpe proporcional en todos los presupuestos. Es una prueba de umbral. Las empresas que calculaban sus modelos de infraestructura alrededor de los costos actuales de los servidores deberán revisarlos al alza. Algunas retrasarán la contratación. Algunas retrasarán las ejecuciones de entrenamiento. Unas pocas no sobrevivirán a la recalibración.
Las matemáticas del centro de datos
Deinformation estimó que el aumento de precios añade al menos $5 mil millones al costo de construcción de un solo centro de datos de IA de un gigavatio. Ese no es un número abstracto. Es capital real que debe conseguirse, servirse o redirigirse. Para los operadores que cargan con deuda o responden ante accionistas, $5 mil millones por sitio cambian la viabilidad del proyecto.
El costo no termina en la construcción. Los gastos operativos también suben, porque el precio de los servidores influye en el alquiler que los proveedores de nube cobran por el cómputo de GPU. Si un servidor de IA cuesta un 15% más para comprarlo, la tarifa por hora para alquilarlo de AWS, Azure o GCP reflejará eso —probablemente con un margen adicional. Las ejecuciones de entrenamiento, las cargas de trabajo de inferencia y los trabajos de ajuste fino se vuelven más caros al mismo tiempo.
Eso crea un círculo de retroalimentación. Los costos más altos de cómputo ralentizan la velocidad de iteración. La iteración más lenta ralentiza el desarrollo de modelos. El desarrollo de modelos más lento empuja a algunos equipos hacia arquitecturas más pequeñas, menos voraces en memoria, o los aleja del entrenamiento en instalaciones propias por completo. El mercado se adapta, pero la adaptación tiene un costo, y el costo recae sobre quienes menos pueden permitírselo.
Qué sucede después
Tres cosas son probables. Primero, los precios de la memoria se mantendrán elevados al menos durante el próximo ciclo de ampliación de fábricas. Samsung y SK Hynix han anunciado planes de capacidad, pero esas instalaciones no producirán HBM en volumen hasta dentro de dos o tres años. El timing de Micron es similar. La oferta se ajustará, no se aflojará, antes de expandirse.
Segundo, NVIDIA enfrentará presión continua para either subir precios nuevamente o reducir los tamaños de configuración. La empresa podría responder ofreciendo una gama inferior de HBM de sus aceleradores actuales o futuros, creando efectivamente una segunda banda de precios en su línea de servidores. Eso permitiría a los clientes con presupuesto restringido acceder al silicio de NVIDIA con un rendimiento de memoria reducido, mientras se preserva la gama premium para las empresas que pueden pagar.
Tercero, la industria acelerará las alternativas —pero las alternativas no son sustitutos a corto plazo. Cerebras, Graphcore y los aceleradores chinos domésticos existen, pero ninguno ha escalado a los requisitos de memoria o a la madurez de software que NVIDIA domina. Los chips auto-desarrollados de la gran tecnología son un juego a más largo plazo. Pueden reducir la dependencia de NVIDIA con el tiempo, pero no resuelven el cuello de botella de memoria. Si acaso, lo amplifican.
La señal más amplia
El aumento de precios del 15% es un evento proxy. La verdadera historia es que la persona que controla el recurso más escaso en una cadena de suministro de IA ahora marca el paso —y el precio. Durante años, NVIDIA fue esa persona. Ahora lo son tres compañías en Seúl y Taiwán y una en Texas.
Cada plan de IA construido sobre la suposición de que los costos de hardware se estabilizarían o disminuirían está equivocado. El próximo año estará definido por la asignación de memoria tanto como por la asignación de GPU. Las empresas que aseguraron HBM temprano enviarán antes, entrenarán más rápido y retendrán una ventaja de costos. Las empresas que no lo hicieron pagarán una prima —y pueden no recuperarla rápidamente.
El cuello de botella se ha movido. Los precios están poniéndose al día. Todos en la cadena de suministro deben ajustar ahora.