NVIDIA cede ante la escasez de memoria y sube los precios de servidores de IA un 15%
NVIDIA aumenta al menos un 15 % los precios de sus servidores de IA, reflejo del creciente poder de los fabricantes de memorias Samsung, SK Hynix y Micron. El cambio implica un encarecimiento notable de los costes globales de entrenamiento e inferencia de inteligencia artificial.
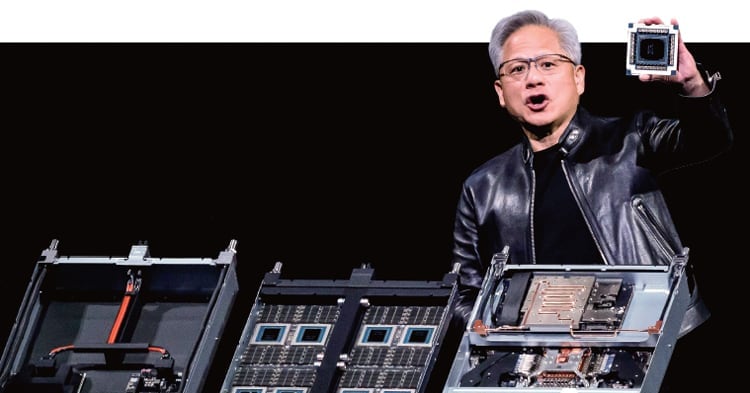
El verdadero cambio de poder en hardware de IA ya ocurrió
NVIDIA aumentó los precios de sus servidores de IA al menos un 15%, efectivas para los envíos que comiencen el próximo año. A simple vista, esto parece una transferencia estándar de costos de la cadena de suministro. No lo es. Por primera vez, la empresa que dominó los precios de los semiconductores de IA durante años ya no es la que fija los precios. Los fabricantes de memoria ahora lo hacen.
Bloomberg reportó el aumento de precios el 22 de agosto, citando a proveedores de fabricación que suministran a operadores de centros de datos del calibre de Microsoft, Google y Oracle. Tanto las plataformas actuales Grace Blackwell como las de próxima generación Vera Rubin se ven afectadas. La causa es clara: los precios de la HBM (memoria de alto ancho de banda) y de la DRAM para servidores se dispararon porque todos los hiperscalers compiten para construir centros de datos de IA, y la capacidad de memoria no logra seguir el ritmo.
Este es el momento en que la narrativa del hardware de IA finalmente alcanzó la realidad física. Durante tres años, la historia dominante fue el rendimiento por dólar de la GPU, las guerras de benchmarks y el foso Cada vez más profundo de NVIDIA alrededor de CUDA. El subtexto, la dependencia de una cadena de suministro de memoria frágil, ahora se convirtió en el texto principal. El cuello de botella se desplazó hacia downstream, y el poder de fijación de precios lo siguió.
Por qué la memoria ahora tiene las cartas
Un acelerador de IA solo entrega rendimiento cuando puede ingerir datos masivos de forma rápida. Eso requiere grandes volúmenes de HBM empaquetados directamente sobre el paquete de la GPU. Sin suficiente, no puedes enviar un servidor funcional. Samsung, SK Hynix y Micron producen cada uno la mayor parte de la HBM del mundo. Juntos, han ganado un apalancamiento que el lado de las GPU nunca había tenido antes.
Construir fábricas de HBM e instalar equipos toma años. Incluso cuando las tres empresas de memoria aceleren la expansión de capacidad, la oferta no alcanzará la demanda hasta bien entrado el próximo ciclo. Esa brecha es lo que obliga la mano de NVIDIA. Apple y Qualcomm ya han usado la misma lógica de escasez de memoria para subir sus propios precios de producto. NVIDIA se unió a esa línea ahora.
La mecánica es nítida. HBM3e, la generación actual requerida para aceleradores de IA de gama alta, demanda capacidad de envasado avanzado que está concentrada en Corea y Japón. La unión por TSV (vía a través del silicio), el proceso que apila las capas de HBM, es sensible al rendimiento y lenta para escalar. Cada generación de HBM multiplica la complejidad. Los gigantes de la memoria están invirtiendo decenas de miles de millones, pero la curva de retorno se mide en incrementos multianuales, no trimestrales. El ciclo de diseño de NVIDIA es rápido. El ciclo de construcción de la memoria es glacial. Esa asimetría es la fuente del cambio de apalancamiento.
La pregunta de 50.000 millones de dólares por centro de datos
DeInformation estimó que el aumento de precios podría sumar al menos 50.000 millones de dólares al costo de construcción de un solo centro de datos de IA de un gigavatio. Esa no es una cifra abstracta. Los campus de un gigavatio son exactamente el tamaño que Microsoft, Amazon y Google están planeando ahora mismo. Un incremento del 15% en hardware se traduce en miles de millones en capital que o bien se absorben o bien se transfieren hacia abajo en la cadena.
Es probable que los proveedores de nube recuperen la mayor parte del aumento elevando las tarifas de alquiler de GPU. Eso significa que cada startup de IA, cada laboratorio de investigación y cada empresa que ejecute inferencia a través de una nube pública verá facturas más altas. Los costos de entrenamiento subirán primero y de manera más visible, porque los modelos intensivos en HBM consumen más memoria por FLOP. Los costos de inferencia seguirán a medida que los modelos crezcan y las demandas de throughput de tokens aumenten.
El efecto de segunda orden es más sutil y más dañino. Un aumento del 15% en el costo del hardware se compunde con otras presiones inflacionarias: energía, refrigeración, bienes raíces y mano de obra calificada. Los operadores de centros de datos que firmaron arrendamientos a largo plazo y acuerdos de energía fija con costos asumidos más bajos ahora están sumergidos. Algunos renegociarán. Otros absorberán pérdidas. Unos pocos retrasarán o cancelarán proyectos, creando una ola de anuncios de infraestructura de IA estancados que resonarán en las llamadas de ganancias durante los próximos cuatro trimestres.
Las ambiciones de chips propios de las grandes tecnológicas no resuelven esto
Amazon, Microsoft, Google, Meta y OpenAI están desarrollando o expandiendo aceleradores de IA personalizados para reducir la dependencia de NVIDIA. Eso es real. Pero los chips personalizados también requieren HBM y DRAM de servidor en volumen. Cada nuevo ASIC es otro bocado del mismo suministro de memoria restringido. La curva de demanda global de memoria se está tornando más pronunciada, no más plana.
Esto significa que la escasez de memoria no es un problema transitorio de NVIDIA. Es una restricción estructural en toda la construcción de infraestructura de IA. Incluso si un comprador se aleja de NVIDIA hoy, la factura mensual de la nube aún reflejará la misma presión de costos impulsada por la HBM. La narrativa de desacoplamiento, que la integración vertical te aísla de las restricciones de commodities, no se sostiene cuando el commodity es precisamente lo que hace que el chip funcione.
También hay un desfase de tiempos. Los programas de silicio personalizado generalmente tardan entre 18 y 36 meses en llegar a producción en volumen. Las expansiones de capacidad de memoria toman de tres a cinco años desde el anuncio hasta el despliegue. Los dos cronogramas no convergen. Los compradores que apostaron por chips personalizados para escapar del poder de fijación de precios de NVIDIA simplemente están intercambiando una dependencia por otra, y la nueva dependencia es más difícil de escapar porque está físicamente distribuida entre tres proveedores en dos países.
Quién gana. Quién pierde.
Samsung, SK Hynix y Micron ganan. Su poder de fijación de precios cambió de pasivo a decisivo. Ahora ellos establecen el cuello de botella.
NVIDIA pierde flexibilidad de margen. Su marca y su foso de software permanecen intactos, pero ya no puede absorber los costos de los componentes internamente. El aumento del 15% es un reconocimiento público de que la memoria, no el diseño de GPU, es la restricción vinculante.
Los hiperscalers, apretados en el medio, enfrentan mayor capex y mayor opex. Intentarán negociar acuerdos de suministro de memoria a largo plazo, lo que podría estabilizar algunos costos, pero favorecerá a los compradores más grandes y dejará expuestas a las empresas de IA de tamaño mediano.
Las pequeñas firmas de IA y los investigadores independientes pierden más. Las tarifas más altas de alquiler de GPU comprimen los presupuestos de experimentación. Las ejecuciones de entrenamiento de modelos que eran viables a los precios del año pasado se vuelven marginales. Esta es la consecuencia silenciosa del aumento de precios: eleva el costo de entrada para todos quienes no controlan su propia capacidad de centro de datos.
Los ganadores y perdedores se mapean limpiamente sobre una variable: la escala. Las firmas que puedan asegurar contratos de memoria a largo plazo, construir infraestructura propietaria o negociar asignación preferencial internalizarán el shock. Todos los demás pagarán la tasa al contado y verán deteriorarse su economía unitaria.
El rezago de inferencia que nadie está evaluando
La mayor parte del comentario se centra en los costos de entrenamiento, donde el dolor inmediato es visible. Pero el lado de la inferencia merece igual atención. A medida que los modelos crecen y las ventanas de contexto se expanden, la inferencia se vuelve cada vez más dependiente de la memoria. Un aumento del 15% en el costo del hardware no golpea la inferencia uno a uno —los proveedores de nube optimizan alrededor de la utilización— pero sí eleva el piso. Cada carga de trabajo de inferencia marginalmente rentable se convierte en una pregunta. Los modelos ligeros que sirven como puntos de entrada para desarrolladores y clientes empresariales enfrentarán la misma presión de costos que los modelos de vanguardia, solo expresada a través de líneas de facturación diferentes.
Esto crea un efecto de compresión en ambos extremos del mercado. El nivel superior absorbe costos mediante precios premium. El nivel inferior enfrenta un colapso de margen. El nivel intermedio, el espacio de trabajo de startups y equipos pequeños, es el que más se ve apretado. Es el segmento que impulsa la experimentación, y es el segmento que sentirá el dolor más agudo.
Qué sigue
Esperemos que los proveedores de memoria anuncien más compromisos de capacidad durante los próximos dos años. Nuevas fábricas en Japón, Estados Unidos y Corea del Sur ya están en varias etapas de planificación. Pero los plazos siguen siendo largos. El alivio práctico de la oferta no llegará antes de 2028, como mínimo.
Las arquitecturas Vera Rubin y Rubin Ultra de NVIDIA aún se enviarán. Solo costarán más. La capacidad de la empresa de exigir un premium depende de si su pila de software y el bloqueo del ecosistema permanecen lo suficientemente fuertes como para que los compradores acepten precios más altos. Hasta ahora, lo están haciendo.
La lección más profunda es simple. Los precios del hardware de IA nunca fueron solo una historia de GPU. Siempre requirieron memoria. El mercado ahora está valorando esa realidad. Cualquier quien construya infraestructura de IA debería planificar para una presión de costos sostenida, no una recuperación rápida. Las firmas que traten esto como un bache temporal serán sorprendidas. Las firmas que lo traten como la nueva base estarán preparadas.