La producción en masa del Groq 3 de NVIDIA reconfigura las cadenas de suministro de inferencia de IA
El acelerador de inferencia de IA Groq 3 LPX de NVIDIA ha entrado en producción en masa a través del proceso de 4 nm de Samsung Foundry y los sustratos FC-BGA de Samsung Electro-Mechanics. Este movimiento marca un cambio estratégico en la fabricación de chips de IA y un punto de inflexión importante para la industria de los semiconductores de Corea del Sur.
La discreta victoria de la fundición coreana
NVIDIA anunció el 24 de agosto que su acelerador de inferencia Groq 3 LPX ha comenzado a producirse en masa: un hito que parece menor sobre el papel, pero que representa una fisura significativa en los cimientos dominados por TSMC de la fabricación de chips de inteligencia artificial.
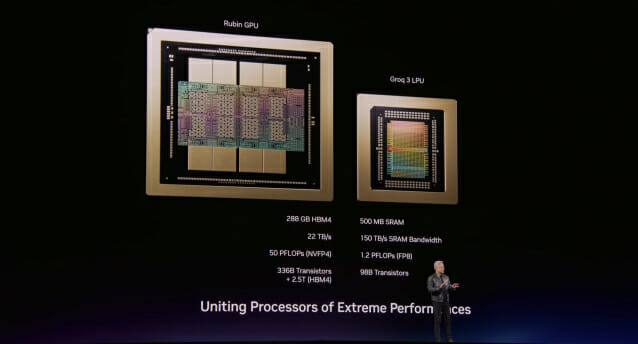
Groq fue fundada originalmente como una empresa independiente especializada en inferencia y adquirida por NVIDIA por unos 29 billones de wones ($20 mil millones) en una operación indirecta a finales del año pasado. El Groq 3 LPX es un sistema de inferencia a escala de rack que integra 256 unidades de procesamiento de lenguaje Groq 3 (LPU), diseñado específicamente para inferencia de modelos de lenguaje de alto rendimiento, no para las cargas de trabajo de entrenamiento que dominan los titulares.
Aquí es donde reside la verdadera señal: la historia manufacturera.
La jugada del 4 nm de Samsung Foundry da sus frutos
Samsung Foundry está produciendo el LPU Groq 3 en su proceso de 4 nanómetros (SF4X). La entrada inicial de obleas se estimó en aproximadamente 10.000 obleas por mes: una cifra modesta según los estándares de los programas de GPUs de entrenamiento de NVIDIA, que históricamente han fluido casi exclusivamente a través de los nodos más avanzados de TSMC.
Se espera que esa base crezca. Una fuente del sector familiarizada con la situación declaró a ZDNet Korea que Samsung Foundry planea aumentar la entrada de obleas para el LPU Groq a más de 15.000 mensuales el próximo año. Otra fuente señaló que la empresa ya está evaluando pedidos para un LPU de próxima generación, lo que consolidaría aún más los volúmenes.
Esto importa porque Samsung ha invertido años intentando demostrar que puede competir en la vanguardia junto a TSMC, tropezando con frecuencia por limitaciones de rendimiento y capacidad. El chip enfocado en inferencia de Groq es más simple que una GPU de entrenamiento: menor superficie de silicio, menos interconexiones y requisitos de sincronización más ajustados en lugar de rendimiento bruto, lo que podría representar una puerta de entrada más inteligente al nodo para Samsung que perseguir los últimos silicios de entrenamiento clase H100 de NVIDIA.
La trayectoria más amplia de Samsung Foundry refuerza esta lectura. El nodo de 4 nm de la compañía está completamente reservado hasta el próximo año, y la división busca un giro hacia la rentabilidad en la segunda mitad de 2026, según reportes previos de ZDNet.
Samsung Electro-Mechanics se lleva el embalaje
Mientras Samsung Foundry fabrica el silicio, Samsung Electro-Mechanics (SEMCO) proporciona el sustrato: el FC-BGA (flip-chip ball grid array) que conecta cada LPU a la placa. SEMCO comenzó la producción en masa durante el segundo trimestre tras asegurar el estatus de “primer proveedor” a principios de este año, una designación que le garantiza efectivamente la mayor parte del volumen de sustratos.
Los paquetes FC-BGA son cada vez más críticos para el silicio de IA. Ofrecen un rendimiento eléctrico y térmico muy superior en comparación con los paquetes tradicionales cableados, y a medida que los chips de inferencia presionan más en latencia y rendimiento, el sustrato ya no es un componente pasivo: moldea el rendimiento directamente.
Para SEMCO, una compañía que ha vivido durante décadas a la sombra de Samsung Foundry, conseguir una posición de primer proveedor en un producto vinculado a la marca NVIDIA es un ascenso poco común. También refuerza el argumento de que la competitividad semiconductora de Corea del Sur se está volviendo cada vez más basada en portafolio —fundición más embalaje más sustrato— en lugar de depender de un solo fabricante.
El primer cliente: Neovi y el mercado de inferencia empresarial
El primer comprador comercial del Groq 3 LPX es Neovi, un proveedor de inferencia en la nube con sede en Países Bajos que construye lo que denomina “Neovi Token Factory”, una plataforma de inferencia de IA de grado empresarial. Este detalle es revelador. Los primeros adoptantes de hardware especializado en inferencia no son los grandes hyperscalers ejecutando sus propios modelos; son proveedores boutique de nube de inferencia que compiten en velocidad y costo contra AWS Inferentia, Google TPU y las ofertas propias de NVIDIA basadas en H100.
El mercado de nube de inferencia está fragmentado y se mueve rápido. Actores como Together AI, Anyscale y Replicate han esculpido nichos, y las economías de la inferencia difieren drásticamente de las del entrenamiento: el costo marginal lo es todo, y el consumo de energía por token es una partida que hace o quiebra los márgenes. El enfoque de Groq —silicio personalizado para una carga de trabajo específica en lugar de una GPU de propósito general— es una apuesta a que la especialización ganará en costo por token a medida que crecen los tamaños de los modelos.
La elección de Neovi por Groq sobre alternativas señala que el mercado de hardware de inferencia aún no está definido, y que los clientes están dispuestos a diversificar su pila en lugar de comprometerse con un solo proveedor.
Vera Rubin y la jugada mayor
NVIDIA no presentó el Groq 3 LPX como un producto independiente. La compañía lo enmarcó explícitamente como complementario a su plataforma Vera Rubin, que comenzó a enviar en la segunda mitad de 2026. El mensaje es claro: Groq atiende el carril de inferencia, Vera Rubin el carril de entrenamiento, y juntos cubren todo el espectro de cargas de trabajo de IA.
Las pruebas de rendimiento con el modelo de código abierto Gemma 4 31B mostraron que el Groq 3 LPX producía 3.400 tokens por segundo: la mejor cifra de NVIDIA para ese modelo. Si ese margen se mantiene a medida que los modelos escalan a mayores conteos de parámetros está por verse, pero el número titular está diseñado para contrarrestar la narrativa persistente de que las GPUs son el único camino viable hacia una inferencia rápida.
Lo que esto significa para la cadena de suministro
Tres implicaciones se destacan.
En primer lugar, el doble rol de Samsung —fundición y sustrato— demuestra que la compañía puede proporcionar una pila de hardware integrada a un cliente que no es Samsung. Ese es precisamente el juego que TSMC ha seguido con Intel y otros, y Samsung ahora lo ejecuta en la alta gama del silicio de IA.
En segundo lugar, el aumento de 10.000 a 15.000 obleas para el LPU Groq es una fracción de lo que consumen las GPUs de entrenamiento de NVIDIA, pero es significativo para el nodo 4 nm de Samsung precisamente porque añade diversidad de mezcla. Las GPUs de entrenamiento y los LPU de inferencia tienen reglas de diseño, requisitos de prueba y perfiles de rendimiento diferentes. Una fundición que solo procesa un tipo de chip de IA es más vulnerable a los vaivenes de la demanda que una que atiende ambos.
En tercer lugar, el acuerdo con Groq plantea una pregunta silenciosa sobre la estructura de dependencia de NVIDIA. La compañía gastó $20 mil millones para adquirir una empresa cuyo hardware Samsung ahora fabrica. Esa no es una vulnerabilidad hoy, pero es un precedente que vale la pena observar: a medida que el portafolio de NVIDIA crece mediante adquisiciones, más de su silicio fluirá a través de socios que tienen sus propias bases de clientes e incentivos estratégicos.
El ángulo coreano
Para Corea del Sur, el anuncio de producción en masa del Groq 3 es una validación de una estrategia que ha estado bajo presión durante años. La recuperación de Samsung Foundry depende de conseguir clientes fuera de sus clientes semiconductores habituales. Samsung Electro-Mechanics necesita pedidos de sustratos de alto valor para justificar su ciclo de gasto de capital. Ambos ahora tienen un producto vinculado a la marca de IA más visible del mundo, fabricado en los nodos y paquetes propios de Samsung.
Los números aún son tempranos: 10.000 obleas al mes son una línea de salida, no una meta, pero la dirección es clara: la inferencia es la siguiente frontera para la competencia de fundiciones, y Samsung está posicionada para competir allí.