英伟达 Groq 3 量产,重塑 AI 推理供应链
英伟达 Groq 3 LPX AI 推理加速器已通过三星 Foundry 的 4nm 工艺和三星电机(Samsung Electro-Mechanics)的 FC-BGA 基板进入量产阶段。这一举措标志着 AI 芯片制造的战略转型,也是韩国半导体产业的重要拐点。
Quiet Foundry 之役:一座隐秘的胜利
NVIDIA 于 8 月 24 日宣布,其 Groq 3 LPX 推理加速器已开始批量生产——这一里程碑在纸面上看似微不足道,却代表着 AI 芯片制造格局中,台积电主导的基石出现了一道显著的裂痕。
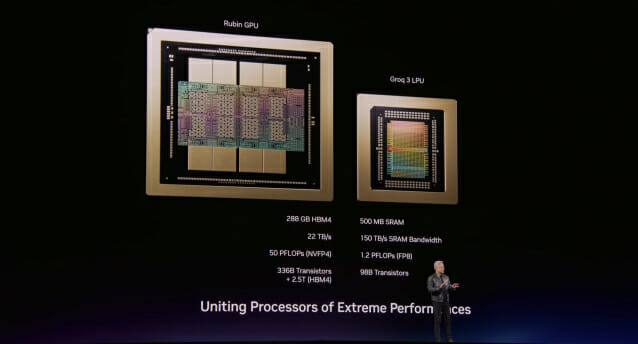
Groq 最初作为一家独立的推理专用公司成立,去年年底通过一笔迂回交易被 NVIDIA 以约 29 万亿韩元(约合 200 亿美元)的价格收购。Groq 3 LPX 是一款机架级推理系统,内置 256 个 Groq 3 语言处理单元(LPU),专为高吞吐量大语言模型推理而设计,而非目前占据头条的模型训练负载。
这场芯片的故事里,真正的信号藏在制造端。
三星代工 4nm 赌注奏效
三星代工正在以其 4 纳米工艺(SF4X)生产 Groq 3 LPU。初期晶圆投片量估计约为每月 1 万片——就 NVIDIA 训练 GPU 项目的规模而言,这个数字相对 modest,这些项目历来几乎全部流经台积电最先进的产线。
业内消息预计该数字将增长。据韩国 ZDNet 报道,熟悉该情况的行业消息人士透露,三星代工计划明年将 Groq LPU 的晶圆投片量提升至每月超过 1.5 万片。另有消息人士表示,该公司已在评估下一代 LPU 的订单,这将进一步锁定产量规模。
这很重要,因为三星多年来一直在努力证明自身有能力与台积电在前沿工艺上竞争,但屡屡因良率和产能瓶颈而受挫。Groq 这款专注于推理的芯片比训练 GPU 更简单——面积更小、互联更少、时序要求更严苛而非追求极限吞吐量——这对三星来说可能是一个比追逐 NVIDIA 最新 H100 级训练芯片更为明智的切入节点。
三星代工的整体轨迹也支持这一判断。据此前 ZDNet 报道,三星 4nm 节点已被全面预订至明年,且该部门目标是在 2026 年下半年实现盈利扭转。
三星电机拿下封装环节
在三星代工负责制造硅片的同时,三星电机(SEMCO)提供基板——即 FC-BGA(倒装芯片球栅阵列),负责将每个 LPU 连接到主板上。SEMCO 在今年早些时候获得"首选供应商"地位后,已于第二季度启动量产。这一 designation 实质上保证了它将获得最大份额的基板订单。
FC-BGA 封装对 AI 硅片日益重要。与传统的引线键合封装相比,FC-BGA 在电气和热性能方面表现更优,而且随着推理芯片对延迟和吞吐量的要求愈发严苛,基板不再是一个被动的组件——它直接影响性能表现。
对这家几十年来一直活在三星代工阴影下的公司而言,拿下与 NVIDIA 品牌绑定的产品的首选供应商资格,是一次罕见的向上跃升。这也进一步印证了一个观点:韩国半导体竞争力正日益体现为组合优势——代工、封装与基板并举——而非依赖单一制造商。
首位客户:Neovi 与企业推理市场
Groq 3 LPX 的首位商业买家是 Neovi,一家总部位于荷兰的云端推理提供商,正在构建其所谓的"Neovi Token Factory"——一个企业级 AI 推理平台。这一细节耐人寻味。推理专用硬件的早期采用者并非运营自有模型的超大规模云厂商,而是专注于速度和成本与 AWS Inferentia、Google TPU 以及 NVIDIA 自身基于 H100 的方案展开竞争的精品推理云服务商。
推理云服务市场碎片化且变化迅速。Together AI、Anyscale 和 Replicate 等玩家已 carve out 各自利基市场,推理的经济逻辑与训练截然不同:边际成本至关重要,每 token 的能耗是一笔决定盈亏的关键开支。Groq 的思路——为特定负载定制芯片而非采用通用 GPU——是一次押注:随着模型规模扩大,专业化将在每 token 成本上取胜。
Neovi 选择 Groq 而非其他方案,发出一个信号:推理硬件市场尚未尘埃落定,客户更愿意多元化其技术栈,而非押注单一供应商。
Vera Rubin 与更大的棋局
NVIDIA 并未将 Groq 3 LPX 呈现为一款独立产品。该公司明确将其定位为与 Vera Rubin 平台的互补方案,后者已于 2026 年下半年开始出货。信息传递十分清晰:Groq 负责推理赛道,Vera Rubin 负责训练赛道,两者共同覆盖完整的 AI 工作负载谱系。
使用开源 Gemma 4 31B 模型的基准测试显示,Groq 3 LPX 每秒可产生 3,400 个 token——这是 NVIDIA 在该模型上的最佳成绩。当模型扩展至更大参数量时,这一优势能否保持仍是未知数,但这一亮眼数据旨在回击那个根深蒂固的说法:GPU 是唯一可行的快速推理路径。
对供应链意味着什么
三方面的影响尤为突出。
首先,三星同时扮演代工厂和基板供应商的双重角色,证明它能够向非三星的客户提供一个集成硬件栈。这正是台积电对英特尔等客户执行的策略,而如今三星正在 AI 硅片的高端领域执行同样的打法。
其次,Groq LPU 从每月 1 万片到 1.5 万片的产能爬坡,仅占 NVIDIA 训练 GPU 消耗量的一小部分,但对三星的 4nm 节点而言意义重大——因为它增加了产品组合的多样性。训练 GPU 和推理 LPU 具有不同的设计规范、测试要求和良率特征。仅加工一类 AI 芯片的代工厂,比同时服务两类芯片的代工厂更容易受到需求波动的冲击。
第三,Groq 这笔交易引发了一个关于 NVIDIA 依赖结构的安静问题。NVIDIA 花费 200 亿美元收购了一家其硬件现由三星代工的公司。这目前并非漏洞,但这是一个值得关注的先例:随着 NVIDIA 通过收购不断扩大版图,其更多硅片将流经那些拥有自有客户群和战略利益的合作伙伴之手。
韩国视角
对韩国而言,Groq 3 量产的消息是对一项长期承压的战略的一次验证。三星代工要想复苏,必须吸引其常规半导体客户之外的客户;三星电机需要高价值的基板订单来支撑其资本支出周期。如今,两家公司都拿到了一款绑定全球最具知名度 AI 品牌的产品,在三星自家的产线和封装下制造。
数据尚处于早期阶段——每月 1 万片是起跑线,而非终点——但方向已经清晰:推理是代工厂竞争的下个前沿阵地,而三星已经就位,准备参与竞争。