El impulso de Nvidia a Samsung señala una nueva guerra de chips de IA
Nvidia ya está produciendo en masa sus chips de inferencia Groq3 LPX en Samsung Foundry, un movimiento que rompe su dependencia de TSMC y anuncia el inicio de una carrera armamentista de IA centrada en la inferencia. Los clientes ya están asegurados, incluidos Navius y SpaceXAI.
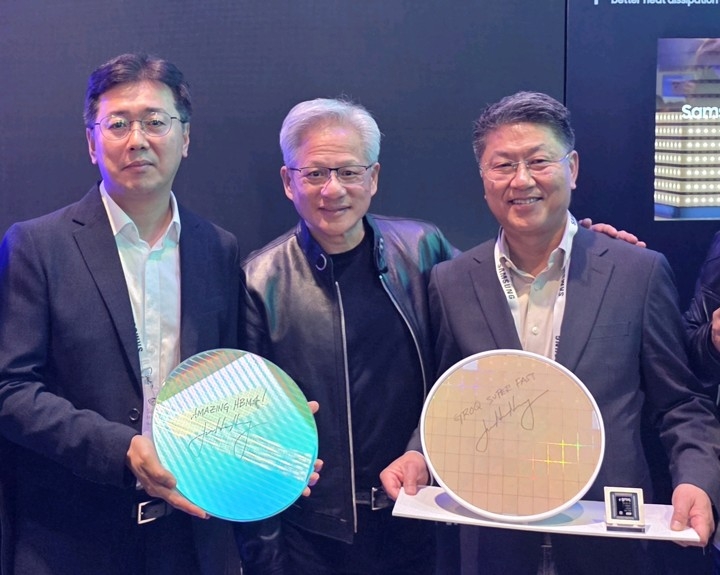
Nvidia acaba de reescribir su propio manual.
Nvidia anunció el jueves que ha entrado en producción masiva del acelerador de inferencia Groq3 LPX, fabricado íntegramente en Samsung Foundry, no en TSMC. La distinción ya no es un pie de página. Es el evento central.
El chip se construye alrededor de una tecnología que Nvidia adquirió mediante una compra indirecta de Groq a finales del año pasado. Las unidades de procesamiento de lenguaje (LPU) de Groq utilizan SRAM en lugar de DRAM, reduciendo drásticamente la latencia en cargas de trabajo de inferencia. Piensa en agentes de codificación, razonamiento en tiempo real y la creciente ola de agentes de IA que deben responder en segundos, no en minutos. Un sistema completo Groq3 LPX agrupa 256 chips LPU en un solo armario de rack. Nvidia afirma que las tareas basadas en agentes que anteriormente tomaban horas en clusters de GPU estándar ahora pueden completarse en minutos.
El entrenamiento sigue siendo dominio de las GPUs de Nvidia. La inferencia es lo que la compañía quiere que creas que definirá la próxima fase del negocio. Jensen Huang lo expresó con crudeza: la inferencia es el motor de crecimiento de la IA.
La arquitectura técnica detrás del movimiento
Lo que hace este anuncio más trascendente que una historia estándar de diversificación de fabricación es la arquitectura en sí misma. El Groq3 LPX no es una GPU reconvertida para inferencia; es una filosofía de silicio fundamentalmente diferente. Al abandonar la DRAM y depender de la SRAM en el chip, el chip elimina el muro de memoria que ha restringido el rendimiento de la inferencia en GPUs tradicionales. Los datos nunca salen del die. La comunicación entre elementos de procesamiento ocurre a través de una red determinista en el chip, no mediante buses de memoria compartidos, lo que elimina la contención y produce perfiles de latencia predecibles.
Para cargas de trabajo como el razonamiento de vehículos autónomos, agentes de negociación financiera en tiempo real o sistemas multimodales interactivos, esa predecibilidad es el producto. La aleatoriedad en la latencia de inferencia es inaceptable cuando estás construyendo sistemas que se interfazan con el mundo físico o con bucles de decisión de alta frecuencia.
Los equipos de ingeniería de Nvidia han dedicado los últimos dieciocho meses a adaptar la arquitectura Groq para escala —algo para lo que el chip original de Groq no fue diseñado—. El LPX representa un refinamiento de mitad de generación: módulos de procesamiento más amplios, mayor eficiencia de enrutamiento e integración con el entorno de ejecución de inferencia CUDA de Nvidia, de modo que las implementaciones de modelos existentes puedan migrar con reescrituras mínimas.
Quiénes ganan y quiénes pierden ahora mismo
El competidor inmediato de Nvidia es AMD. La compañía ha respondido lanzando el sistema de rack Helios, dirigido directamente a la plataforma Vera Rubin de Nvidia y en alianza con el fabricante de chips de baja latencia Ceribius. Ambos movimientos buscan reclamar la cuota de inferencia que Nvidia intenta asegurar. Helios es la respuesta de AMD. Aún no es una respuesta decisiva.
Samsung Foundry gana al asegurar un cliente de alto perfil que anteriormente era casi el socio exclusivo de TSMC para el silicio personalizado de Nvidia. El movimiento le da a Samsung influencia en negociaciones con otros diseñadores de chips de IA fabless. También señala que la tecnología de proceso de Samsung ahora se considera viable para silicio de inferencia de última generación, no solo para lógica de commodities.
TSMC no pierde hoy. Nvidia no la ha abandonado. Pero la asimetría desapareció. La suposición de que cada acelerador avanzado de Nvidia fluiría por los nodos más capaces de TSMC ahora está rota. Eso cambia cómo TSMC fija sus precios y cuánto poder de negociación tienen sus clientes de aquí en adelante.
Navius, el operador de nube de IA designado como primer cliente del Groq3 LPX, obtiene acceso anticipado a un chip diseñado a medida para inferencia de baja latencia. El compromiso de SpaceXAI con la CPU Vera —el nuevo procesador controlador de agentes de Nvidia— es una señal mucho más ruidosa. Se dice que la CPU Vera maneja la orquestación de agentes 1,8 veces más rápido que diseños equivalentes de x86 de Intel y AMD, liberando las GPUs para enfocarse en el cómputo del modelo. SpaceXAI planea extender esa arquitectura a la órbita, a bordo de un satélite Starmind equipado con un sistema Vera Rubin optimizado para el entorno espacial. Ese no es lenguaje especulativo. Es un plan de despliegue.
Efectos de segundo orden que se expanden por la industria
Las implicaciones van mucho más allá del piso de fabricación. Cada startup de IA que evalúa su estrategia de hardware ahora enfrenta una recalibración. La suposición de que TSMC era la única ruta confiable hacia silicio de inferencia de vanguardia ha sido socavada. Samsung Foundry ha sido efectivamente certificada para este trabajo, lo que significa que la próxima ola de diseños de chips personalizados —de startups respaldadas por capital de riesgo, de proveedores de nube, de contratistas de defensa— tendrá una alternativa creíble lista para usar.
Esto desplaza las dinámicas de precios en todos lados. TSMC ya no puede depender de prima de escasez para cargas de trabajo de clase inferencia. Los clientes que aceptaban tiempos de entrega más largos y mayores costos por oblea para asegurar capacidad de TSMC ahora tienen una opción de salida. Incluso la amenaza de esa opción es suficiente para suavizar la posición negociadora de TSMC.
En el plano geopolítico, el movimiento añade una capa de aislamiento. Cualquier disrupción en Taiwán —ya sea por desastre natural, fricción en la cadena de suministro o escalada— ya no garantiza un único punto de falla para el plan de inferencia de Nvidia. Las fabs de Samsung en Austin y Pyeongtaek proporcionan diversidad geográfica que los inversionistas y compradores empresariales encontrarán cada vez más valiosa a medida que la infraestructura de IA escala hacia el rango de cientos de miles de millones de dólares.
También hay una dimensión de talento. Samsung Foundry ha estado contrayendo agresivamente ingenieros de procesos de TSMC e Intel durante los dos últimos años. Atraer al Groq3 LPX de Nvidia valida esa estrategia de reclutamiento y hará más fácil atraer a la próxima cohorte de ingenieros que quieren trabajar en silicio de IA de vanguardia en lugar de lógica de consumo.
Lo que esto significa para la cadena de suministro
La decisión de Nvidia de dividir la fabricación entre Samsung y TSMC es una respuesta a una restricción que ha estado acumulándose durante años: la capacidad de TSMC no es infinita, y la demanda de Nvidia, Apple y, cada vez más, de clientes de chips personalizados en toda la industria de IA está comprimiendo los plazos de entrega. Al incorporar a Samsung para silicio específico de inferencia, Nvidia crea un segundo hilo de suministro para al menos parte de su hoja de ruta. También se aísla de cualquier disrupción en una sola fab —geopolítica, natural u operativa—.
El mercado de chips de inferencia es donde se librará la batalla de crecimiento desde 2025 en adelante. Las cargas de trabajo de entrenamiento se estabilizan. Las cargas de trabajo de inferencia se expanden con cada agente desplegado, cada integración empresarial, cada sistema autónomo. Las compañías que controlen el silicio de inferencia de baja latencia controlarán la capa que determina si un sistema de IA es útil en producción o simplemente impresionante en una demostración.
Samsung Foundry ahora tiene un diseño de referencia que puede mostrar a otras compañías de IA fabless. Si entrega a los niveles de rendimiento y rendimiento que Nvidia afirma, Samsung se convierte en la alternativa por defecto a TSMC para cualquier compañía que necesite silicio de inferencia sin la lista de espera.
La jugada a largo plazo
Nvidia ya no vende solo GPUs. Vende una pila completa: GPUs para entrenamiento, CPUs Vera para orquestación de agentes, Groq3 LPX para inferencia y el software para unirlas. La compañía está construyendo un ciclo cerrado que es más difícil de replicar para los competidores porque cada capa está diseñada para hablar con las otras. El Helios de AMD es una respuesta a nivel de rack. Las Maia de Intel y Microsoft, los TPUs de Google y los Trainium de Amazon son chips personalizados orientados a verticales específicas. Ninguno de ellos iguala aún la amplitud de la pila integrada de Nvidia.
La alianza con Samsung es un movimiento táctico con implicaciones estratégicas. Le da a Nvidia flexibilidad de manufactura mientras fortalece una relación con Samsung que podría volverse crítica si las tensiones geopolíticas alrededor de Taiwán se intensifican. También envía un mensaje a cada otra compañía de IA que evalúa sus opciones de fabricación: la segunda fuente ahora está abierta.
Lo que sucede a continuación depende de si Nvidia puede sostener el volumen en Samsung. La compañía se negó a revelar montos del acuerdo o plazos de entrega. Si la primera tanda de envíos de Groq3 LPX cumple sus objetivos, el negocio de foundry de Samsung recibe un impulso significativo de credibilidad. Si los rendimientos rezagan o la demanda supera la capacidad de Samsung, el acuerdo revelará sus límites rápidamente.
Las líneas de batalla están trazadas
La guerra de inferencia ha comenzado. Nvidia ya no solo defiende la fortaleza del entrenamiento. Avanza en dos frentes —y acaba de abrir una segunda puerta de fábrica. AMD responderá. Intel responderá. Los vendedores de chips personalizados que operaban en relativa oscuridad ahora se enfrentarán a un competidor que ha casado exitosamente un nuevo enfoque arquitectónico con diversificación de manufactura.
Las compañías que construyeron sus estrategias de IA sobre la suposición de que una sola fab dominaba el futuro del silicio de inferencia deben esperar que sus modelos requieran revisión. La puerta está abierta. La pregunta es quién la cruzará primero.