El vertido de 722 artículos de OpenAI y la crisis de revisión por
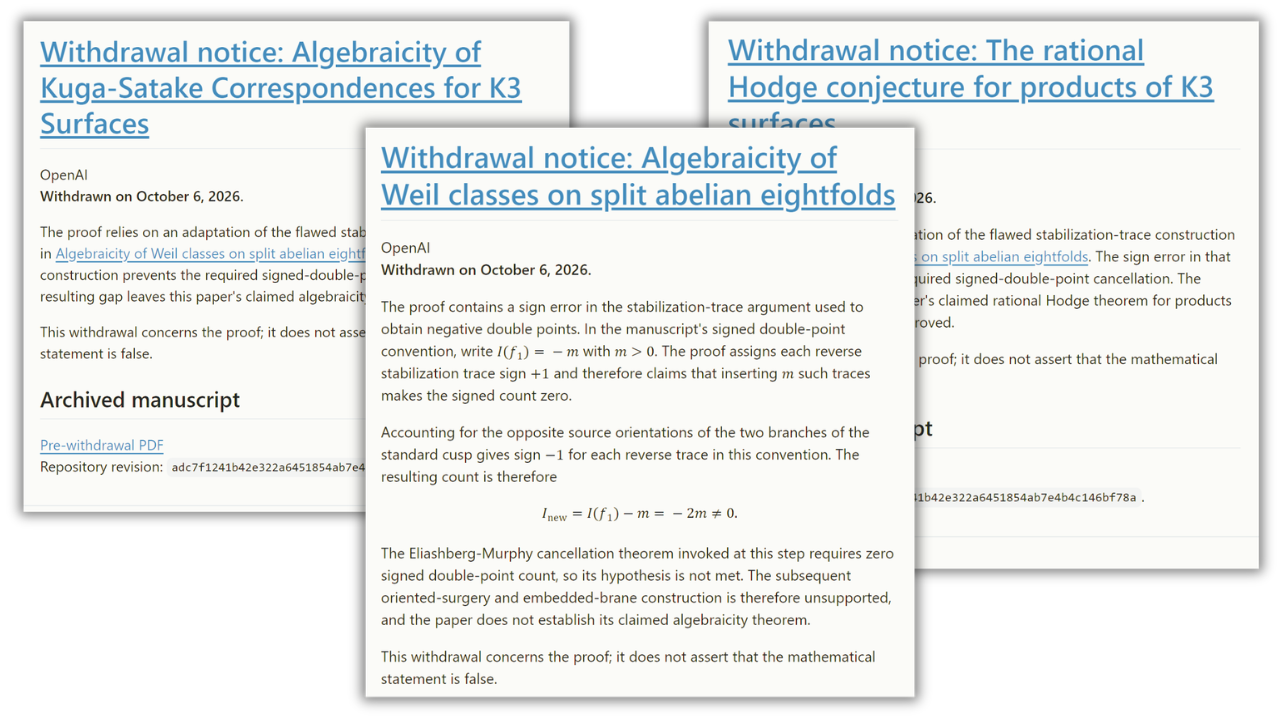
OpenAI retiró tres de los 722 preprints matemáticos pocas horas después de publicarlos, reavivando el temor a que la scholarship generada por IA eluda la revisión por pares. Este incidente pone al descubierto un modelo de validación defectuoso que podría transformar la forma en que las matemáticas —y la ciencia en general— absorben los resultados de la IA.
Los números tras el ruido
OpenAI publicó 722 preprints que cubren avances en 372 problemas matemáticos sin resolver, abarcando geometría, ciencias de la computación, álgebra y otros campos. Tres de ellos se retiraron menos de un día después por un error de signo que derrumbó un artículo y dos construcciones dependientes de él. Catorce más recibieron versiones revisadas con demostraciones corregidas y enunciados modificados. La propia empresa estimó que aproximadamente la mitad de todos los resultados presentados seguían sin confirmación.
Eso no es un escándalo. Es una anticipación.
Cómo llegó la comunidad matemática a este punto
El mundo de las matemáticas ya tenía problemas de confianza con OpenAI. En septiembre, la compañía anunció que su sistema de inteligencia artificial había resuelto el problema de Navier-Stokes, una pregunta del Premio Millennium sobre si las ecuaciones que gobiernan el movimiento de los fluidos permanecen confiables o colapsan en algún momento. Una coalición de más de 8.000 investigadores respondió con alarma, argumentando que el anuncio se lanzó apresuradamente sin un documento formal adecuado, que aislaba los métodos en lugar de situarlos en contexto y que omitía citas a trabajos previos relevantes.
El deslave de 722 artículos solo profundizó esa fractura.
Alex Townsend, profesor asociado de matemáticas en Cornell, planteó el problema con crudeza: si OpenAI tenía algo tan grande que compartir, el movimiento obvio habría sido verificar con Lean las afirmaciones más sólidas primero y publicarlas, y luego liberar el resto para el escrutinio de la comunidad. Lean es un asistente de demostración de código abierto que revisa los argumentos matemáticos línea por línea. Es exactamente el tipo de herramienta que hace plausible la matemática generada por IA en primer lugar. Usarlo de forma selectiva habría permitido que la comunidad validara lo esencial antes de adentrarse en un bosque de resultados dudosos.
En cambio, OpenAI liberó todo de golpe y le pidió al mundo que lo ordenara.
¿Quién recomendó ese cronograma?
Un portavoz de OpenAI dijo que el Grupo Asesor sobre Matemáticas e Inteligencia Artificial (AGMAI) de la compañía aconsejó lanzar los resultados sin esperar a la formalización completa. La recomendación del grupo es ahora la frase más incómoda de toda la trama: desplaza parte de la culpa hacia un órgano que, se presume, existe para orientar un despliegue responsable, mientras plantea la pregunta más amplia de si algún grupo asesor debería tener ese tipo de influencia sobre qué tan crudo aparece un programa de investigación de IA en el mundo real.
No está claro si AGMAI quiso recomendar un deslave masivo de preprints o algo más cercano a un lanzamiento escalonado, con verificación primero. Sea cual sea el caso, el resultado fue el mismo: una montaña de afirmaciones no verificadas llegando a GitHub un jueves, y tres retiradas para el viernes.
El problema estructural, no el error de signo
Un error de signo en tres artículos es parte normal de la investigación. En matemáticas, los errores se propagan. Un solo lema falso puede hundir múltiples resultados construidos sobre él. Así es como funciona el campo: los argumentos defectuosos salen a la superficie, se detectan, y la comunidad avanza con correcciones. El problema aquí no es el error. Es la tubería que produjo 722 manuscritos sin ningún filtro.
La revisión por pares tradicional avanza despacio porque está diseñada precisamente para capturar este tipo de cosas antes de que lleguen a la literatura. Un solo artículo puede tomar meses. Un lote de 722 tomaría años. La estrategia de lanzamiento de OpenAI aceptó implícitamente que el sistema viejo no podía seguir el ritmo de la producción a escala de IA, y luego actuó como si eso significara que el sistema viejo podía saltarse por completo.
Esa lógica es peligrosamente incompleta.
Saltarse la revisión por pares no hace que los resultados sean inválidos. Los hace prematuros. Y los resultados prematuros tienen una influencia desproporcionada. Cuando una empresa tan poderosa como OpenAI etiqueta un artículo como “preprint” y lo publica en GitHub junto con afirmaciones que parecen emblemáticas, la distinción entre provisional y consolidado se desvanece en la práctica, aunque permanezca nítida en teoría.
Quién gana, quién pierde, qué cambia
OpenAI no gana nada con la forma en que esto ocurrió, y pierde más de lo que admite. El portavoz de la compañía calificó las correcciones como iterativas: cierto, pero también como una restatización. La investigación iterativa suena a cuaderno de laboratorio. Un deslave de 722 artículos suena a lanzamiento de producto.
Andrew Sutherland del MIT calificó las retiradas como “lo responsable que debían hacer”, lo cual es una forma generosa de describir un estándar mínimo. Más importante aún, Sutherland señaló una verdad más difícil: a la comunidad matemática aún no le satisface, y la confianza no se reconstruye admitiendo errores después del hecho. La confianza se reconstruye cambiando el proceso que causó los errores en primer lugar.
La Asociación para las Humanidades Matemáticas fue más lejos, declarando que “los matemáticos no pidieron que se hiciera este trabajo” y exhortando a los investigadores a dejar de colaborar con OpenAI. Si esa apelación logra penetrar es una pregunta abierta. El impulso detrás de ella —una defensa de la erudición centrada en los seres humanos— refleja una ansiedad real sobre los laboratorios de IA que tratan toda la disciplina como una métrica que hay que superar en lugar de una comunidad con la que interactuar.
¿Quién se beneficia de este desastre? Nadie a largo plazo. Pero los competidores de OpenAI están atentos. Cada afirmación no verificada que se derrumba erosiona la credibilidad de las matemáticas asistidas por IA en su conjunto, no solo la cuota de OpenAI. Otros laboratorios que trabajan en verificación formal —Microsoft Research, Google DeepMind, comunidades independientes de Lean— heredan el escepticismo que la prisa de OpenAI invitó.
Qué sigue
Esperen más retiradas. Townsend las sospecha. Esperenlas tanto de OpenAI como de otros laboratorios que producen grandes volúmenes de matemáticas generadas por IA. La pregunta es si la comunidad construye infraestructura lo suficientemente rápido para absorber el ciclo de correcciones sin colapsar en cinismo.
Varios desarrollos concretos son probables en los próximos meses:
Primero, un impulso hacia estrategias de lanzamiento con prioridad a Lean. Si algún programa de matemáticas con IA quiere credibilidad, comenzará con verificación formal y publicará solo lo que pase, y luego liberará el resto por separado, claramente etiquetado, con una invitación explícita al escrutinio comunitario. Los propios preprints de OpenAI sugieren que podría estar ya avanzando en esta dirección, actualizando su repositorio con nuevas formalizaciones y erratas.
Segundo, un forcejeo con AGMAI y cuerpos asesores similares. Si estos grupos van a aconsejar sobre el cronograma de lanzamiento, sus recomendaciones estarán bajo escrutinio público. La comunidad matemática exigirá ver cómo se ve un “lanzamiento responsable” en la práctica, no solo en principio.
Tercero, una posible fractura en cómo se trata las matemáticas generadas por IA. Los artículos procedentes de laboratorios de IA podrían enfrentar un sistema de dos vías: los resultados que pasan la verificación formal ganan aceptación por mérito propio, mientras que las afirmaciones no verificadas se tratan como notas internas en lugar de contribuciones a la literatura. Esa es una distinción más nítida de la que existe actualmente, y obligará a cada laboratorio que produce matemáticas asistidas por IA a decidir dónde pertenece su producción.
El error de signo en tres artículos es pequeño. La señal institucional que envía no lo es. Un campo que no puede absorber sus propias correcciones a velocidad es un campo que o bien frenará o bien se romperá. Los 722 preprints de OpenAI intentaron no hacer ninguna de las dos cosas, y por eso la retirada de tres importa más de lo que el titular sugiere.