OpenAI千份论文撤回背后的学术信任危机
OpenAI发布722篇数学预印本后24小时内撤回三篇,引发学界对AI生成论文绕过同行评审的担忧。这一事件暴露了验证体系的缺陷,或将重塑数学乃至整个科学界接受AI成果的方式。
数字背后的喧嚣
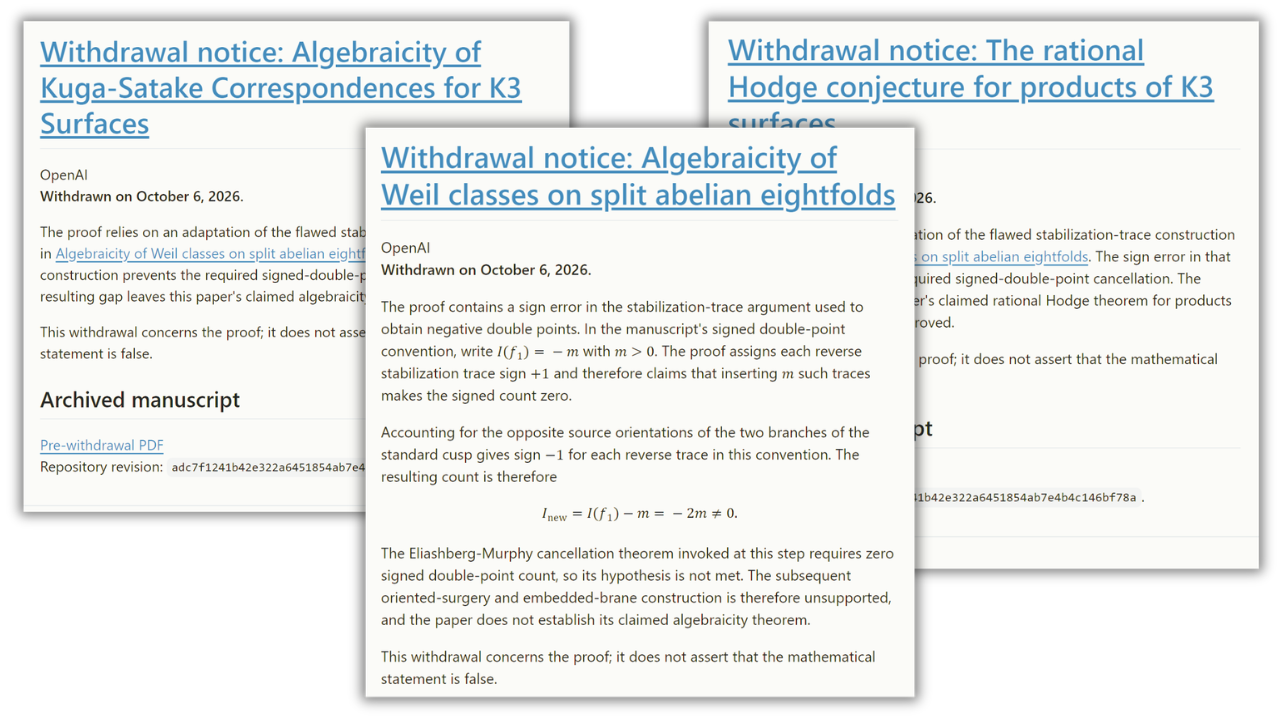
OpenAI发布了722篇预印本,涵盖了372个未解决的数学问题的进展,涉及几何、计算机科学、代数等领域。三天不到就有三篇撤下,原因是一个符号错误推倒了一篇论文以及两篇依赖它的推导。又有14篇收到了修正后的证明和更正的陈述。该公司自身估计,这次 dumped 的大概有一半的结果仍未得到确认。
这不是丑闻。这是一个预览。
数学界为何走到这一步
数学界本身就对OpenAI存有信任问题。今年九月,该公司宣布其AI系统解决了纳维-斯托克斯问题——这是一个关于流体力学方程在某个时刻是否会保持可靠还是崩溃的千禧年大奖问题。超过8000名研究者联盟以警示回应,认为该公告仓促发布,没有完整的论述,方法孤立而非置于语境之中,且未能引用相关的既有工作。
这篇722篇论文的"倾倒"只会加深裂痕。
康奈尔大学数学系副教授亚历克斯·汤森德(Alex Townsend)直言不讳:如果OpenAI真有如此庞大的成果要分享,最明智的做法是先以Lean验证最核心的论断并发表,然后将剩余部分交由社区审视。Lean是一个开源的定理证明辅助工具,逐行检验数学论证。它正是让AI生成的数学内容显得可信的那类工具。选择性使用它本可以让社区先验证真正重要的部分,再涉足一片充满不确定性的结果丛林。
但OpenAI选择一次性发布所有内容,然后让全世界自行整理。
谁建议了这个时间表?
OpenAI一名发言人表示,公司的人工智能与数学顾问委员会(AGMAI)建议在不等待完整形式化的情况下发布成果。这个小组的建议如今成了整个事件中最为尴尬的一句话:它将部分责任转嫁给了一个理应引导负责任部署的机构,同时引发了更广泛的问题——任何顾问委员会是否应该对AI研究项目在公众面前的"粗糙程度"拥有这样的影响力。
无论AGMAI的本意是建议大规模预印本倾倒,还是更接近分阶段、优先验证的发布方式,目前尚不清楚。但无论如何,结果是一样的——一大堆未经审查的论断在周四涌入GitHub,到周五便有三篇撤稿。
结构性的问题,而非符号错误
三篇论文中的符号错误是研究中正常的一部分。在数学领域,错误会传播。一个错误的引理可以毁掉在其之上构建的多个结果。这就是该领域本应运作的方式——有缺陷的论证浮现、被发现、然后社区带着修正继续前行。这里的问题不在于错误本身,而在于那条没有任何关卡就产出722篇手稿的生产管线。
传统的同行评审进展缓慢,因为它正是为了在结果进入文献之前捕捉这类问题而设计的。一篇论文可能需要数月。722篇的话需要数年。OpenAI的发布策略隐含地接受了旧体系无法跟上AI规模产出的现实——然后表现得仿佛这意味著可以完全跳过旧体系。
这种逻辑危险地不完整。
跳过同行评审并不会让结果无效。它让结果过于超前。而超前的结果却拥有不成比例的影响力。当一家像OpenAI这样强大的公司将论文标为"预印本"并发布在GitHub上,与里程碑式的论断并列时,在实践中学者之间暂定性结论与既定结论之间的界限消失了,即便理论上这条界限仍然清晰。
谁受益,谁受损,什么改变了
OpenAI在这场风波中一无所获,失去的远多于其承认的。公司发言人将修正称为"迭代的"——的确如此,但这也是一种轻描淡写。迭代式研究听起来像实验室笔记。722篇论文的一次性倾倒听起来像产品发布会。
麻省理工学院的安德鲁·萨瑟兰(Andrew Sutherland)称这些撤稿是"负责任的做法",这已是相当宽容的表述,因为这本就是最低标准。更重要的是,萨瑟兰点出了一个更难听的真相:数学界仍然不满,信任不是通过事后认错就能重建的。信任是通过改变最初导致错误发生的流程来重建的。
人类数学协会(Association for Human Mathematics)走得更远,宣布"数学家并未要求开展这项工作",并呼吁研究者停止与OpenAI合作。这一呼吁能否获得共鸣仍是未知数。其背后的冲动——对人类中心化学术的捍卫——反映出一种真实的焦虑:AI实验室将整个学科视为一个需要突破的基准而非一个需要互动的共同体。
谁从这场混乱中获益?长远来看没有人。但OpenAI的竞争对手注意到了。每一个崩塌的未验证论断都在侵蚀AI辅助数学的整体公信力,而不仅仅是OpenAI的份额。其他从事形式化验证的实验室——微软研究院、Google DeepMind、独立的Lean社区——继承了OpenAI的仓促所招致的怀疑。
接下来会发生什么
预计会有更多撤稿。汤森德怀疑如此。不仅来自OpenAI,也来自其他批量生产AI生成数学成果的实验室。问题是,社区能否快速建立足够的架构来吸收这一修正周期,而不至于陷入愤世嫉俗的泥沼。
未来几个月可能出现若干具体动向:
其一,转向"Lean优先"的发布策略。任何希望获得可信度的AI数学项目都将先从形式化验证起步,只发表通过审查的内容——然后另行发布其余部分,明确标注,并公开邀请社区审视。OpenAI自身的预印本提及表明它可能已经在朝这个方向移动,正在其仓库中更新新的形式化内容和勘误表。
其二,对AGMAI及类似顾问机构的清算。如果这些机构将继续就发布时间提供建议,它们的建议将面临公众审视。数学社区将要求在现实中看到"负责任的发布"是什么样子,而不只是原则上如何。
其三,AI生成数学的处理方式可能出现分裂。来自AI实验室的论文可能面临双轨制:通过形式化验证的结果按其本身的价值获得认可,而未验证的论断则被视为内部笔记而非对文献的贡献。这比现有的区分更为尖锐,将迫使每一个生产AI辅助数学成果的实验室决定自己的产出究竟归属何处。
三篇论文中的符号错误很小。它传递的制度信号却不小。一个无法以速度消化自身纠正的领域,要么减速,要么崩溃。OpenAI的722篇预印本试图既不减速也不崩溃,而这正是三篇撤稿之所以比标题所暗示的更重要。