El GPT-6 Astra de OpenAI acaba de romper la economía del hardware de IA
Jensen Huang reveló que el GPT-6 Astra se entrenó con 100.000 GPUs a nivel de cómputo ZFLOPS. Esto significa para quiénes pueden alcanzar la AGI y quiénes se quedarán atrás.
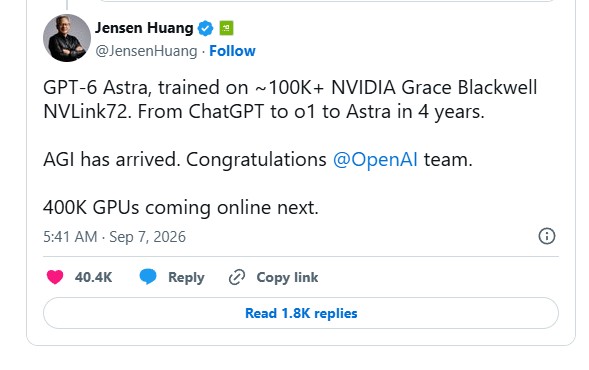
El número que lo cambia todo
Jensen Huang no solo felicitó a OpenAI en X. Soltó un número que debería hacer que todo investigador, inversor y formulador de políticas sobre inteligencia artificial se detenga en seco: 100.000 GPUs.
No 10.000. Ni siquiera 50.000. Cien mil chips NVIDIA Grace Blackwell, conectados entre sí en configuraciones NVLink72, entrenando el modelo que OpenAI denomina GPT-6 Astra. Y Huang dice que el siguiente salto es de 400.000.
Esto no es un escalado incremental. Es una ruptura cualitativa en la economía de la inteligencia artificial. La barrera para construir modelos de vanguardia acaba de pasar de “startup bien financiada” a “requiere inversión de capital a nivel de Estado-nación”.
Qué hizo realmente GPT-6 Astra
Empecemos por lo que este modelo logró, porque los números de los benchmarks son sobrecogedores incluso para quienes siguen este sector.
GPT-6 Astra obtuvo un 99,9 % en ARC-AGI-3, el benchmark del Corpus de Abstracción y Razonamiento diseñado específicamente para medir qué tan cerca está la IA de una inteligencia general similar a la humana. Esa prueba premia a los sistemas que pueden resolver problemas nuevos mediante razonamiento abstracto, no mediante coincidencia de patrones o memorización. Un 99,9 % en ese benchmark no es un error de redondeo. Es una señal de que el modelo ha cruzado algo fundamental.
Por separado, videos que circulan en X muestran a GPT-6 Astra operando autónomamente software profesional de pintura, navegando por interfaces complejas de modelado 3D y diseñando entornos completos de videojuegos en 3D sin intervención humana. Se trata de tareas que requieren no solo comprensión del lenguaje, sino también uso de herramientas, razonamiento espacial y comportamiento sostenido orientado a metas en múltiples contextos de software.
Huang lo llamó el logro del AGI. También señaló que tomó solo cuatro años desde el lanzamiento de ChatGPT para llegar a este punto. Esa línea de tiempo es en sí misma un dato digno de examinar.
Las matemáticas del hardware detrás de la afirmación
Aquí es donde la economía se vuelve concreta y los números se vuelven casi difíciles de descifrar.
Cada Superchip NVIDIA GB200 Grace Blackwell contiene una CPU y dos GPUs, ofreciendo 80 teraflops de rendimiento FP64. Multipliquemos eso por 100.000 GPUs —lo que significa aproximadamente 50.000 de estas unidades de superchip— y estaríamos hablando de unos 4 exaflops de rendimiento pico teórico para todo el clúster de entrenamiento.
Para ponerlo en contexto, el ranking TOP500 actual de supercomputadoras ubica a la máquina más poderosa del mundo, un sistema chino, en 2,19 exaflops. El clúster de entrenamiento de GPT-6 Astra, por sus especificaciones raw FP64, ya lo supera. En la práctica, el entrenamiento moderno de LLM aprovecha formatos de precisión mixta como FP4 y FP8, los cuales exprimen mucha más velocidad de procesamiento del mismo silicio. Eso empuja la escala computacional efectiva al rango de los zettaflops: mil exaflops, o un billón de operaciones en punto flotante por segundo.
Solo los requerimientos energéticos merecen consideración. Un clúster de este tamaño consumiendo energía a escala de centro de datos durante semanas o meses de entrenamiento es una partida presupuestaria que supercon a casi toda otra inversión tecnológica en la historia.
Quién puede permitirse esto
Sé directo sobre lo que esto significa para la competencia.
Hace cuatro años, OpenAI lanzó con lo que se consideraba un clúster de GPUs muy grande según los estándares de la industria. Hoy, la frontera se ha desplazado a una escala aproximadamente diez veces mayor en hardware físico, y órdenes de magnitud mayor en computación efectiva cuando se consideran las optimizaciones de precisión y las mejoras en eficiencia de entrenamiento. La trayectoria sugiere que para cuando llegue GPT-7, el requerimiento de hardware podría acercarse a un millón de GPUs.
Esto crea un embudo. Por un lado, tienes un puñado de organizaciones —OpenAI, Anthropic, Google DeepMind, posiblemente Microsoft y laboratorios chinos bien financiados— que pueden absorber los costos de capital. Por el otro, todos los demás: startups, universidades, comunidades de código abierto y empresas en países sin acceso a cadenas de suministro de semiconductores de última generación.
El comentario de Huang sobre 400.000 GPUs desplegando la próxima vez no es especulación. Es una divulgación de hoja de ruta. NVIDIA está construyendo la cadena de suministro, la red, la distribución de energía y el stack de software para soportar esta escala. OpenAI y sus pares son los clientes. El cuello de botella se está desplazando de los avances algorítmicos a la adquisición de hardware y la infraestructura energética.
El contexto de los supercomputadores chinos
Vale la pena señalar que los supercomputadores más rápidos del mundo son chinos. El líder del TOP500 mencionado anteriormente es un sistema construido en China. Esto crea una dimensión geopolítica que va más allá del desarrollo de modelos de IA. Las naciones están invirtiendo billones en infraestructura de computación exascale, y ahora las compañías privadas de IA compiten contra esas mismas capacidades nacionales.
China ha sido explícita al tratar a la IA como una prioridad estratégica. La convergencia de la computación super avanzada respaldada por el gobierno con el desarrollo de IA del sector privado crea un dinamismo donde la frontera entre la capacidad estatal y la corporativa se está difuminando. El clúster de entrenamiento de 100.000 GPUs no es solo un activo de OpenAI. Es un fragmento de infraestructura que se sitúa en la intersección de la ambición comercial y la competencia tecnológica nacional.
Qué señalan 400.000 GPUs
Huang no se detuvo en describir lo que existe. Divulgó lo que está por venir. Cuatrocientas mil GPUs. Eso es un cuadruplicado respecto al clúster de GPT-6 Astra. Si la relación de escalado se mantiene —y hay todas las razones para creer que lo hará, dado el historial empírico—, el próximo modelo de frontera requerirá recursos computacionales difíciles de modelar en términos financieros convencionales.
La pregunta ya no es si el AGI es posible. La pregunta, tal como Huang la enmarcó, es cuántos recursos computacionales demanda el camino hacia el AGI, y qué tan inteligentes se volverán los sistemas resultantes. Esas son preguntas que exceden el encuadre de la mayoría de los análisis tecnológicos. Requieren pensar en términos que parecen casi abstractos: economías de escala de billones de dólares, redes energéticas rediseñadas para cargas de centros de datos, realineamientos geopolíticos en torno al acceso a semiconductores.
El verdadero costo no es solo dinero
El número titular es el costo del hardware. Pero el costo más profundo es la concentración organizacional y temporal de la capacidad. Cuatro años desde ChatGPT hasta un modelo que obtiene un 99,9 % en un benchmark de AGI. Ese ritmo de desarrollo significa que la ventana para que cualquier organización ingrese a la frontera se cierra más rápido de lo que la mayoría de la gente se da cuenta.
El código abierto no puede simplemente replicar esto. Los tamaños de los conjuntos de datos, los clústeres de computación, los pipelines de entrenamiento refinados —todo esto está custodiado por requerimientos de capital y conocimiento institucional que no se transfieren fácilmente. Las compañías que construyeron esta trayectoria han pasado cuatro años acumulando ambas cosas. Los nuevos participantes enfrentan una desventaja compuesta que no es meramente financiera, sino estructural.
Hacia dónde va esto
El arco es lo suficientemente claro para trazarse, incluso si el destino no lo es. Más GPUs. Más computación. Más capacidad. La pregunta que debería ocupar a formuladores de políticas, inversores y a cualquiera que rastree la tecnología es qué sucede cuando la brecha entre la vanguardia y lo que no lo es se vuelve infranqueable para todos menos un puñado de actores.
El mensaje congratulatorio de Huang fue breve. Los números incrustados en él no lo son. Cien mil GPUs. Entrenamiento a escala ZFLOPS. Cuatrocientas mil próximamente. La economía de la inteligencia artificial acaba de entrar en una nueva fase, y quienes puedan costear el hardware son los que definirán qué viene después.