OpenAI 的 GPT-6 Astra 刚刚颠覆了 AI 硬件经济
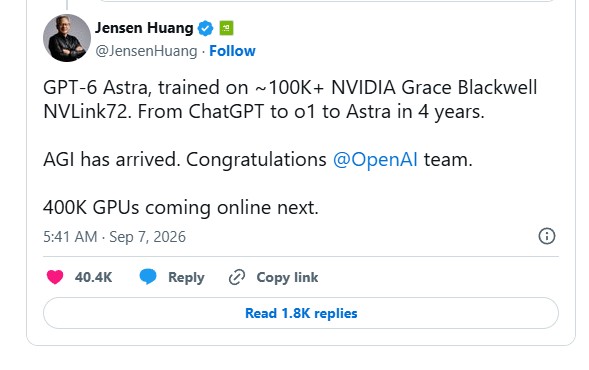
黄仁勋透露,GPT-6 Astra 在 ZFLOPS 级算力上使用了 10 万块 GPU 进行训练。这意味什么?谁能构建 AGI,谁又将被抛在后面。
改变一切的数字
黄仁勋不仅在 X 平台向 OpenAI 道了贺。他抛出了一个让所有 AI 研究者、投资者和政策制定者必须驻足深思的数字:十万颗 GPU。
不是一万。更不是五万。是十万颗 NVIDIA Grace Blackwell 芯片,以 NVLink72 互联配置紧密串联,用于训练 OpenAI 所称的 GPT-6 Astra 模型。而黄仁勋表示,下一次跃升将是四十万颗。
这不是渐进式的规模扩张。这是人工智能经济学的一次质变。构建前沿模型的门槛,已从“资金充裕的初创公司”一步跨入了“需要国家级资本支出”的范畴。
GPT-6 Astra 究竟做到了什么
我们先从这款模型的实际成果说起,因为即便对持续关注该领域的观察者而言,其基准测试数据也令人咋舌。
GPT-6 Astra 在 ARC-AGI-3 基准测试中取得了 99.9% 的成绩。该基准由抽象与推理语料库(Abstraction and Reasoning Corpus)设计,专门用于衡量 AI 逼近类人通用智能的程度。这项测试奖励的是能够通过抽象推理解决全新问题的系统,而非依赖模式匹配或死记硬背。在该基准上拿下 99.9% 的分数绝非四舍五入的误差,它是一个明确的信号:该模型已经跨过了某个根本性的门槛。
与此同时,X 平台上流传的视频显示,GPT-6 Astra 能够在无人干预的情况下自主操作专业绘画软件、驾驭复杂的 3D 建模界面,并设计完整的 3D 游戏场景。这些任务不仅需要语言理解能力,更要求工具使用、空间推理,以及在多软件环境中持续保持目标导向的行为。
黄仁勋将其称为 AGI 的实现。他还指出,从 ChatGPT 发布到达成这一里程碑仅耗时四年。这段发展时间线本身就是一个值得深入审视的数据点。
主张背后的硬件账算
到了这里,经济学开始变得具体,而这些数字也变得几乎难以厘清。
每一颗 NVIDIA GB200 Grace Blackwell 超级芯片包含一颗 CPU 和两颗 GPU,可提供 80 万亿次浮点运算每秒(teraflops)的 FP64 性能。将其乘以十万颗 GPU——相当于约五万个此类超级芯片单元——整个训练集群的理论峰值性能便达到大约 4 exaflops。
作为参照,当前 TOP500 超级计算机排行榜将全球最强机器列为一款中国系统,峰值为 2.19 exaflops。仅凭原始 FP64 指标,GPT-6 Astra 的训练集群就已经超越了这一数字。实际上,现代大语言模型训练采用 FP4 和 FP8 等混合精度格式,能从同一片硅片上压榨出远超以往的吞吐量。这将有效计算规模推入了 zettaflops(泽塔弗洛普斯)区间——即一千 exaflops,或每秒一万亿次浮点运算。
仅能源消耗一项就值得深思。一个如此规模的集群以数据中心级功耗运行数周乃至数月,这笔开销足以让历史上几乎所有其他技术投资相形见绌。
谁能负担得起?
让我直接说明这对竞争格局意味着什么。
四年前,OpenAI 发布时配备的 GPU 集群在业界看来已属庞大。而如今,前沿已经跨入了一个在物理硬件规模上约为当初十倍、在考虑精度优化与训练效率提升后、有效算力高出数个数量级的阶段。按照这条轨迹推演,等到 GPT-7 问世时,硬件需求可能逼近一百万颗 GPU。
这形成了一道漏斗。一侧是少数几家能够消化这笔资本支出的机构——OpenAI、Anthropic、Google DeepMind、可能还有微软,以及资金充足的国内实验室;另一侧则是其余所有参与者:初创企业、高校、开源社区,以及无法触及尖端半导体供应链的国家的企业。
黄仁勋关于下一步将上线四十万颗 GPU 的表态并非猜测,而是路线图披露。英伟达正在为此规模搭建供应链、网络架构、电力供应与软件栈。OpenAI 及其同行则是客户。瓶颈正从算法突破转向硬件采购与能源基础设施。
中国超算的背景
值得注意的是,全球最快的超算均来自中国。上文提及的 TOP500 榜首就是一台国产系统。这带来了一层超越 AI 模型开发本身的地缘政治维度。
各国正斥资数十亿美元建设艾克萨级(exascale)计算基础设施,而私营 AI 公司如今正与这些国家级能力展开角逐。
中国早已明确将 AI 视为战略重点。政府支持的超算与私营部门的 AI 研发在此交汇,塑造出一种国家能力与企业能力边界日益模糊的新动态。十万颗 GPU 的训练集群不仅是 OpenAI 的资产,更是坐落在商业野心与国家科技竞争交汇点上的一座基础设施。
四十万颗 GPU 释放的信号
黄仁勋并未止步于描述现状,他披露了即将到来的蓝图:四十万颗 GPU。较 GPT-6 Astra 集群规模翻了四倍。如果这种扩展关系持续成立——凭借已有的实证轨迹,我们有充分理由相信它会成立——那么下一代前沿模型所需的算力资源,将难以用传统的财务模型来衡量。
问题早已不再是 AGI 是否可能。正如黄仁勋所表述的,问题变成了通往 AGI 的道路需要多少算力资源,以及最终系统的智能水平将达到何种高度。这些问题已经超出了大多数技术分析所能涵盖的框架。它们要求我们以近乎抽象的尺度去思考:万亿美元级的规模经济、为数据中心负载重新设计的电网、围绕半导体获取权限的地缘政治重构。
真正的成本远不止金钱
引人注目的核心数字是硬件成本。但更深层的成本在于能力的组织与时间高度集中。从 ChatGPT 发布到一款在 AGI 基准上拿下 99.9% 分数的模型问世,仅仅四年。这种发展速度意味着,任何组织进入前沿赛道的窗口期,正在以大多数人难以察觉的速度迅速收窄。
开源无法简单复制这一切。数据集规模、算力集群、打磨成熟的训练流水线——这些都被资本门槛与机构知识牢牢锁住,难以轻易转移。构筑这条轨迹的公司已经投入四年时间积累两者。新入局者面临的是一种复利式的劣势,它不只是财务层面的,更是结构性的。
后续走向何方
这条弧线清晰可辨,即便终点尚未明了。更多的 GPU。更强的算力。更高的能力。真正值得政策制定者、投资者以及所有技术追踪者思索的问题是:当前沿与非前沿之间的鸿沟,除极少数参与者外变得无法跨越时,世界将走向何方。
黄仁勋的祝贺信息言简意赅,但其中嵌入的数字却不容小觑。十万颗 GPU。ZFLOPS 级别的训练。下一步是四十万颗。人工智能的经济学刚刚迈入新阶段,而能负担得起硬件的玩家,将定义此后的格局。