Tu ADN está conteniendo el aliento para ocho letras
La ARN polimerasa de E. coli transcribe un alfabeto genético sintético de ocho letras con fidelidad casi nativa. El avance, publicado en Nature, elimina una de las últimas barreras mecánicas para la tecnología del código genético expandido.
El alfabeto de cuatro letras está a punto de llenarse.
La vida en la Tierra siempre ha funcionado con cuatro letras genéticas: adenina, timina, citosina y guanina. Durante décadas, los biólogos sintéticos se han preguntado si ese número es una ley dura de la naturaleza o simplemente un accidente histórico. Un artículo publicado este año en Nature demuestra que al menos un paso hacia un sistema de ocho letras es completamente viable. La ARN polimerasa de E. coli lee pares de bases sintéticos P:Z durante la transcripción con una eficiencia y fidelidad casi indistinguibles del apareamiento natural.
El hallazgo no es meramente incremental. Cierra una brecha mecanística específica que persistía desde que el programa AEGIS demostró por primera vez un alfabeto genético expandido en tubos de ensayo. Hasta ahora, el par no natural B:S había sido caracterizado en la ARN polimerasa de E. coli, y tanto P:Z como B:S funcionaban con sistemas más simples como la ADN polimerasa Taq y la ARN polimerasa T7. Pero las polimerasas celulares mult subunidad, las que realmente impulsan la transcripción en células vivas, nunca habían demostrado manejar P:Z. Eso importa porque B:S y P:Z juntos constituyen el núcleo del sistema “hachimoji” de ocho letras. Lograr que un par funcione en E. coli fue un avance. Lograr que ambos coexistan sin interferencias fue el verdadero obstáculo.
Cómo funciona el experimento
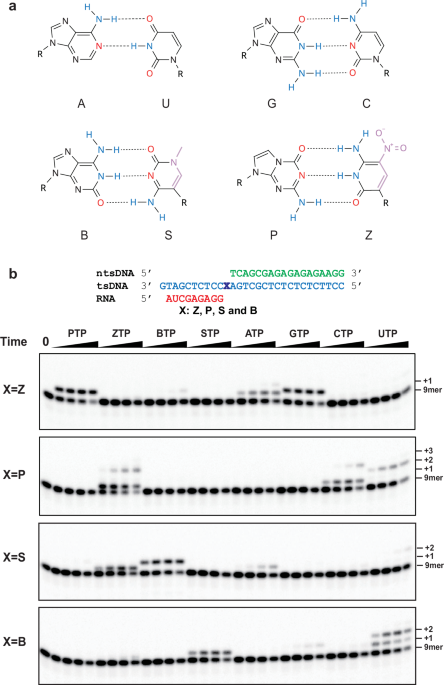
Los investigadores ensamblaron andamios híbridos de ADN/ARN con un solo base no natural ubicada en el sitio de template +1 y probaron los ocho nucleótidos trifosfato, cuatro naturales y cuatro sintéticos, para su incorporación por la ARN polimerasa de E. coli. El resultado fue inequívoco: el apareamiento cognato dominó en cada punto temporal probado. PTP frente a dZ y ZTP frente a dP produjeron bandas de extensión claras dentro de los 15 segundos. La cinética de giros únicos situó las constantes de tasa observadas para dZ:PTP y dP:ZTP en aproximadamente el doble de lentas que el par natural dG:CTP. Eso es lento, pero lejos de ser inviable.
Más importante aún, los dos pares no naturales operan de forma ortogonal. Cuando B:S y P:Z están presentes en la misma reacción de transcripción, cada uno selecciona su propio compañero e ignora en gran medida al otro. Esa ortogonalidad es lo que hace que un sistema de ocho letras sea coherentemente informativo en lugar de meramente diverso químicamente. Sin ella, las letras adicionales se colapsan en ruido.
El problema de los apareamientos erróneos y una solución química
Ningún alfabeto expandido llega sin carga, y el par P:Z tiene uno notable. El nucleótido Z porta un grupo nitro en su surco mayor. Los grupos nitro son electrona atractores. Reducen el pKa del nucleobase a aproximadamente 7,8, lo que significa que una fracción de las moléculas de Z se desprotona bajo condiciones fisiológicas. La forma desprotonada, Z⁻, presenta un patrón de enlaces de hidrógeno que coincide con la guanina. En otras palabras, Z puede aparearse erróneamente con G, y los ensayos de transcripción mostraron exactamente eso. La error de incorporación dZ:GTP fue la mayor violación de fidelidad observada entre todas las 32 combinaciones de plantilla-NTP probadas.
Este no es un capricho de la ARN polimerasa de E. coli. El mismo apareamiento erróneo Z:G se ha documentado en PCR con la polimerasa Taq y en estudios de replicación anteriores. Es una propiedad intrínseca de la química, no un evento de reconocimiento erróneo proteína-ácido nucleico. La consecuencia es práctica, no obstante: cualquier sistema construido sobre P:Z tiene que enfrentar la inserción de G a menos que el pKa se eleve muy por encima de la neutralidad.
Los autores abordaron esto con un nucleótido modificado llamado Z*. Al reemplazar el grupo nitro por un carboxamida y agregar un sustituyente fluoruro en la posición 2′, elevaron el pKa por encima de 10. La desprotonación se vuelve insignificante a pH fisiológico, y la señal de apareamiento erróneo desaparece. Los ensayos de transcripción con plantillas dZ* mostraron una reducción dramática de la incorporación errónea de GTP y una extensión de un solo nucleótido limpia. El propio ZTP también se incorporó erróneamente mucho menos que el ZTP en múltiples contextos de plantilla. El punto de ajuste es que Z es una nueva entidad química que requiere nuevas vías biosintéticas, pero la ganancia en fidelidad es lo suficientemente sustancial como para justificar el esfuerzo.
Lo que muestran las estructuras
Las estructuras de criomicroscopía electrónica a 2,42 angstroms de resolución capturaron el estado pre catalítico de la ARN polimerasa de E. coli con dZ apareada contra el PTP entrante. El buzo activador, un elemento móvil en la subunidad β′ que se pliega en el sitio activo tras la unión del sustrato cognato, está completamente engagé. Los residuos clave M932 y H936 en el buzo activador, junto con T790 en el puente helicoidal, estabilizan el par de bases no natural mediante contactos hidrofóbicos y de enlace de hidrógeno. La geometría del par P:Z dentro del sitio activo es canónica Watson-Crick. El trifosfato adopta la conformación de silla esperada, coordinado por dos iones magnesio catalíticos en el arreglo estándar de dos iones metálicos.
En términos sencillos, la polimerasa no puede distinguir que P y Z son extrañas. Las aloja de la misma manera que aloja A:T y G:C. Ese es el remate estructural. También significa que la enzima no se detiene ni hace pausas después de incorporar un par no natural. Los ensayos de persecución de NTP mostraron una continuación eficiente de la elongación más allá del sitio P:Z, sin estancamiento observable en la siguiente posición.
Quién gana y quién pierde
Los ganadores inmediatos son los biólogos sintéticos que trabajan en sistemas de información genética expandida. El programa AEGIS ha pasado años construyendo pares de bases ortogonales, polimerasas y vías de salvamento de nucleótidos. El par B:S superó las primeras barreras; este trabajo confirma la segunda. Juntos, B:S y P:Z soportan un sistema de transcripción completo de ocho letras en un contexto de polimerasa celular. El siguiente paso, lograr que ese sistema funcione dentro de un organismo vivo a lo largo de múltiples ciclos de replicación y transcripción, sigue sin resolverse, pero la incertidumbre mecanística se ha reducido considerablemente.
La industria biotecnológica también debería estar atenta. Un alfabeto de ocho letras significa una densidad de información exponencialmente mayor por cada cadena de ácido nucleico. Cada letra adicional multiplica la capacidad de codificación. Eso se traduce en aptámeros más complejos, terapias oligonucleotídicas más diversas y potencialmente nuevas clases de proteínas codificadas más allá de los 20 aminoácidos naturales. Las empresas que construyen circuitos génicos sintéticos o medios de almacenamiento de datos de alta densidad encontrarán alentadores los números de fidelidad aquí presentados.
Los perdedores, si hay alguno, son los escépticos que asumieron que la ARN polimerasa mult subunidad demostraría ser una pared más difícil que las enzimas monoméricas. No fue así. El mecanismo del buzo activador es notablemente permisivo cuando la geometría y los enlaces de hidrógeno se conservan, como ocurre en los pares AEGIS.
Qué sigue
Tres preguntas dominan el corto plazo. Primero, ¿puede E. coli importar y regenerar endógenamente los ocho NTP? Los sistemas actuales dependen de suministro exógeno o vías de salvamento modificadas que funcionan para pares individuales. El metabolismo completo de ocho letras no se ha demostrado. Segundo, ¿qué ocurre con la traducción? El par B:S ya se ha utilizado para expandir el léxico de aminoácidos in vitro, pero acoplar la transcripción de ocho letras a la traducción de ocho letras en un solo organismo sigue siendo hipotético. Tercero, ¿cuáles son las tasas de error en transcritos largos? Los ensayos de un solo nucleótido son limpios. La producción de ARNm de longitud completa con múltiples bases no naturales introduce un riesgo acumulativo de errores que este estudio no aborda.
También hay una implicación más silenciosa que vale la pena señalar. La modificación Z* demuestra que los problemas de fidelidad de los alfabetos expandidos suelen ser químicos, no enzimáticos. Pequeños cambios estructurales, una carboxamida por un grupo nitro, un fluoruro por un hidrógeno, pueden resolver los apareamientos erróneos sin requerir nuevas polimerasas ni nueva ingeniería de proteínas. Eso desplaza el cuello de botella de la evolución proteica a la síntesis orgánica, lo cual es un problema más manejable para la mayoría de los laboratorios.
La implicación más amplia es igualmente concreta. Para la búsqueda de vida extraterrestre, este trabajo refuerza la visión de que los sistemas genéticos de cuatro letras no están únicamente restringidos por la física o la química. La vida en otro lugar podría usar plausiblemente un tamaño de alfabeto diferente. El hecho de que la ARN polimerasa de E. coli acomode bases sintéticas con geometría nativa significa que la puerta molecular está abierta. Si la vida en algún lugar eligió pasar por ella es otra cuestión completamente diferente.
Por ahora, el mensaje de este estudio es directo. La ARN polimerasa de E. coli transcribe un alfabeto genético de ocho letras. El mecanismo es familiar. La fidelidad es adecuada y mejorable. La próxima barrera no es la polimerasa.