AI 刚刚设计了一款 CPU,并在其上运行了《毁灭战士》
GPT-5.6 Sol 从零开始构建了一款虚拟 RISC-V 处理器,并成功在上面运行了《毁灭战士》——这标志着从代码生成跨越到硬件设计的重要一步,或将重塑我们对于自主工程的理解。
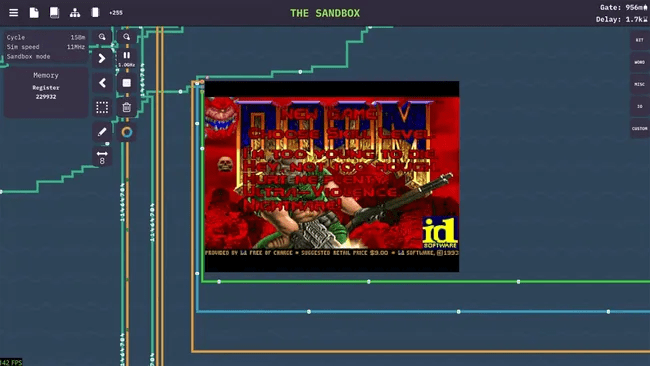
并非真实存在的 CPU,却运行着证明其存在的游戏
OpenAI 的 GPT-5.6 Sol 这次不只是写了代码。它设计了一款虚拟 CPU,接好了逻辑门、寄存器、存储单元和算术逻辑单元,然后在其上成功启动了《毁灭战士》(Doom)。上周,这段演示视频出现在 X 平台上,由 AI 计算研究员兼技术意见领袖 Angel Bogado 记录并分享了整个过程。
这款名为 Codex-R32 的处理器运行在《图灵完备》(Turing Complete)的沙盒环境里——这是一款计算机科普及游戏,玩家从零开始构建处理器。模型按照 RV32IM 指令集格式,生成了一套可运行的 RISC-V 架构。《毁灭战士》通过 PureDOOM 的 C 语言移植版本进行编译,并直接在那款仅以浏览器内逻辑门形态存在的 AI 设计硅片上执行。
这才是关键所在。帧率无关紧要。性能也无所谓。重要的是,模型已经理解到足以构建能执行真实二进制代码的硬件——它搞懂了数字逻辑和处理器架构。
超越代码生成,迈向系统设计
过去两年里,AI 叙事一直由编程助手主导。GitHub Copilot、Claude、Codex……故事千篇一律:AI 写软件比人类更快。这个故事已经讲烂了。如今每个主流模型都能做到。真正有意思的问题在于:接下来会发生什么?
这次演示指向了自主硬件设计。编码和硬件设计根本不是同一个问题。软件生活在抽象的世界里——编译器、运行时环境、虚拟机;而硬件更接近物理约束:时序、功耗、时钟周期、信号传播。要让 CPU 正确运行,AI 就必须推理这些底层约束,而不能把它们抽象掉。
Bogado 的评价一如既往地直白:“这太疯狂了。”一些评论者立刻追问 GPT-5.6 Sol 是否还能运行《孤岛危机》——那个象征系统能力的经典梗图基准测试。模型自身的回答则透着清醒的自我认知——它表示需要造一块 GPU、加上数 GB 内存,再布下大到能从轨道上看到的电路。这是一种建立在诚实技术自知之上的回避。
对半导体行业的意义
直接的影响有限。Codex-R32 无法与 Apple 的 M 系列或 NVIDIA 的架构相提并论。它的《毁灭战士》运行速度根本谈不上流畅。《图灵完备》的沙盒是教育用途,并非生产级工具。真正的 EDA(电子设计自动化)流程涉及综合、布局布线、时序收敛、功耗分析和流片验证——这项演示无一触及。
但方向比单次冲刺的距离更重要。
半导体行业多年来一直在悄然自动化芯片设计的部分环节。Synopsys 和 Cadence 等公司的工具已经能协助进行寄存器传输级设计和验证。这次演示揭示的是:基础模型推理如今已能跨越曾被隔离的领域——自然语言理解与数字逻辑综合交汇了。一个能读规范并产出可工作处理器的 AI,和只会帮你自动补全 Verilog 的 AI 是两类不同的工具。
这不会取代人类芯片架构师。但它降低了原型开发和教育使用的门槛,也指向一个未来:硬件开发的前端——规格定义、架构探索、早期 RTL 生成——将越来越多地由强大模型辅助完成。
意义在于方法论,而非壮观程度
有诸多理由不要过度解读这一刻。模拟环境有着严格限制。该 CPU 没有浮点单元,只具备基础 ALU 操作。没有缓存层级,没有乱序执行,没有现代流水线特性。《毁灭战士》能在其上运行,对概念验证来说已属难得。但这不是能出货的芯片。
然而方法论层面的转变是真实的。早期的 AI 编程演示展示的是模式补全和语法生成能力。这一次,模型必须在多个抽象层级上同时维持状态——既要理解高层程序,也要理解执行该程序的低层门级安排。这是系统思维,而不只是模式匹配。
《图灵完备》沙盒本身也是一种有利于模型的约束。它在已知且简化的架构空间内运作。若要将其推广至完整的芯片设计,则需要处理大得多的歧义、多得多的失败模式,以及沙盒完全忽略的物理现实。
谁赢谁输
赢家很明确:教育平台和所有在主流晶圆厂之外做硬件原型的人。当学生可以请求 AI 演示一套可工作的设计而不仅仅是描述时,《图灵完备》这类工具的价值将大幅提升。专业 FPGA 开发者和 RISC-V 社区建设者也将获得更快速的迭代新工作流。
输家则不那么清晰。单凭这一次演示,没有哪个岗位会消失。但趋势偏向那些能把强大模型整合进设计评审流程的组织。把 AI 当作编程副驾而非设计伙伴的公司,可能会在架构层面首先落后,等到 EDA 工具追赶上来时已为时已晚。
下一步是什么
Bogado 和其他观察家已经指出了下一个显而易见的问题:模型能否设计自己的 GPU?能否扩展到带有流水线阶段、分支预测,甚至简单缓存的处理器?能否产出真正可综合的 RTL,而非仅停留在模拟器层面的描述?
模型自己给出了诚实的回答:它需要更多内存、更多晶体管,以及 presumably 新一轮架构推理。从玩具 CPU 到可用处理器的跃迁很大,但并非不可能——它与“从写简单脚本到构建编译器”的跨度处在同一数量级。
这一刻之所以重要,不是因为 AI 现在能设计硬件了。而是因为 AI 能介入的边界已从代码延伸到了系统层面。行业下一个竞争性问题,不是模型能否生成 RTL,而是它们能否生成通过时序收敛的 RTL。