谷歌RRSI或重塑AI推理经济格局
谷歌发布RRSI框架,AI智能体无需重新训练即可自我优化,在降低超30% Token成本的同时提升基准测试分数。
控制系统才是新的边疆
多年来,AI军备竞赛一直用参数和预训练FLOPs来衡量——更大的模型、更多的数据、更深的训练轮次。但谷歌刚刚发表的一篇论文悄悄暗示:下一轮竞争优势将不再来自训练更聪明的模型,而是来自榨干你已有的那些模型的潜力。
这套框架名为"正则化递归自改进智能体控制系统"(Regularized Recursive Self-Improvement of Agent Harnesses,简称RRSI),由谷歌云AI团队与斯坦福大学、华盛顿大学的研究人员共同开发,于1月29日发布在arXiv上。
核心思想简单得近乎朴素:不更新模型权重,而是迭代优化包裹在模型外围的一切——提示词、工具调用、控制流、记忆管理、技能模块,甚至子智能体的编排。研究者们统称为"控制系统"(harness)。而事实证明,低垂的果实就藏在控制系统里。
RRSI的工作原理
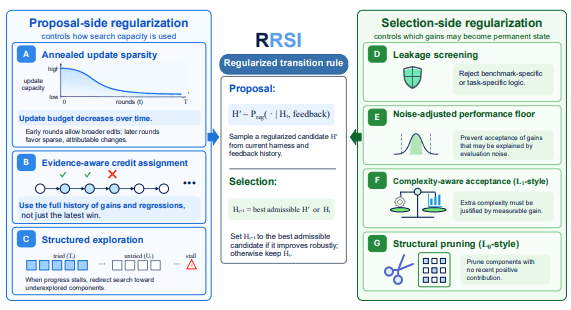
使用RRSI的智能体在每轮迭代中分为两个阶段:提案和筛选。这种双重结构是论文的关键创新。
在提案阶段,智能体会生成针对自身控制系统的修改候选项。但与以往容易陷入重复失败的方法不同,RRSI的提案阶段引入了历史记录,记录已经行不通的方案,从而主动避开死胡同、限制资源消耗。早期迭代提出广泛的、多组件的变更以广泛探索;随着进程推进,逐渐收窄到单组件修改,使研究者能更清晰地识别是哪项具体变更带来了改进。
在筛选阶段,智能体根据实际任务表现对每项提案进行评估。RRSI在此施加了第二层正则化:过滤掉那些在嘈杂评估中看似不错、但相对于其计算成本并未带来实质性提升的修改。正是在这里,效率故事变得引人入胜。
没有这层筛选,智能体往往过拟合——它们会发现能在已知基准测试中刷高分的技巧,却无法提升通用能力。RRSI的双重正则化直接对抗这一问题。论文明确指出,该框架注重分布外鲁棒性:追求的是能跨任务泛化的改进,而非仅仅刷爆某个特定测试套件的技巧。
关键数据
谷歌在八个基准测试上对RRSI进行了验证,一组实验以Gemini 2.5 Flash为基础模型,另一组使用独立模型。
在Terminal-Bench 2.1上,得分从74.2%提升至80.2%,增幅达6.0个百分点。SWE-bench Verified从82.0%升至83.8%。JobBench从36.0%升至40.7%。GDPval从48.8%升至52.3%。Frontier-Eng从17.7%跃升至22.0%。
关键在于,这些改进迁移到了五个RRSI从未直接优化的外部评估集上,最高提升了4.7个百分点。在分布外(OOD)环境中,RRSI比先前所有控制系统演化方法高出多达22.9%——这一显著信号表明,该框架找到的是真正可迁移的改进,而非脆弱的、针对特定任务的投机技巧。
令词经济同样引人注目。在智能体工作空间实验中,单次RRSI运行消耗242万策略令牌,而同等条件下无正则化的控制系统演化方法需380万——减少了超过30%。这意味着RRSI不仅产出更优秀的智能体,而且成本更低。
超越实验室的意义
最直接的影响在于经济层面。如今每条百亿令牌推理管线都在为同一套重模型反复付费,寄望于外围的提示词和工具链调得足够好。RRSI将对更好控制系统的搜索流程化并自动化——同时内置防线,防止企业在自行摸索时犯下两大典型错误:对评估集过拟合,以及为了边际收益烧掉大量令牌。
对于规模化部署AI智能体的企业而言,实际收益清晰可见。你不必等到下一款模型发布才能提升性能。你可以改进围绕现有模型的系统,而且改进是复利的——每次迭代都在已验证的变更基础上推进,而非从零开始。
还有更少被讨论的战略含义。如果控制系统自改进是提升效果的路径,那么竞争护城河将从模型架构转向编排专业能力。最擅长设计、评估和迭代智能体控制系统的公司,可能超越仅拥有最大模型的公司。这是对当前行业叙事的一次深刻翻转。
RRSI无法解决的问题
RRSI是一个研究框架,以Apache 2.0协议开源,尚未成为生产产品。论文在既定基准上展示了收益,但基准测试是受控环境。现实世界中的智能体部署面临杂乱且不断演化的工作量,性能信号更嘈杂,评估标准也更模糊。
双重正则化有所帮助,但该框架仍依赖一个能够生成和评估自身提案的基础模型。这需要推理预算。虽然RRSI相较于无正则化方法减少了令牌消耗,但仍比静态控制系统花费更多。只有当性能收益足以覆盖迭代计算成本时,经济账才算得过来——而这因用例而异。
过拟合问题被缓解,而非消除。任何在修改空间中进行搜索的系统,即便有正则化,仍有风险发现出测试分布外便失效的模式。相比先前方法22.9%的分布外优势值得肯定,但这证明的是方向,而非终点。
更长的弧线
自进化系统自AI诞生之初便是研究目标。RRSI之所以值得关注,正因为它绕开了最难的部分——改变模型本身——转而聚焦于那个同时更具可及性、更具实际影响力的层面。控制系统是AI与现实世界交汇的地方,也是当下大多数部署系统仍未充分优化的地方。
若这一趋势持续,我们或许很快会看到行业分裂为两类:将AI部署视为静态模型调用的公司,与将其视为能自我改进操作程序的自适应系统的公司。随着每一代新模型发布,这两类公司的差距将持续拉大——静态部署者仍在追逐参数规模,而自适应者则在持续累积控制系统的改进。
谷歌的论文本身不足以弥合这一差距。但它提供了一个严谨、开源的框架,用于此前仅靠零散摸索进行的迭代。这对任何在基础模型之上构建智能体系统的公司而言,都改变了游戏规则。
代码已在GitHub上线。接下来,就看谁先跑起来了。