El RRSI de Google podría redefinir la economía de inferencia de IA
Google presentó RRSI, un marco que permite a los agentes de IA mejorarse a sí mismos sin retroentrenamiento, reduciendo los costes de tokens en más del 30 % y aumentando las puntuaciones en benchmarks.
El arnés es la nueva frontera
Durante años, la carrera armamentista de la inteligencia artificial se ha medido en parámetros y FLOPs de preentrenamiento. Modelos más grandes, más datos, entrenamientos más profundos. Pero Google acaba de publicar un artículo que sugiere en voz baja que la próxima ventaja competitiva no vendrá de entrenar modelos más inteligentes: vendrá de exprimir más a los que ya se tienen.
El marco se llama Regularized Recursive Self-Improvement of Agent Harnesses, o RRSI. Fue desarrollado por investigadores de Google Cloud AI junto con equipos de Stanford y la Universidad de Washington, y se publicó en arXiv el 29 de enero.
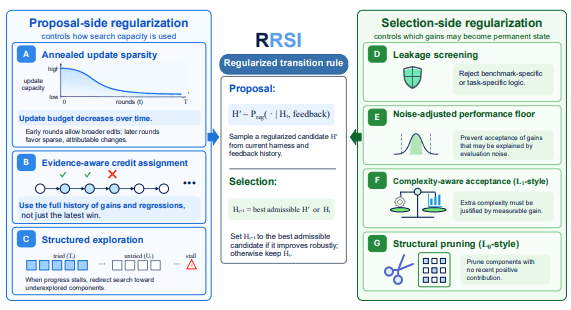
La idea central es engañosamente sencilla. En lugar de actualizar los pesos de un modelo, RRSI mejora iterativamente todo lo que rodea al modelo: los prompts, las llamadas a herramientas, el flujo de control, la gestión de memoria, los módulos de habilidad e incluso la orquestación de subagentes. En conjunto, los investigadores denominan a esto el “arnés”. Y resulta que el arnés es donde está la fruta más baja del árbol.
Cómo funciona RRSI realmente
Un agente de IA que utiliza RRSI opera en dos fases por iteración: propuesta y selección. Esa estructura dual es la innovación crítica del artículo.
En la etapa de propuesta, el agente genera modificaciones candidatas a su propio arnés. Pero a diferencia de enfoques anteriores que podían espiralizar en fracasos repetitivos, la fase de propuesta de RRSI incorpora registros históricos de lo que ya no funcionó, orientando activamente la exploración lejos de callejones sin salida y acotando el uso de recursos. Las primeras iteraciones proponen cambios amplios de múltiples componentes para explorar en profundidad. A medida que el proceso avanza, se estrecha a modificaciones de un solo componente, haciendo más claro qué cambio específico generó cualquier mejora observada.
En la etapa de selección, el agente evalúa cada propuesta contra el rendimiento real en la tarea. Aquí, RRSI aplica una segunda capa de regularización: filtra los cambios que parecen buenos en evaluaciones ruidosas pero no entregan ganancias reales en relación con su costo computacional. Ahí es donde la historia de eficiencia se vuelve interesante.
Sin ese filtro en la etapa de selección, los agentes tienden a sobreajustarse: descubren trucos que maximizan puntajes en benchmarks conocidos sin mejorar la capacidad general. La doble regularización de RRSI combate esto directamente. El artículo señala explícitamente el enfoque del marco en la robustez fuera de distribución: cambios que generalizan a través de tareas, no solo aquellos que optimizan artificialmente un conjunto de pruebas específico.
Los números
Google probó RRSI en ocho benchmarks, usando Gemini 2.5 Flash como modelo base en un conjunto de experimentos y un modelo separado en otro.
En Terminal-Bench 2.1, las puntuaciones pasaron de 74,2% a 80,2%: un salto de 6,0 puntos porcentuales. SWE-bench Verified pasó de 82,0% a 83,8%. JobBench escaló de 36,0% a 40,7%. GDPval pasó de 48,8% a 52,3%. Frontier-Eng saltó de 17,7% a 22,0%.
Lo crucial es que las mejoras se trasladaron a cinco conjuntos de evaluación externos contra los cuales RRSI nunca optimizó directamente, con ganancias de hasta 4,7 puntos porcentuales. Y en entornos fuera de distribución, RRSI superó a métodos previos de evolución de arneses en hasta un 22,9%: una señal contundente de que el marco encuentra mejoras genuinamente transferibles en lugar de arreglos frágiles y específicos de cada tarea.
La economía de tokens también es notable. En experimentos de espacio de trabajo de agentes, una sola ejecución de RRSI consumió 2,42 millones de tokens de política en comparación con 3,8 millones para un enfoque no regularizado de evolución de arneses: una reducción superior al 30%. Esto significa que RRSI no solo produce agentes mejores; los produce más barato.
Por qué esto importa más allá del laboratorio
La implicación inmediata es económica. Cada pipeline de inferencia de mil millones de tokens que se ejecuta hoy paga por el mismo modelo pesado una y otra vez, esperando que el prompt y el equipamiento a su alrededor estén bien ajustados. RRSI formaliza la búsqueda de arneses mejores y la automatiza, y lo hace con salvaguardas integradas contra los dos errores más comunes que cometen las empresas cuando intentan esto de forma informal: sobreajustarse a su conjunto de evaluación y quemar tokens persiguiendo ganancias marginales que no perduran.
Para las empresas que despliegan agentes de IA a escala, la ventaja práctica es clara. No es necesario esperar al próximo lanzamiento de modelo para obtener mejor rendimiento. Se puede mejorar el sistema que rodea al modelo existente, y se puede hacer de una manera que se capitalice: cada iteración se construye sobre cambios validados en lugar de reiniciar desde cero.
También hay una implicación estratégica que se discute menos. Si la auto-mejora del arnés es la vía marginal para mejores resultados, entonces la ventaja competitiva se desplaza desde la arquitectura del modelo hacia la pericia en orquestación. La empresa que mejor entienda cómo diseñar, evaluar e iterar arneses de agentes podría adelantarse a la empresa que simplemente tiene acceso al modelo más grande. Esa es una inversión significativa de la narrativa actual de la industria.
Lo que esto no resuelve
RRSI es un marco de investigación, publicado bajo licencia Apache 2.0. Aún no es un producto de producción. El artículo demuestra ganancias en benchmarks establecidos, pero los benchmarks son entornos controlados. Los despliegues reales de agentes enfrentan cargas de trabajo desordenadas y en evolución, donde las señales de rendimiento son más ruidosas y los criterios de evaluación son menos limpios.
La doble regularización ayuda, pero el marco aún depende de un modelo base capaz de generar y evaluar sus propias propuestas. Eso requiere presupuesto de inferencia, y aunque RRSI reduce el uso de tokens en comparación con enfoques no regularizados, aún gasta más de lo que gastaría un arnés estático. La economía solo mejora a escala si las ganancias de rendimiento superan el costo computacional iterativo, y ese equilibrio variará según cada caso de uso.
El sobreajuste se atenúa pero no se elimina. Cualquier sistema que busque en un espacio de modificaciones corre el riesgo de descubrir patrones que no se mantienen fuera de la distribución de prueba, incluso con regularización. La ventaja del 22,9% fuera de distribución respecto a métodos previos es prometedora, pero demuestra la dirección, no el destino.
El arco más largo
Los sistemas de auto-mejora han sido un objetivo de investigación desde los primeros días de la IA. Lo que hace que RRSI valga la pena observar es que esquiva la parte más difícil —cambiar el modelo mismo— y se enfoca en la capa que es simultáneamente más accesible y más impactante en la práctica. El arnés es donde la IA se encuentra con el mundo real. También es donde la mayoría de los sistemas desplegados están suboptimizados hoy en día.
Si la trayectoria se mantiene, pronto podríamos ver una división en la industria entre empresas que tratan sus despliegues de IA como llamadas estáticas a modelos y aquellas que los tratan como sistemas adaptativos que mejoran sus propios procedimientos de operación. La brecha entre ambos enfoques se ampliará cada vez que salga un nuevo modelo, porque los que despliegan de forma estática seguirán persiguiendo conteos de parámetros mientras los adaptativos seguirán capitalizando mejoras en el arnés.
El artículo de Google no cierra esa brecha por sí solo. Pero proporciona un marco riguroso y abierto para el tipo de iteración que anteriormente era artesanal. Eso cambia el cálculo para cualquiera que construya sistemas de agentes sobre modelos base.
El código está en GitHub. La pregunta es quién empieza a ejecutarlo.