内存正在吞噬 GPU:三星和 SK 海力士正在背叛这场变革
在 Hot Chips 2026 大会上,三星和 SK 海力士发布了截然不同的 HBM 战略——将 HBM 从被动存储元件转变为主动计算单元。这对 NVIDIA、TSMC 以及整个 AI 硬件供应链的影响深远。
内存墙正变得触手可及
几十年来,半导体层级体系泾渭分明。GPU负责计算,内存负责存储。这道边界是架构上的金科玉律,被每一本教科书和每一条产品路线图反复强化。
如今,这道层级正在斯坦福大学土崩瓦解。在Hot Chips 2026大会上,三星和SK海力士这两家韩国存储巨头带来的不是渐进式升级,而是一场哲学层面的断裂:HBM(高带宽内存)不再是被动的组件、等待指令的执行者。它正在成为计算本身的参与者。
原因既残酷又熟悉。GPU性能多年以来一直跑在内存带宽前面。“内存墙”——处理器计算速度与数据供给速度之间的鸿沟——已成为AI训练和推理中最为严峻的瓶颈。每一代更强芯片的推出,都在加剧这一困境,而非缓解它。两家韩国企业如今押注的解决方案不是造更快的GPU,而是让内存更智能、更靠近计算核心。
三星正在重写字底座
三星的方案是两场演示中更为雄心勃勃的一个。三星技术负责人韩相伍(Han Sang-wook)描述了一个三阶段路线图,实质上消解了内存与逻辑之间的边界。
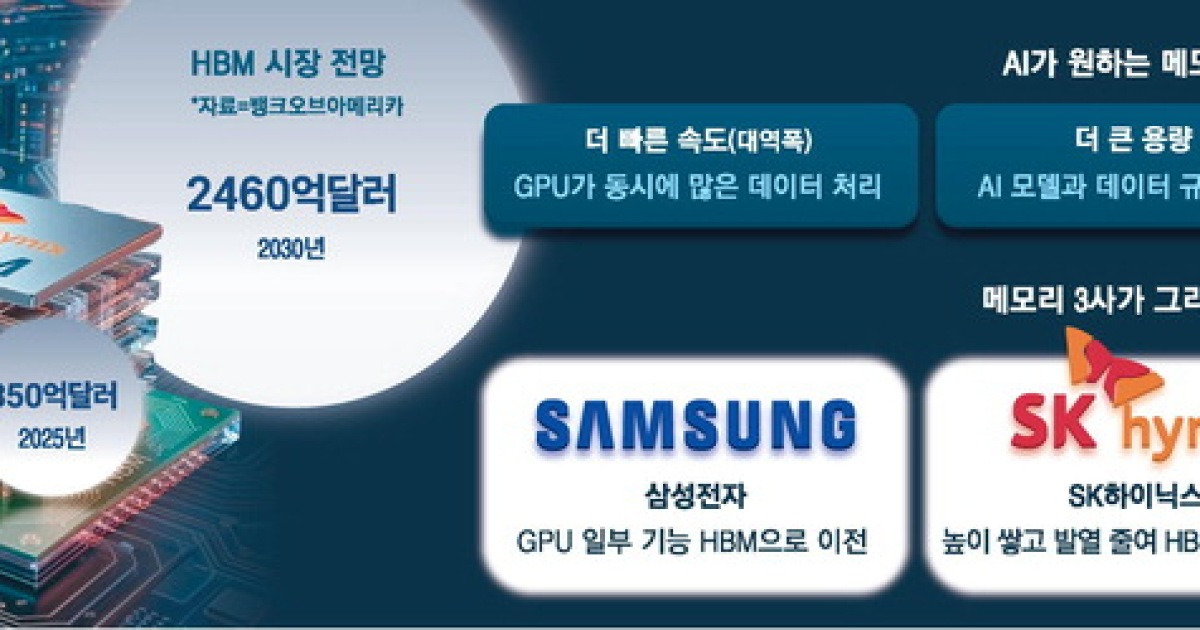
第一阶段瞄准了HBM堆栈中历来最没用的部分——位于底部的字底座(base die),它目前仅充当内存层与外界之间的数据通路。三星计划采用先进逻辑工艺来制造这个字底座——与生产处理器同类的晶圆厂——将其打造成韩相伍所称的"小型大脑"。GPU级别的内存管理功能将迁移至HBM内部,让主GPU完全专注于计算。
第二阶段是zHBM:将这个智能字底座直接堆叠在GPU之上,把内存和处理器融合进同一个物理封装。第三阶段则进一步延伸这种集成。
声称的节能效果令人震惊。三星估计,与即将推出的HBM5标准相比,zHBM可将功耗降低约70%。这不是效率上的微调。在功耗密度已是关键约束的领域,这是数量级上的飞跃。
三星之所以能做到这一点,是因为它是全球极少数同时设计DRAM、自主制造DRAM、并运营前沿代工厂的企业之一——所有环节一厂完成。字底座无需外包。公司可以在内部完成整个架构设计。
这超出三星自身资产负债表的意义。如果HBM从一种标准化元器件转变为可编程基板,定义半导体行业格局的客户关系将发生根本性转移。存储供应商从第一天起就必须与GPU厂商共同设计。NVIDIA、AMD以及英特尔自己的AI部门将不再是在采购零部件;它们将成为系统的共同设计者。
SK海力士选择封装而非架构
SK海力士走了另一条路——这条路被它与几乎所有无晶圆厂公司共有的结构性劣势所塑造:它不掌控先进逻辑制造。SK海力士将其尖端逻辑工作外包给台积电。这意味着它无法像三星那样轻易重构字底座。
取而代之的是,SK海力士押注于它已经最擅长的领域:封装。SK海力士美洲运营副总裁李宰锡(Lee Jae-sik)重点强调了两种技术。第一种是混合键合(hybrid bonding),能够堆叠超过20层DRAM——较目前主流量产的12至16层堆栈大幅提升。第二种是i-HBM,一套定向冷却系统,将制冷精确输送至热量集中区域,而非对整个封装均匀降温。
这一策略务实而精明。SK海力士不重新设计芯片内部架构,而是让现有架构更致密、在热学上更可行。这在工程上相当于建造一座更高、散热更好的楼宇,而非发明一种新的地基。
但局限性同样清晰。SK海力士的方案保留了内存与逻辑之间的传统分隔。它提升了带宽和热效率,却未曾挑战HBM堆栈根本用途这一底层范式。三星的方案——不论其雄心几何——才是真正重新定义类别的那一个。
连买家也开始自己动手设计了
Hot Chips大会上或许最具分量的时刻,与韩国存储厂商毫无关系。Meta与AI芯片初创公司DMatric合作,展示了一款"3D DRAM"原型:定制的DRAM直接堆叠在计算芯片下方,以单一整体式晶圆制造,而非通过传统封装方式组装。
数字令人瞩目。Meta声称该方法将数据搬运功耗降至HBM的六分之一,带宽提升至每秒100TB。其设计哲学与三星如出一辙——缩短数据移动的距离,接受现成内存已远远不够——但行动者的身份截然不同。这一次,主动动手的工程内存架构的,是买方,而非供应商。
Meta、亚马逊、谷歌和微软都开始在自有AI集群中设计定制内存结构——这一信号标志着行业正在发生结构性转变。那种买方填写一个零件编号、然后从任何能交付的供应商处采购的标准化内存市场,正在退潮。对于任何认真追求AI性能的公司而言,定制内存的共同设计已成为默认选项。
问题是资金,而非技术
Objective Analytics的吉姆·汉迪(Jim Handy)在大会上直言不讳:2026年的内存瓶颈不是技术问题,而是资本问题。伴随AI投资热潮,HBM需求激增,但产能并未跟上。价格和供给约束已成为真正的瓶颈,光刻或电路设计并非症结所在。
汉迪的这一诊断暗示,三星与SK海力士之间的竞速,既是创新的较量,也是产能扩张能力的比拼。70%的功耗削减,若无法出货足够数量,便毫无意义。20层堆栈固然令人印象深刻,但若竞争对手以半价、提前六个月交付18层堆栈,这份光环便会黯然失色。
这场竞争的资本密集度正在攀升。三星的路线图要求内存制造与逻辑工艺字底座的同步突破。SK海力士的方案需要精密的键合与冷却基础设施。Meta的定制内存计划则要求其自身具备设计能力并与代工厂深度合作。每个玩家都在向更高的固定成本和更深度的垂直整合迈进。
谁赢谁输,未来何方
眼前的赢家,将是第一个将定制内存AI系统广泛推向市场的公司。三星拥有结构性优势——它能在内部完成一切——但三星的代工业在最新节点上尚无法与台积电抗衡。SK海力士拥有封装领域的领导地位,但逻辑端依赖台积电。双方都无法单方面定义下一代AI硬件的形态。
若这一趋势加速,NVIDIA可能是短期的输家。这家公司的护城河部分建立在控制GPU生态、将内存视为一项需满足的规格而非可设计的变量之上。如果内存成为一种差异化架构而非商品化输入,NVIDIA的捆绑优势将被压缩。该公司必然会做出回应——它一向如此——但博弈的格局已经改变。
台积电处于一个微妙的位置。它是SK海力士逻辑需求和众多AI芯片设计厂商的必选代工厂。但如果三星等存储厂商开始更深入地整合逻辑与内存制造,台积电作为不可或缺中间商的角色将缩小。台积电的CoWoS封装业务受益于当前架构,而内存与逻辑单片化制造的远景同样构成挑战。
韩国企业自身也面临一种或许未被充分认知的风险。内存与逻辑的融合历来是英特尔和三星这类公司的阵地,而双方近年来都未能将垂直整合转化为可持续的竞争优势。集成不等于优化。什么都自己做的公司,同样可能什么都做得很差。
唯一确定的是,即插即用的HBM时代正在落幕。将内存视为设计参数而非采购订单的公司,将定义下一代AI硬件。而那些没有做到的,只会去适配别人设计的架构。