内存正在吞噬GPU——三星和SK海力士的豪赌
在Hot Chips 2026大会上,三星和SK海力士展示了打破内存墙的对立策略:三星将HBM转化为计算单元,而SK海力士选择更高堆叠与更智能的散热方案。最终胜者将主导下一代AI芯片的设计格局。
计算式内存
数十年来,内存一直是AI芯片故事里安静的配角。GPU负责运算;HBM只是把数字存着,等GPU来取。但在斯坦福举行的Hot Chips 2026大会上,这种格局看起来已然过时。
内存论坛——大会首次为其设立独立环节——与其说是一次技术更新,不如说是一场继任公告。三星和SK海力士这两家韩国芯片巨头并肩而坐,给出了针对同一问题的相反答案:内存墙正在吞噬AI的训练和推理,唯一的突围方式是别再把它当作单纯的内存。
三星的打法:让HBM学会思考
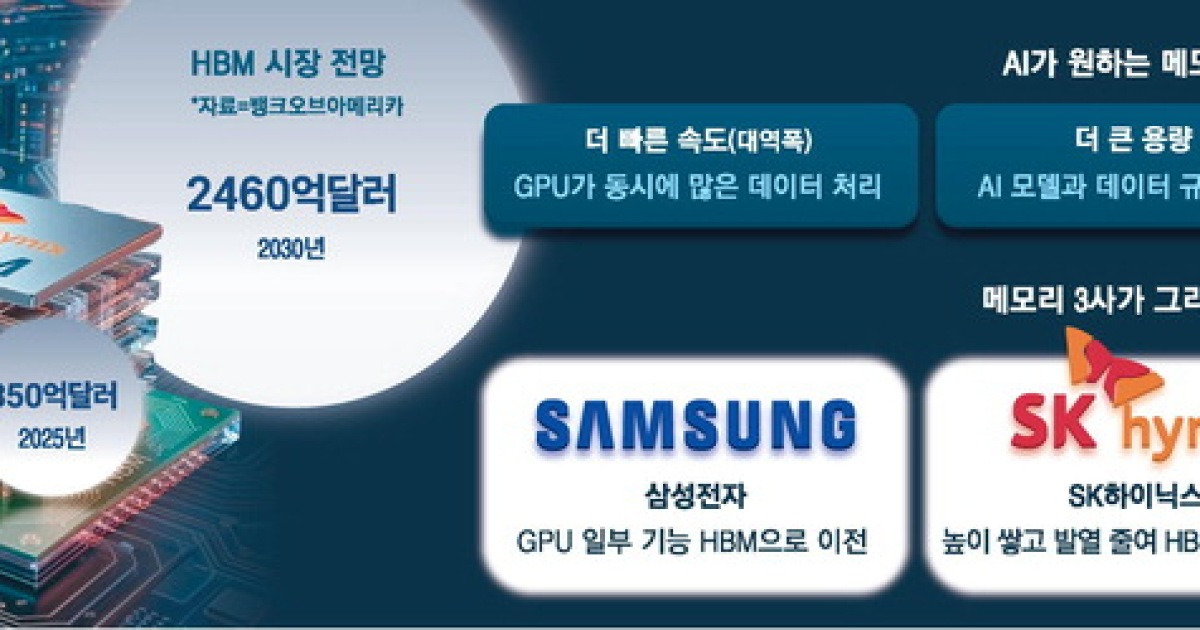
三星的方案更大胆。该公司技术负责人韩相禹(Han Sang-wook)描述了一种思路:将每个HBM堆叠最底层的base die从被动的数据通道改造成基于先进逻辑制程的主动处理单元。说人话:原来只负责路由数据的芯片,现在跑GPU工作负载的一小部分。
这个逻辑很难反驳。GPU擅长数学,却拙于等待。它们越来越多的周期预算消耗在通过HBM搬运数据的管理上,而非执行实际的矩阵乘法。如果内存堆叠能吸收哪怕一小部分数据管理开销,GPU就能更自由地计算,系统完成同样任务消耗的功率也更少。
三星勾勒了一张三步路线图,最终目标是zHBM——一种内存与计算垂直整合的块,GPU和HBM被键合为一个整体。公司宣称,zHBM相比HBM5可降低约70%的功耗。这个数字雄心勃勃,且未经独立验证;它还假设逻辑层能在三星自有晶圆厂的竞争性良率下量产,而这一点仍是变数。
三星之所以敢押注,是因为它拥有完整链条:DRAM设计与制造、逻辑设计,以及自有晶圆厂业务。它能先在纸上画好架构图,再真正把它造出来。
SK海力士的打法:堆得更高,冷得更巧
SK海力士选择了相反的路径。它不是重新设计HBM是什么,而是让HBM更高、更凉。该公司 Americas副总裁李在植(Lee Jae-sik)强调了混合键合技术以堆叠超过20层DRAM,以及i-HBM——一种针对堆叠热点定向冷却的方案,而非对整个系统进行重构。
这是一套以封装为先的策略,并非偶然。SK海力士依赖外部晶圆厂——主要是台积电——来生产其先进逻辑,因此将base die重构为处理器对其而言结构性更难。SK海力士最擅长的,是堆叠和互连工艺。如果取胜之道在于以更紧凑的占地容纳更多带宽并用更好的热管理来支撑,SK海力士的判断是明智的。
这场竞逐正因两条路径 converge 于同一结果而日趋激烈:内存不再是大宗商品,而成为协同设计的系统组件。谁先定义好接口——其HBM与客户GPU之间的接口——谁就掌握下一代AI加速器的主动权。
工程背后的经济逻辑
Objective Analysis的Jim Handy一语道破了经济维度。他指出,2026年的内存瓶颈不是技术问题,而是钱的问题。AI投资推动HBM需求飙升,而晶圆产能未能跟上。价格与供应如今才是约束,而非物理极限。
这改变了战场。当一个组件稀缺时,能提供差异化产品的供应商就拥有更大话语权。标准HBM是一场每Gb价格的逐底竞争。与芯片厂商共同设计的定制内存则是一场系统性能逐顶的竞争——同时也是内存供应商能攫取的利润率逐底的竞争。
Meta在同一届大会上的亮相进一步印证了这一点。Meta与AI芯片初创公司D-Matrix合作,展示了一种3D DRAM概念,将定制DRAM块直接键合在计算芯片下方。其宣称:数据传输距离降至HBM所需的一小部分,数据移动功耗仅为HBM的约六分之一,同时将带宽推至每秒100TB。
一家客户自己在造芯片,对任何内存供应商都不是友好信号。它在告诉三星、SK海力士和美光:仅靠标准产品维系的业务模式已不再安全。
谁赢谁输
短期赢家是任何能锁定HBM供应的AI芯片厂商。产能约束意味着今天的订单要等到六到十二个月后才能交付;延期会引发产品发布的连锁延误。SK海力士已是NVIDIA的HBM主力供应商,拥有 incumbency 优势,三星必须以性能飞跃而非单纯走量来超越。
如果三星的zHBM路线图落地,它将受益。即便70%的功耗降幅只兑现一半,对于以微利运营推理工作负载的云运营商而言也极具吸引力。但三星还必须证明,它能在HBM堆叠底部的逻辑die上达到与晶圆厂客户预期相竞争的良率——当产线组合仍在学习曲线中段时,这是一项艰巨任务。
如果封装和热管理比架构创新更快成为约束,SK海力士将受益。堆叠20层很难;让它们别把自己烤熟更难。i-HBM正瞄准这一难题,而热限制在密集AI机架上已成为真实瓶颈。
更大的输家或许是旧的劳动分工本身。内存曾是周期性可预期的商品业务。系统协同设计则是关系型业务——销售周期更长、客户绑定更深、转换成本带来的忠诚度更高。两家韩国公司正从供应商转变为平台合作伙伴——这也意味着,一旦芯片厂商决定向内求索(正如Meta似乎在做的),它们也更容易被取代。
接下来会发生什么
未来18个月,关注三件事。
第一,三星能否量产一款可工作的base die逻辑原型。发布容易,硅片昂贵。一旦流片并拿出有竞争力的功耗和良率数据,将迫使SK海力士和美光在架构层面响应,而非仅 Dimensionally。
第二,NVIDIA或其他GPU主导厂商是否会采用三星式的集成模块,还是继续坚守模块化HBM堆叠。锚定客户的取舍将设定行业十年的标准。
第三,有多少资本流入HBM专用产能。Handy关于瓶颈是钱而非技术的判断表明,今年的扩产决策将决定直至2028年的供应动态。三星和SK海力士均计划大规模投资;谁先出手、谁最快出手,可能就在需求normalize之前捕获利润窗口。
内存墙不再是个比喻。它是决定哪些AI系统能持续扩展、哪些会停滞的约束。在Hot Chips 2026上,三星和SK海力士明确表态:它们要成为托住这堵墙的人。