Beam: el contragolpe occidental al dominio chino de la IA abierta
El modelo open-weight Beam de Reflection afirma ofrecer rendimiento de codificación y agentes de frontera con una fracción del coste computacional que rivales como GLM 5.2. La pregunta es si estas ganancias de eficiencia bastarán para revertir el impulso de China en el código abierto.
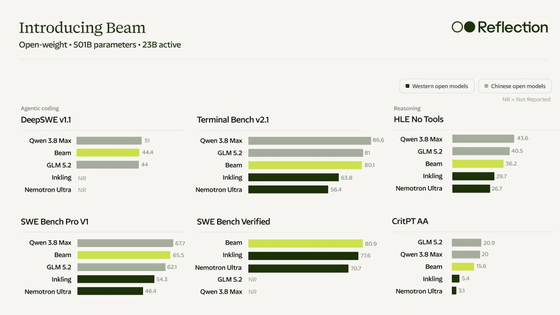
El campo de batalla de los modelos de peso abierto se desplaza, y Beam es una declaración de guerra
Reflection, un laboratorio de inteligencia artificial con sede en San Francisco y con una ronda de financiación de 4.600 millones de dólares por parte de Nvidia, Sequoia y Lightspeed, ha presentado Beam, un modelo de peso abierto de 501 mil millones de parámetros que, según la empresa, iguala las capacidades de codificación y agentes autónomos de GLM 5.2 de China mientras utiliza solo una cuarta parte de la potencia computacional de inferencia.
La afirmación se sitúa en el centro de lo que se ha convertido en el debate definitorio de la inteligencia artificial: quién construye los modelos abiertos más capaces y a qué costo. Los laboratorios chinos han mantenido una ventaja decidida desde que los sorpresivos lanzamientos de DeepSeek a principios de 2025 demostraron que los modelos de vanguardia podían entrenarse por una fracción del precio que las empresas occidentales consideraban necesario. Desde entonces, GLM 5.2, Qwen 3.8-Max y Kimi K3 se han convertido en las opciones predeterminadas para desarrolladores que buscan modelos de peso abierto potentes. Beam es la respuesta de Reflection.
Lo que hace que este anuncio valga la pena observar no es solo otro puntaje en los benchmarks. Es la arquitectura y la estrategia de entrenamiento detrás de él, y lo que sugiere sobre hacia dónde se dirige la carrera de los modelos abiertos.
Un modelo de 23 mil millones de parámetros activos con 501 mil millones de parámetros
Beam utiliza una arquitectura de Mezcla de Expertos (MoE): 501 mil millones de parámetros en total, pero solo alrededor de 23 mil millones se activan por token. Esa distinción importa. Los modelos densos tradicionales activan todos sus parámetros en cada token, y por eso exigen una computación enorme. Los modelos MoE enrutan cada entrada a través de un pequeño subconjunto de sub-redes especializadas denominadas “expertas”, reduciendo drásticamente el costo de inferencia mientras preservan la capacidad.
Reflection afirma que esta arquitectura permite a Beam acercarse a GLM 5.2 en benchmarks como DeepSWE (agentes de codificación), Terminal Bench (tareas agénticas basadas en terminal) y SWE Bench Pro (resolución de problemas a nivel de repositorio), mientras requiere solo una tercera parte o una cuarta parte de la computación de inferencia. Frente a modelos aún más grandes como Qwen 3.8-Max, que supera los 2 billones de parámetros, la brecha de eficiencia es aún mayor.
Beam también reportedly iguala a Qwen 3.8-Max en el rendimiento de tareas agénticas. Esas son comparaciones significativas. GLM 5.2 y Qwen 3.8-Max no son métricas lejanas: son los modelos que los desarrolladores están eligiendo actualmente para cargas de trabajo en producción.
Una de las campañas más grandes de aprendizaje por refuerzo abierto en la historia
La verdadera historia, sin embargo, está en el pipeline de entrenamiento. Reflection entrenó Beam completamente desde cero con 23,8 billones de tokens de datos de preentrenamiento. Pero la cifra más llamativa proviene de la fase de aprendizaje por refuerzo: la compañía ejecutó una de las campañas de RL abiertas más grandes documentadas hasta la fecha, utilizando aproximadamente 15.000 GPUs NVIDIA GB 300 durante cuatro semanas para generar más de 100 millones de rodadas (rollouts).
Que la fase de RL por sí sola consumió ese nivel de computación y aún así produjo ganancias medibles de eficiencia sugiere que la economía de tokens de Beam — la cantidad de capacidad de razonamiento por token generado — ha sido específicamente optimizada. El propio lenguaje de Reflection al respecto es directo: Beam puede ofrecer “mayor inteligencia por token”, lo que significa menores costos operativos para cualquiera que lo implemente a escala.
El pipeline de datos detrás de esto es igualmente notable. Reflection construyó su propio rastreador, pipeline de deduplicación, sistemas de almacenamiento y un sistema OCR que extrajo billones de tokens de cientos de millones de PDFs. El personal técnico del modelo señaló que cuando se unieron al proyecto a finales de 2025, el equipo contaba solo con cinco a diez personas y prácticamente sin infraestructura. Para cuando Beam estuvo listo, habían construido todo internamente. Esa trayectoria —de casi cero a entrenamiento de nivel fronterizo en aproximadamente un año— es en sí misma una señal sobre hacia dónde se mueve la industria de los modelos abiertos.
El equipo detrás de Beam cuenta con credenciales serias
La dirección de Reflection está formada por las personas que configuraron algunos de los sistemas de inteligencia artificial más trascendentales en los últimos años. El CEO Misha Laskin lideró el modelado de recompensas para Gemini de Google y trabajó en AlphaGo y AlphaZero en DeepMind antes de unirse a Google. El CTO Ioannis Zevgolis contribuyó de manera similar a AlphaGo y lideró los esfuerzos de RLHF para Gemini. El personal técnico de la compañía incluye personas que previamente trabajaron en Meta en el desarrollo de modelos de peso abierto.
El marco público que Laskin da a Beam es inusualmente explícito sobre su intención geopolítica. Posicionó la apertura como un imperativo de seguridad y distribución, trazando paralelos entre la criptografía abierta en la década de 1990 y la necesidad de modelos de IA abiertamente inspeccionables. Los inversionistas de la compañía, particularmente Nvidia, que se beneficia del aumento de la adopción de modelos abiertos que impulsa la demanda de chips, claramente comparten esa visión.
Por qué el ángulo de la eficiencia importa más que los números de los benchmarks
Los benchmarks son útiles pero estrechos. La métrica más difícil para cualquier desarrollador es el costo de implementación. Si Beam realmente entrega rendimiento al nivel de GLM 5.2 con una cuarta parte de la computación de inferencia, la economía de ejecutar agentes de IA a escala cambia de manera notable. Una empresa que despliegue miles de agentes de codificación o asistentes autónomos de investigación vería reducciones de costos significativas.
Ese es también el motivo por el que la comparación con Kimi K3 importa. Beam reportedly aún queda rezagado respecto a Kimi K3 en benchmarks de capacidad pura. Pero la brecha se enmarca en torno a la eficiencia, no a la habilidad cruda. En el mercado de modelos abiertos, esa distinción es cada vez donde reside la ventaja competitiva. La capacidad converge rápidamente. La eficiencia es más difícil de replicar.
Qué significa esto para el ecosistema de IA abierta
Beam llega en un momento en el que el panorama de la IA de código abierto se consolida en torno a dos campos: modelos chinos construidos para máxima capacidad y eficiencia, y modelos occidentales que corren para igualarlos. El soporte inmediato de Ollama para Beam señala que el ecosistema occidental de modelos abiertos se está cohesionando alrededor de compañías que pueden ofrecer un rendimiento comparable a costos competitivos.
El cronograma de lanzamiento — pesos completos con licencia Apache 2.0 y un informe técnico detallado esperado a finales de octubre de 2026 — será la verdadera prueba. Reflection se encuentra actualmente sometida a pruebas de penetración y evaluación de seguridad. Si el lanzamiento abierto de Beam resiste el escrutinio y funciona según lo afirmado en entornos de producción, podría redistribuir significativamente el mercado de modelos abiertos. Si decepciona, la brecha entre los modelos abiertos occidentales y chinos se ampliará aún más.
Por ahora, Beam representa el desafío occidental más serio hasta la fecha al dominio de China en la IA de código abierto. Su ventaja competitiva no es solo la arquitectura o la escala de entrenamiento, sino la afirmación de que ya no se necesitan billones de parámetros para competir. Ese es un mensaje que toda la comunidad de IA abierta ha estado esperando escuchar.