Beam:西方反击中国开源AI霸权的王牌
Reflection的501B开源模型Beam宣称以更低算力成本实现前沿编码和智能体性能,但效率提升能否扭转中国在开源领域的势头仍是悬念。
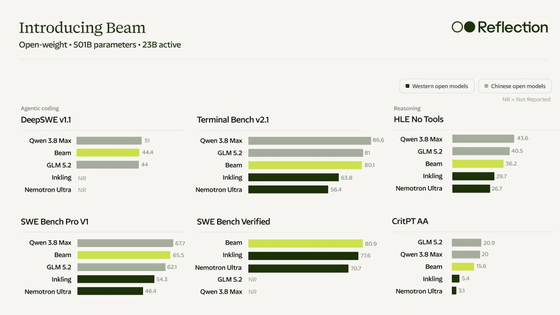
开放权重战场格局正在改写,Beam是一次宣战
Reflection这家总部位于旧金山的AI实验室已获得英伟达、红杉和Lightspeed累计46亿美元投资,近日发布了Beam——一款5010亿参数的开放权重模型。该公司声称,Beam的代码编写与智能体能力可与中国的GLM 5.2相匹敌,而推理算力消耗仅为后者的四分之一。
这一宣称精准命中了当下人工智能领域最具决定性意义的竞争:谁能构建出最强大的开放模型,以及以何种成本代价。自2025年初DeepSeek的意外发布证明了前沿级模型完全可以以远低于西方公司预期的成本进行训练以来,中国实验室便已确立了显著优势。GLM 5.2、Qwen 3.8-Max和Kimi K3随之成为寻求强大开放权重模型的开发者的默认选择。Beam,正是Reflection给出的答案。
这份公告值得关注的理由,并不在于又一份基准测试分数,而在于其背后的架构设计与训练策略——以及它所暗示的开放模型竞赛下一阶段的走向。
230亿激活参数的5010亿参数模型
Beam采用了混合专家(MoE)架构:总计5010亿参数,但每个token仅激活约230亿。这一差异至关重要。传统密集模型会在每一个token上激活所有参数,这也是它们需要海量算力的原因。MoE模型则通过路由机制,将每次输入分发到少量专门的"专家"子网络中,在保持模型容量的同时大幅降低推理成本。
Reflection声称,凭借这种架构,Beam在DeepSWE(编码智能体)、Terminal Bench(基于终端的智能体任务)和SWE Bench Pro(仓库级问题解决)等基准测试上可接近GLM 5.2的表现,而所需的推理算力仅为后者的三分之一至四分之一。面对参数量超过2万亿的更大模型如Qwen 3.8-Max,效率差距更为悬殊。
据报道,Beam在智能体任务表现上也能与Qwen 3.8-Max持平。这些是比较有意义的参照——GLM 5.2和Qwen 3.8-Max并非遥不可及的测试标杆,而是开发者当前在生产环境中实际选择的模型。
史上规模最大的开放强化学习训练之一
然而真正的故事在于训练流程。Reflection完全从零开始,在23.8万亿token的预训练数据上训练了Beam。但更引人注目的数据来自强化学习阶段:该公司运行了有据可查的规模最大的开放RL项目之一,在四周时间内动用约15000块英伟达GB 300 GPU,生成了超过1亿次的rollout。
仅强化学习阶段就消耗如此规模的算力,且仍然产生了可衡量的效率提升,这说明Beam的"token经济"——即每个token所承载的推理能力——已经过专门优化。Reflection对此的表述同样直白:Beam能够以更低的成本交付"更高的每token智能",意味着任何大规模部署它的企业都将显著降低运营成本。
支撑这一切的数据流水线同样值得注意:Reflection自建了爬虫、去重流水线、存储系统,以及能够从数亿份PDF中提取数万亿token的OCR系统。据该项目技术人员透露,2025年底他们加入时,团队仅有五至十人,几乎没有任何基础设施。到Beam即将成型之际,一切均已自主完成。从近乎为零到达到前沿级别训练水平,仅用约一年时间——这一轨迹本身便是开放模型产业走向的一个信号。
Beam背后的团队履历过硬
Reflection的领导层由近年来塑造了若干最重要AI系统的核心人物组成。首席执行官Misha Laskin曾在Google负责Gemini的奖励建模工作,此前在DeepMind参与了AlphaGo和AlphaZero项目。首席技术官Ioannis Zevgolis同样参与了AlphaGo的开发,并领导了Gemini的RLHF工作。公司技术团队中还包括曾在Meta从事开放权重模型开发的人员。
Laskin对Beam的公开阐述,就其地缘政治意图而言极为明确。他将开放性定位为安全与分发上的迫切需求,将1990年代的开放密码学与需要公开可审查的AI模型进行类比。公司的投资者——尤其是英伟达,后者从开放模型采用率的提升所驱动的芯片需求中直接受益——显然与这一愿景高度一致。
为何效率角度的意义超越基准分数
基准测试有用,但视野狭窄。对任何开发者而言更难衡量的指标是部署成本。如果Beam确实在仅为GLM 5.2四分之一的推理算力下达到同等性能,那么大规模运行AI智能体的经济账将发生显著变化。一家部署数千个编码智能体或自主研究助理的公司,将看到实实在在的成本下降。
这也正是与Kimi K3的比较为何重要。据报道,Beam在纯能力基准测试上仍落后于Kimi K3。但差距的描述框架围绕的是效率,而非绝对能力。在开放模型市场中,竞争力正日益向这个方向集中。能力会快速收敛,而效率则更难复制。
这对开放AI生态意味着什么
Beam面世之时,开源AI格局正凝聚为两大阵营:一类是以最大能力和效率为目标构建的中国模型,另一类是奋力追赶的西方模型。Ollama对Beam的即时支持表明,西方开放模型生态正在围绕那些能够以有竞争力的成本提供可比性能的公司整合。
发布时间线——完整的Apache 2.0权重和详细技术报告预计于2026年10月下旬公布——才是真正的考验。Reflection目前正在接受红队测试和安全评估。如果Beam的开放发布经得住 scrutiny,并在生产环境中按预期表现,它将实质性重分配开放模型市场格局。如果表现不及预期,西方与中国开放模型之间的差距将进一步扩大。
目前而言,Beam代表了迄今为止对中国开放AI主导地位最严肃的西方挑战。它的护城河不仅仅在于架构或训练规模——更在于这样一个主张:你不再需要数以千万亿计的参数量才能参与竞争。这是整个开放AI社区一直在等待听到的声音。