Corea del Sur acelera HBM4E mientras China reduce brecha DRAM
CXMT de China cierra la brecha tecnológica en DRAM, desatando una carrera urgente por HBM4E entre Samsung y SK Hynix que redefine las cadenas de suministro de memoria para IA.
La brecha de DRAM se cierra — y los gigantes coreanos de la memoria entran en pánico
El fabricante estatal chino de chips de memoria CXMT ha dejado de ser una amenaza teórica lejana para empezar a moverse a la velocidad que realmente importa. En la conferencia de semiconductores SEDEX 2026, celebrada la semana pasada en Seúl, el principal ejecutivo tecnológico de Samsung confirmó algo que debería inquietar a cada planificador de infraestructura de IA en Silicon Valley: la empresa está desarrollando su propia arquitectura revolucionaria de DRAM, conocida como 4F², y “trabajando duro” en ello.
La cronología es la clave. CXMT ha señalado públicamente que implementará 4F² —una técnica de reducción del tamaño de celda que empaqueta más celdas de memoria en la misma superficie de silicio que el diseño estándar 6F²— en DRAM para servidores de nueva generación antes de que termine el año. Samsung ya había demostrado en febrero un chip de prueba de 16 gigabits con 4F², según documentos presentados en la International Solid-State Circuits Conference. La pregunta ya no es si alguna de las dos firmas puede construir la tecnología, sino quién la comercializará primero a gran escala y a qué precio.
Por qué HBM4E es el verdadero campo de batalla
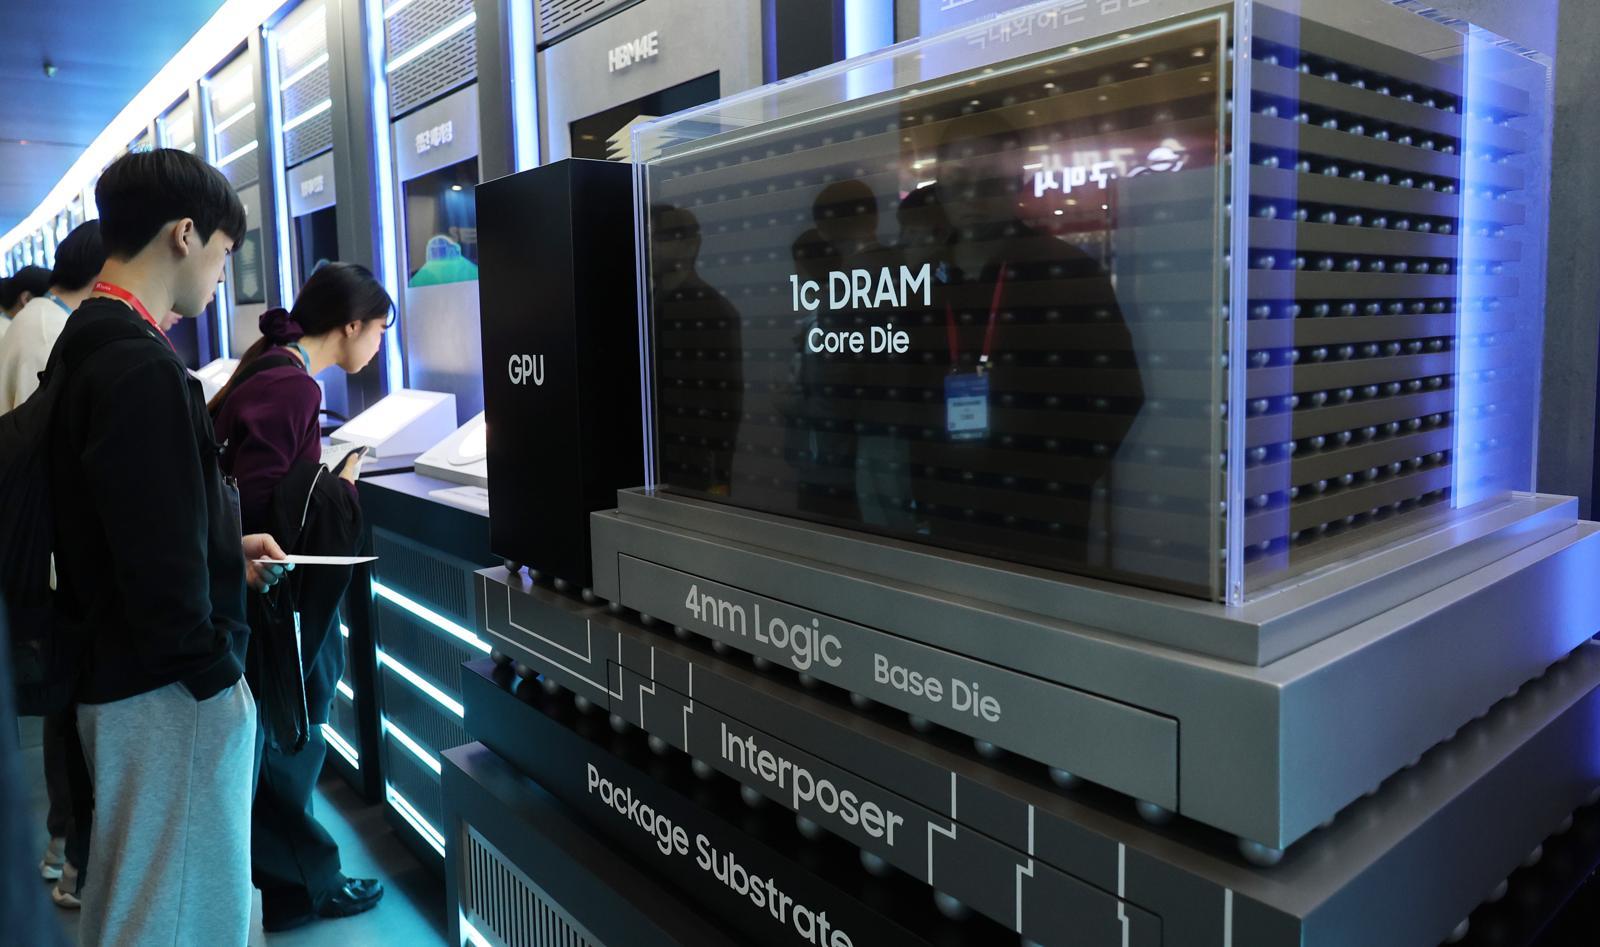
La memoria de alto ancho de banda es donde se libra la guerra de la IA en este momento. Cada generación de modelos de lenguaje grandes demanda más ancho de banda de memoria, y la HBM —la DRAM apilada que se sitúa directamente junto a los chips de entrenamiento de IA— es el cuello de botella que determina qué tan rápido funcionan esos modelos. Samsung y SK Hynix se han adelantado en la séptima generación, ambos presentaron muestras de HBM4E en SEDEX. Samsung envió su muestra de 12 capas a un cliente en mayo, mientras que SK Hynix afirma haber completado su propia tanda de muestras y apunta a la producción en volumen el próximo año.
Las apuestas son enormes. Los analistas estiman que para 2030 la capacidad total de cómputo de la infraestructura de IA será aproximadamente veinte veces lo que es hoy, según el propio director de desarrollo de SK Hynix, Ahn Hyun. Pero el problema no es solo el cómputo en bruto. A medida que los modelos de IA se vuelven más profundos y complejos, el costo de mover datos entre capas de memoria —HBM, DRAM convencional y unidades de estado sólido— crea nuevos cuellos de botella de energía y rendimiento que no pueden resolverse únicamente haciendo chips más rápidos.
La estrategia de apilamiento: una apuesta por 3D
Ambas compañías coreanas están apostando su supervivencia a un solo movimiento arquitectónico: colocar la memoria directamente sobre el procesador en lugar de junto a él. Samsung llamó a este enfoque zHBM. SK Hynix persigue un concepto paralelo en el que está colaborando con Sandisk para estandarizar, junto con una nueva categoría de memoria llamada high-bandwidth flash (HBF). La idea es emplear técnicas de apilamiento 3D al estilo HBM y transferencia de datos ultrarrápida sobre NAND flash, apuntando a un producto que ofrezca aproximadamente la mitad del ancho de banda de la generación actual de HBM pero diez veces la capacidad.
Ahn dijo que el estándar formal de HBF se espera para enero, lo que consolidaría una ventaja competitiva para cualquier empresa que haya ayudado a escribir las reglas. Samsung también mostró en la feria una pila multinivel de NAND llamada zNAND-O, diseñada para extraer datos de IA con mayor rapidez en smartphones y otros dispositivos de borde.
La lógica es sólida, pero la ejecución es la parte difícil. Apilar memoria sobre chips de lógica requiere ingeniería de precisión en la intersección de dos procesos de fabricación muy distintos. Justo ahí es donde se ha estancado el追赶 de China —y donde Elon Musk lo burló públicamente. Publicando en X, Musk advirtió que desarrollar estructuras apiladas que puedan mantener estabilidad térmica en semiconductores de lógica “no es fácil”, insinuando que el camino de CXMT hacia HBM avanzada sería significativamente más difícil que su camino hacia DRAM de commodity.
Musk fue más tajante al hablar de precios. Se quejó de que los precios de memoria próximos de Micron eran razonables mientras que “otros vendedores” cobraban cantidades absurdas —un punteo inequívoco contra las firmas coreanas sin nombrarlas—. “Los clientes de hoy no lo olvidarán”, agregó. El comentario señala una fractura creciente entre los compradores de chips de IA que dependen de la memoria coreana y los compradores que buscan apalancamiento para forzar la baja de precios.
Quién gana, quién pierde
CXMT es el disruptor evidente. Incluso si va una o dos generaciones por detrás de Samsung y SK Hynix en HBM de última generación, una alternativa creíble de DRAM en el nodo 4F² cambia la economía para todos. Empresas de IA chinas como Baidu, ByteDance y Alibaba, que se han visto forzadas a depender de Samsung y SK Hynix para sus necesidades de memoria, de pronto tienen una alternativa nacional. Esa alternativa puede no ser la más rápida, pero reduce el riesgo geopolítico que ha acechado cada gran construcción de infraestructura de IA en los últimos tres años.
Para Samsung y SK Hynix, la pérdida no es un ingreso inmediato sino poder de fijación de precios. HBM ha sido uno de los pocos puntos brillantes en un mercado de memoria implacable. Si CXMT logra capturar incluso una fracción de la demanda china que actualmente fluye a Corea, la prima sobre HBM4E se suavizará —y cada gigabyte de pérdida de margen se acumula cuando operas una industria intensiva en capital al límite de lo físicamente posible.
El mayor perdedor podría ser Estados Unidos, que ha gastado miles de millones intentando impedir que China logre la autosuficiencia semiconductora. El avance de CXMT en 4F² demuestra que los controles de exportación y las prohibiciones de equipo han ralentizado, pero no detenido, la persecución de la memoria de vanguardia. Los legisladores estadounidenses veremos con mucha menor tranquilidad los anuncios de SEDEX de lo que probablemente hicieron los funcionarios coreanos.
Qué sigue
Los próximos seis meses determinarán la forma del mercado de memoria para IA hasta 2027. Samsung y SK Hynix corren para convertir las muestras de HBM4E en producción en volumen. CXMT corre para validar su DRAM 4F² en diseños de servidores. Y los clientes estadounidenses corren para hacer pedidos antes de que cualquiera de lo anterior derrumbe su posición de negociación.
El esfuerzo de estandarización de HBF, liderado por SK Hynix y Sandisk, podría convertirse en el eje silencioso. Si aterriza en enero como está previsto, podría definir una nueva capa de memoria que se ubique entre HBM y NAND convencional —una lo suficientemente barata para despliegue masivo pero lo suficientemente rápida para IA de borde. Los enfoques competidores de Samsung sugieren que no cederá ese espacio sin luchar.
Mientras tanto, la credibilidad de CXMT sigue creciendo. No necesita superar a Samsung en HBM para cambiar el juego. Solo necesita hacer sentir a los constructores de IA chinos lo suficientemente confiados como para diversificar su suministro de memoria fuera de Corea, y toda la cadena de suministro se recalibrará alrededor de un nuevo centro de gravedad.
La carrera ya no se trata de quién puede construir el chip más rápido. Se trata de quién puede construir suficientes de ellos, a un precio que sus clientes acepten, antes de que la política supere a la física.